Paperis 아티클
AI 추론 시험 — 스도쿠 점수는 무엇을 재고 있었나
1980년대 홉필드·탱크의 에너지를 학습형으로 바꾼 CRAM은, 저자들이 잰 바로 어려운 스도쿠와 미로에서 반복 모델보다 적어도 1,000배 빨리 학습했고, 스도쿠에서는 반복 모델의 최고 정확도를 적어도 282배 적은 계산으로 맞췄다. 학습된 숫자에는 스도쿠 규칙이 그대로 적혀 있었고, 손으로 적은 숫자 하나짜리 에너지가 시험 퍼즐을 다 풀었다. 저자들의 결론은 에너지가 유망하다는 것과, 이렇게 쉽게 풀리는 퍼즐로 반복 추론의 확장성을 재지 말라는 것. 심사 전 프리프린트이고, 저자들은 ARC 같은 더 어려운 과제는 이 단순한 에너지만으로 배우기 어려울 것이라고 본다(ARC는 시험하지 않았다).
AI 추론 시험 — 스도쿠 점수는 무엇을 재고 있었나
스도쿠를 푸는 작은 모델들
2025년에 심사 전 원고로 공개된 한 논문은 파라미터 2,700만 개짜리 모델이 훈련 예시 1,000개만 보고 어려운 스도쿠와 큰 미로의 최단 경로 찾기에서 거의 완벽한 성능을 냈다고 보고했습니다. 이름은 계층적 추론 모델(Hierarchical Reasoning Model, HRM)이고, 느리게 큰 계획을 맡는 부분과 빠르게 세부 계산을 맡는 부분이 서로 주고받으며 계산을 되풀이하는 구조입니다 (arXiv:2506.21734). 파라미터는 모델 안에서 학습으로 정해지는 숫자들로, 모델이 입력을 어떻게 계산해 답을 내는지가 이 숫자들로 정해집니다. 2,700만 개는 대화형 AI를 움직이는 큰 언어 모델에 견주면 아주 작은 크기입니다.
몇 달 뒤 나온 TRM(Tiny Recursive Model)은 이 구조를 층 두 개짜리 작은 신경망 하나로 줄였습니다. TRM의 저자는 파라미터 700만 개로 ARC-AGI-1에서 45%, ARC-AGI-2에서 8%를 맞혀, 파라미터가 0.01%도 안 되면서 대부분의 큰 언어 모델보다 높았다고 보고했습니다 (arXiv:2510.04871). ARC는 사람이 타고나는 것에 가까운 기초 지식만으로 풀도록 만든 추상 퍼즐 묶음으로, 기계의 일반적인 문제 해결 능력을 재려고 만들어졌습니다 (arXiv:1911.01547).
두 모델은 한 갈래에 속합니다. 반복 모델(looped model)은 같은 층이나 층 묶음을 여러 번 되풀이해 적용해서 답을 만들어 내는 모델입니다. 파라미터 수백만 개 규모의 작은 반복 모델이 스도쿠와 미로에서 거둔 성공은 추론을 다루는 하나의 흐름이 되었습니다 (arXiv:2611.17309). 이 논문이 그런 성공의 예로 꼽은 무대는 어려운 9×9 스도쿠를 모은 Sudoku-Extreme과, 30×30 미로에서 두 끝점 사이의 유일한 길을 찾는 Maze-Unique였습니다. HRM이 처음 보고한 미로는 고리가 있는 더 어려운 묶음 Maze-Hard였습니다 (arXiv:2611.17309). 셋 다 벤치마크입니다. 벤치마크는 여러 AI 모델에게 같은 문제를 풀게 해 점수를 견주도록 만들어 둔 시험 문제 모음으로, 대개 공개되어 있습니다.
다만 왜 잘 푸는지는 분명하지 않았습니다 (arXiv:2611.17309). HRM을 뜯어본 한 분석(심사 전 원고)은 HRM이 빈칸이 하나뿐인 쉬운 퍼즐에서도 틀릴 수 있고, 계산을 되풀이해도 더는 바뀌지 않는 첫 번째 상태를 답으로 「찍고」 거기 갇히기도 한다고 보고했습니다. 그 저자들은 HRM이 「추론」하기보다 「추측」하는 것처럼 보인다고 적었고, 이 「추측」을 여러 번 하게 만드는 보강으로 HRM의 Sudoku-Extreme 정답률을 54.5%에서 96.9%로 올렸다고 보고했습니다 (arXiv:2601.10679). 점수는 높은데 그 점수가 무엇을 뜻하는지가 열려 있었다는 뜻입니다.
2026년 11월 12일, 영국 런던의 Prefrontal 소속 연구자 벤저민 후버, 휴 블레이니, 제임스 휘팅턴이 이 퍼즐들에 다른 답을 내놓았습니다. 에너지 함수(energy function)는 가능한 답안 하나하나에 숫자 하나를 매겨, 바람직한 답일수록 낮은 값을 주도록 만든 함수입니다. 제목은 「고전적 에너지가 반복 모델보다 1,000배 빨리 추론을 배운다」입니다. 프리프린트는 동료 연구자의 심사를 거치기 전에 먼저 공개한 논문 원고입니다. 이 논문은 나온 지 1주일 된 프리프린트 한 편이고, 아래 수치는 모두 저자들이 이 퍼즐들에서 직접 잰 값입니다.
저자들이 잰 바로는, 1980년대 홉필드와 탱크가 손으로 짠 에너지 함수를 학습할 수 있게 바꾼 CRAM이 GPU 한 장에서 42밀리초 학습한 뒤 Sudoku-Extreme 시험 퍼즐의 99.996%를, 132밀리초 학습한 뒤 Maze-Unique 시험 미로의 100%를 풀었습니다. 학습 시간은 반복 모델보다 적어도 1,000배 짧았고, Sudoku-Extreme에서 반복 모델이 가장 정확할 때와 같은 정확도를 푸는 데 드는 계산을 적어도 282배 적게 써서 맞췄습니다 (arXiv:2611.17309). 저자들이 이 결과에서 끌어낸 결론은 두 가지입니다. 에너지가 데이터로부터 추론을 학습시키는 방향으로 매우 유망하다는 것, 그리고 스도쿠와 미로처럼 쉽게 풀리는 벤치마크로 반복 추론 기법이 더 큰 문제로 커질 수 있는지를 시험하지 말라는 경고입니다 (arXiv:2611.17309).
1985년의 골짜기
1985년 미국 물리학자 존 홉필드와 데이비드 탱크는 외판원 문제, 곧 여러 도시를 한 번씩 들르는 가장 짧은 길을 찾는 문제를 신경망으로 푸는 방법을 발표했습니다. 풀 문제를 「제약 아래에서 가장 좋은 값을 찾는 꼴」로 바꿔 적으면, 서로 촘촘히 이어진 단위들이 함께 계산해 좋은 답을 금세 내놓는다는 내용이었습니다 (PMID 4027280). 연결의 세기는 사람이 손으로 정했습니다 (arXiv:2611.17309).
그 바탕은 홉필드가 1982년에 내놓은 신경망입니다 (PMID 6953413). 홉필드 네트워크(Hopfield network)는 기억의 일부만 주어져도 나머지를 채워 전체를 되살려 내도록 단위들을 서로 이어 놓은 신경망입니다. 홉필드는 2024년 노벨 물리학상을 제프리 힌턴과 함께 받았습니다.
이 계열의 신경망이 답을 찾는 방식은 「에너지를 낮추는 일」로 적을 수 있습니다 (arXiv:2611.17309). 답안마다의 에너지를 땅의 높이로 그려 보면, 가능한 답안은 지형 위의 한 지점이고 좋은 답일수록 낮은 곳에 있습니다. 공을 놓으면 굴러 내려가 골짜기 바닥에 멈춥니다. 신경망이 계산을 한 번 되풀이할 때마다 공이 한 걸음 내려갑니다. 반복 계산의 한 단계가 에너지를 낮추는 한 단계에 해당합니다 (arXiv:2611.17309).
스도쿠는 이 그림에 잘 맞는 문제입니다. 제약 퍼즐(constraint puzzle)은 지켜야 할 규칙이 미리 정해져 있고, 그 규칙을 모두 한꺼번에 지키는 배치를 찾으면 풀리는 퍼즐입니다. 스도쿠처럼 제약으로 이루어진 퍼즐에는 가장 낮게 내려가면 퍼즐이 풀리는 에너지가 있다는 것이 이미 알려져 있었고, 홉필드는 뒤에 스도쿠에도 손으로 짠 에너지를 적용했습니다 (arXiv:2611.17309).
스도쿠의 규칙을 에너지에 담는 방법은 단순합니다. 이 논문이 손으로 적은 스도쿠 에너지는 같은 행이나 같은 열, 같은 3×3 칸에 놓인 두 칸이 같은 숫자를 가질 때마다 같은 크기의 벌점을 하나씩 매깁니다. 그 밖의 칸 쌍에는 벌점이 없습니다 (arXiv:2611.17309). 지형으로 말하면, 같은 줄에 같은 숫자가 많이 겹친 판일수록 높은 곳에 있고, 규칙을 하나도 어기지 않은 판이 가장 낮은 바닥에 있습니다.
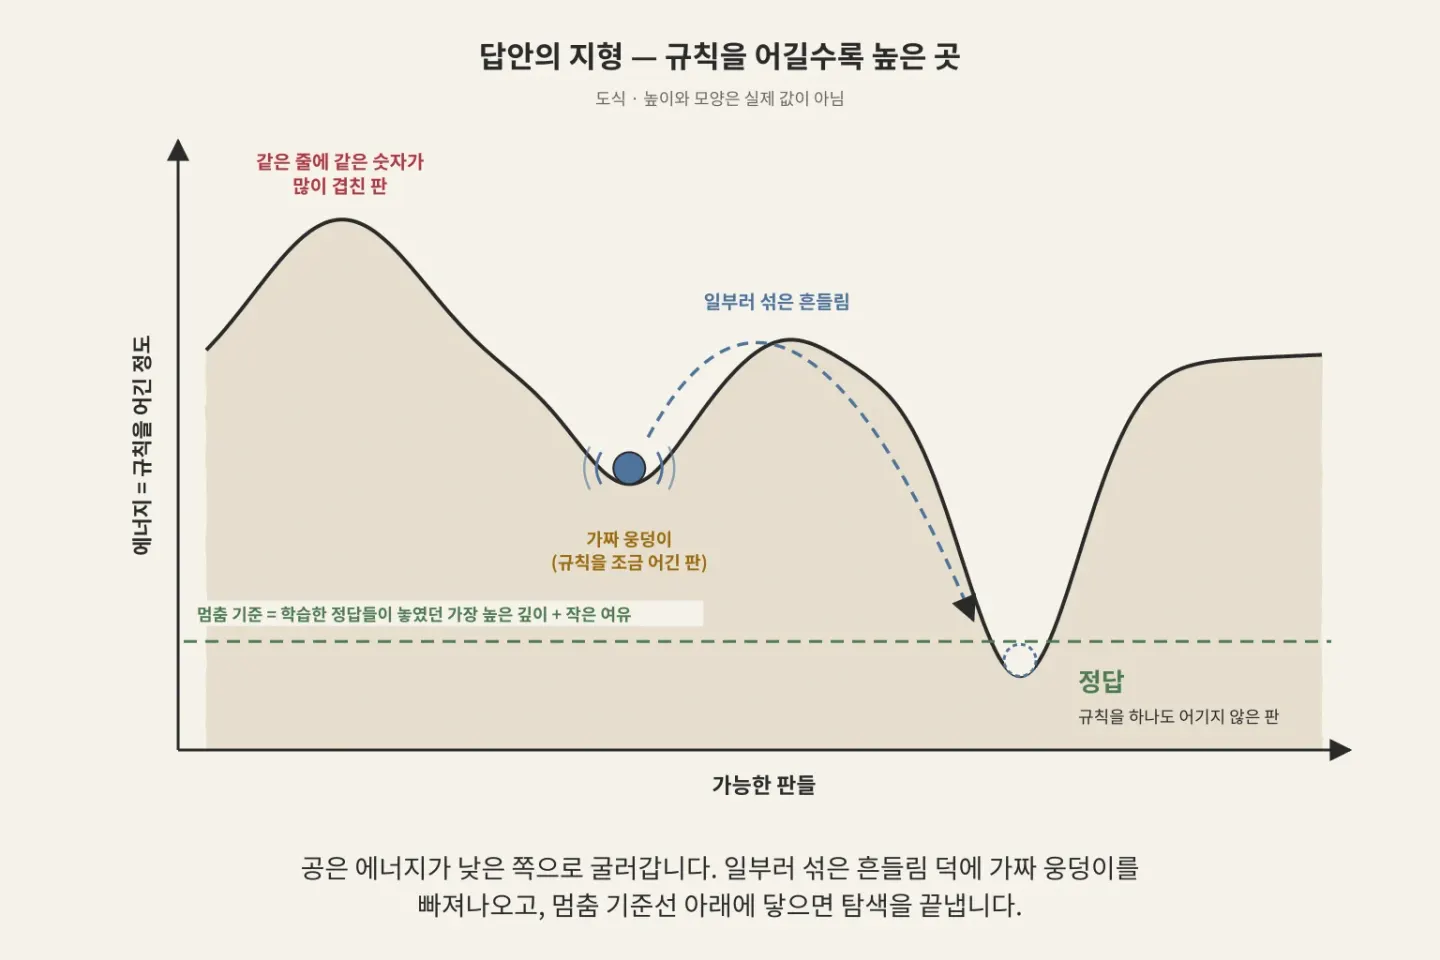
그림: Paperis가 본문 내용만으로 그린 도식
CRAM은 이 벌점을 사람이 정하지 않고 풀린 퍼즐에서 배우게 만든 것입니다. 이름은 「작은 추론 연상 기억(Compact Reasoning Associative Memory)」의 머리글자입니다. CRAM의 에너지는 칸 하나에 매기는 값과 칸 둘의 짝마다 매기는 값을 모두 더한 꼴이고, 그 값들이 학습으로 정해지는 파라미터입니다. 저자들은 홉필드 네트워크처럼 CRAM의 가중치가 「함께 놓여도 되는 칸의 짝」을 기억하고, 에너지를 내려가는 일이 단서만 주어진 퍼즐, 곧 일부가 지워진 그림을 채워 완성하는 일에 해당한다고 설명합니다 (arXiv:2611.17309). 1982년의 기억 신경망이 하던 「일부에서 전체를 되살리기」가 스도쿠에서는 단서로 나머지 칸을 채우는 일이 됩니다.
골짜기를 파는 학습
반복 모델은 되풀이한 계산을 거꾸로 거슬러 올라가며 배웁니다. 마지막 답이 틀린 만큼을 계산의 앞 단계들로 되돌려 보내 파라미터를 고치는 방식입니다. 계산이 길어 대개 마지막 몇 단계만 거슬러 오르는데, 저자들은 이 방식이 반복 모델의 학습이 느린 이유 가운데 하나라고 적었습니다. 저자들의 표현으로 반복 모델은 불안정할 수 있고, 학습이 느리며, 간단한 퍼즐을 푸는 데도 파라미터와 계산을 많이 씁니다 (arXiv:2611.17309).
CRAM의 학습은 지형을 고르는 일입니다. 풀린 퍼즐의 정답 판이 있는 자리는 파서 낮추고, 모델이 지금 낮게 매기고 있는 다른 판의 자리는 돋워 올립니다. 이 논문이 주로 쓴 방법은 정답 판을 「칸 하나만 다른 숫자로 바꾼 판들」과 견주어, 정답 판이 그 판들보다 낮은 자리에 오도록 숫자를 고치는 것입니다. 이 과정에서 공을 실제로 굴려 보거나 굴러간 길을 거슬러 오를 필요가 없습니다 (arXiv:2611.17309).
Sudoku-Extreme에서 CRAM은 0에서 시작한 숫자들을 퍼즐 1,000개로 32번 고쳐 학습을 끝냈습니다. 학습 중에 CRAM은 행·열·3×3 칸이 어디인지를 입력으로 받지 않았습니다. 81개의 칸은 그저 번호 붙은 자리였고, 데이터에 더한 것은 숫자 이름을 서로 바꿔 붙인 판들뿐이었습니다 (arXiv:2611.17309).
저자들은 같은 에너지를 다섯 가지 학습법으로 학습시켜 견줬습니다. 스도쿠에서 정답 판과 칸 하나 바꾼 판을 견주는 방법은 개발용 퍼즐 512개의 99%를 푸는 데 48밀리초가 걸렸습니다. HRM처럼 마지막 한 단계만 거슬러 오르는 방법은 4.4초가 걸렸습니다. 굴러간 길 전체를 거슬러 오르는 방법은 245초 뒤 평균 27%로 아직 오르는 중이었고, 약 5시간을 학습시켜 시험 퍼즐의 48.8%를 풀었습니다. 미로에서는 이 방법도 시험 미로를 모두 풀었습니다 (arXiv:2611.17309). 반복 모델이 쓰는 짧게 거슬러 오르는 학습으로도 이 작은 에너지는 몇 초 만에 배워졌고, 거슬러 오르지 않는 학습법이 거기서 시간을 다시 수십 배 줄였습니다. 이 실험의 시간은 표의 학습 시간과 재는 방식이 달라 크기만 견줄 수 있습니다(우리 정리).
이 아이디어 자체가 처음은 아닙니다. 풀린 스도쿠에서 칸 짝마다의 비용을 배우는 방법은 이미 있었습니다. 그 방법들은 배운 비용을 바깥의 정확한 풀이 프로그램에 넘겨 답을 구했고, CRAM은 그 자리를 자기 에너지를 내려가는 탐색으로 바꿨습니다. 저자들은 바깥 풀이 프로그램을 쓰는 방법을 비교 대상에서 뺐습니다 (arXiv:2611.17309).
공을 굴려 푸는 법
새 스도쿠 한 판이 들어왔다고 해 보겠습니다. CRAM은 먼저 단서로 주어진 칸을 고정합니다. 나머지 빈칸은 숫자를 무작위로 채운 판으로 시작하고, 이런 판을 서로 독립적으로 네 개 만듭니다. 네 판은 각자 지형 위 어딘가에 놓인 공 네 개입니다 (arXiv:2611.17309).
공은 한 번에 한 칸씩 움직입니다. 매 걸음 CRAM은 주변과 부딪히는 정도가 큰 칸 하나를 골라, 그 칸의 숫자를 지금의 에너지가 가리키는 쪽으로 다시 뽑습니다. 이 뽑기에는 일부러 무작위성을 섞습니다. 저자들은 그 흔들림이 있어야 정답이 아닌데도 주변보다 낮은 가짜 웅덩이에서 공이 빠져나오고, 서로 다른 답을 찾아 돌아다닐 수 있다고 적었습니다 (arXiv:2611.17309).
멈출 때는 에너지가 알려 줍니다. 학습할 때 본 정답 판들 가운데 에너지가 가장 높았던 값에 작은 여유를 더한 선이 멈춤 기준입니다. 네 공 가운데 하나라도 그 선 아래로 내려오면, 곧 정답들이 놓여 있던 깊이에 닿으면 탐색을 끝냅니다. 정해 둔 계산 한도 안에 아무 공도 거기 닿지 못하면 가장 낮은 판을 내놓고 멈춥니다 (arXiv:2611.17309).
이 멈춤 기준은 시험에서 틀린 판에서 멈춘 적이 없었습니다. 세 번 학습한 모델로 Sudoku-Extreme 시험 퍼즐을 모두 합쳐 약 124만 번 풀었고, 그중 51번은 한도 안에 기준선에 닿지 못해 놓쳤습니다. 멈춤 규칙을 가진 반복 모델 다섯(HRM·TRM·EqR·TRMP·EBR)은 따로 학습한 멈춤 장치나 자체 멈춤 규칙을 쓰는데, 그 규칙이 멈춘 퍼즐 가운데 0.05~3.54%에서 틀린 판이었습니다 (arXiv:2611.17309).
계산은 퍼즐의 어려움을 따라갑니다. 시험 퍼즐 1만 개를 데이터셋이 매긴 난이도로 나눠 보니, CRAM이 쓴 계산의 중앙값은 가장 쉬운 묶음에서 가장 어려운 묶음으로 가며 22배 늘었습니다. 비교 모델 하나는 모든 퍼즐에 같은 계산을 썼고, 에너지의 기울기로 멈춤을 정하는 다른 모델 EBR도 난이도에 따라 계산이 거의 달라지지 않았습니다 (arXiv:2611.17309). 지형이 험한 퍼즐에서 공이 더 오래 구르는 것이 그대로 계산량으로 나타납니다.
이 그림에는 한계도 있습니다. 「에너지가 결코 올라가지 않는다」는 보장은 무작위성이 없고 시간이 끊김 없이 흐르는 이론 속 계산에 대한 것입니다. 실제 탐색은 일부러 흔들어서 잠시 높은 판을 지나가기도 합니다. 저자들은 이 보장이 하나뿐인 바닥으로 간다는 것도, 바닥이 곧 정답이라는 것도 말해 주지 않는다고 부록에 적었습니다 (arXiv:2611.17309).
숫자를 나눠 읽기
저자들이 견준 반복 모델 일곱 가운데 넷과 CRAM의 결과는 다음과 같았습니다. 스도쿠 정답률은 시험 퍼즐 41만여 개, 미로는 시험 미로 1,000개에서 잰 값이고, 학습 시간은 모두 같은 종류의 GPU 한 장에서 잰 값입니다 (arXiv:2611.17309).
| 모델 | Sudoku-Extreme 정답률(%) | 파라미터(스도쿠) | 학습 시간(스도쿠) | Maze-Unique 정답률(%) |
|---|---|---|---|---|
| HRM | 54.62 | 2,700만 | 1.2시간 | 39.97 |
| TRM | 85.73 | 500만 | 2.5시간 | 92.23 |
| EBR | 99.85 | 180만 | 2.8시간 | 89.80 |
| TRMP | 99.87 | 3만 2,800 | 9.0시간 | 99.23 |
| CRAM | 99.996 | 7,700 | 0.04초 | 100 |
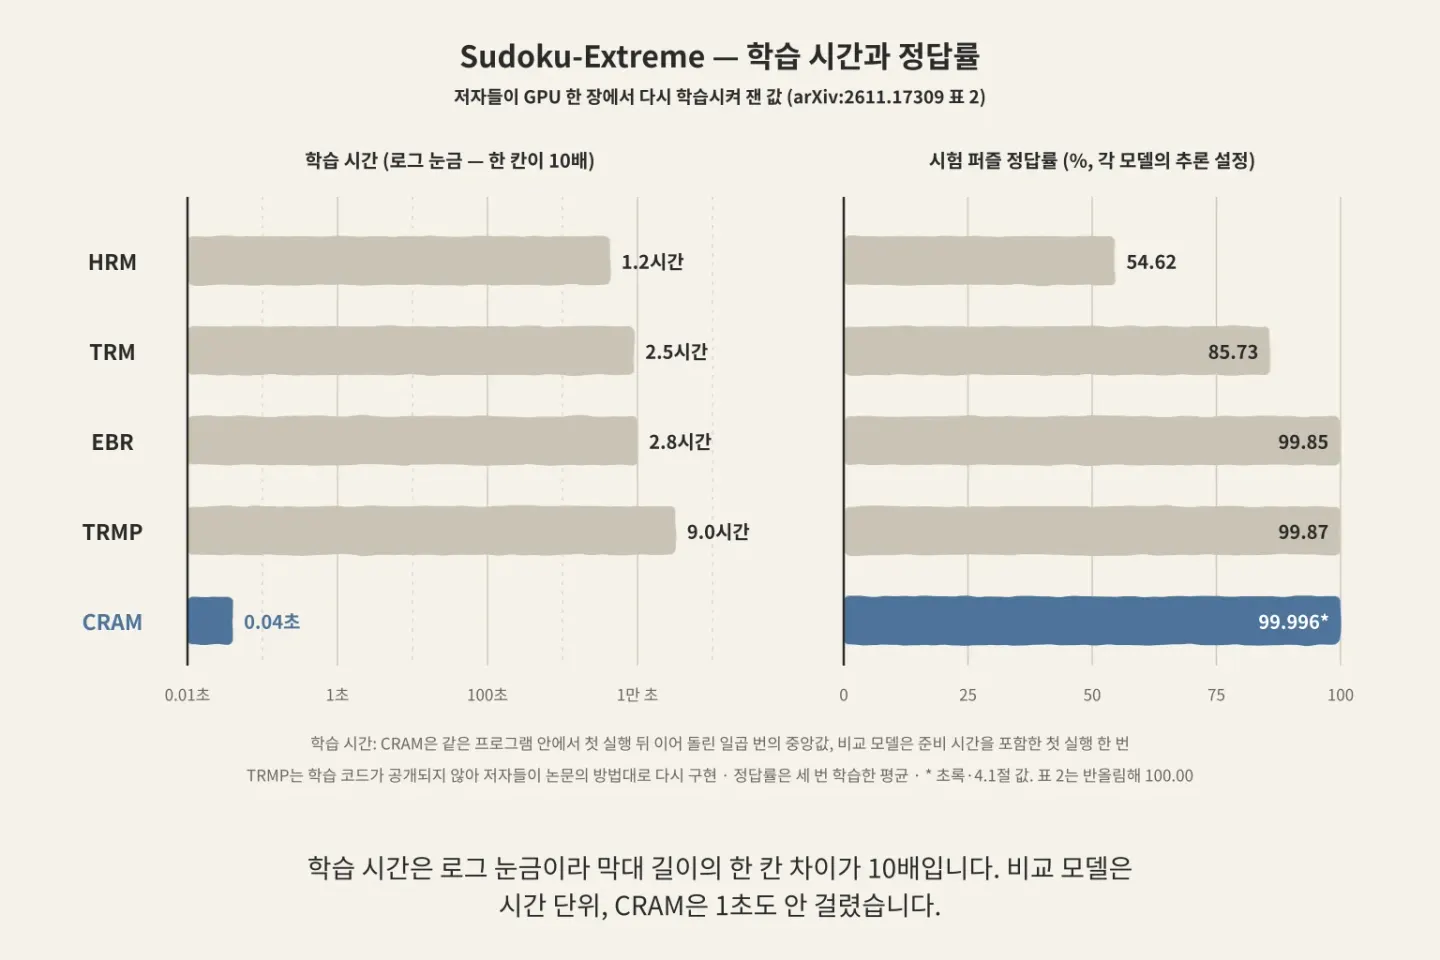
그림: Paperis가 arXiv:2611.17309 표 2의 값으로 그린 그래프
이 표의 반복 모델 수치는 저자들이 각 모델을 그 저자들의 코드와 학습 설정으로 직접 다시 학습시켜, 씨앗값을 바꿔 세 번 돌린 평균입니다. 다시 돌린 점수가 원 논문보다 2점 넘게 낮을 때만 원 논문의 값을 대신 적었고(표에 넣지 않은 두 모델이 그 경우입니다), 학습 코드가 공개되지 않은 TRMP는 논문의 설명대로 새로 구현했습니다 (arXiv:2611.17309).
HRM의 54.62%는 앞에서 본 HRM 분석이 적은 Sudoku-Extreme 출발점 54.5%와 비슷합니다 (arXiv:2601.10679). TRM에 잡음을 넣는 변형을 낸 다른 연구진은 TRM의 Sudoku-Extreme 출발점을 87.4%로 적고, 잡음을 넣어 98.75%까지 올렸다고 보고했습니다 (arXiv:2605.19943). 미로 열은 사정이 다릅니다. HRM·TRM·EBR은 Maze-Unique 점수를 낸 적이 없어서, 저자들이 각 모델의 다른 미로용 설정을 그대로 돌려 잰 값입니다 (arXiv:2611.17309).
학습 시간을 견주는 조건도 같지 않습니다. CRAM의 시간은 같은 프로그램 안에서 한 번 돌린 뒤 이어서 일곱 번 더 돌린 값의 중앙값이고, 처음 한 번만 드는 준비 시간 0.2~0.9초를 뺐습니다. 비교 모델은 준비 시간을 포함한 첫 실행 한 번을 쟀고, 준비 시간은 전체의 2.2%를 넘지 않았습니다(미로의 TRMP만 3.5%). 학습은 여러 작업이 함께 도는 공용 계산 장비에서 했기 때문에 시간이 흔들릴 수 있다고 저자들은 적었습니다 (arXiv:2611.17309). 스도쿠에서 CRAM에 준비 시간을 다 더해도 1초를 넘지 않고, 표의 비교 모델 가운데 스도쿠 학습이 가장 빨랐던 HRM은 1.2시간이므로, 차이는 여전히 수천 배입니다(우리 계산).
푸는 데 드는 계산은 덧셈과 곱셈 같은 연산의 횟수로 셉니다. CRAM은 Sudoku-Extreme 한 문제에 평균 약 20억 번을 썼습니다. 저자들이 계산이 가장 적은 반복 모델로 꼽은 EBR이 가장 정확할 때(99.86%) 한 문제에 약 5,400억 번을 썼고, CRAM은 같은 정확도를 약 19억 번으로 맞췄습니다. 282배는 이 비교에서 나온 값이고, 가장 많이 쓰는 모델과 견주면 12만 8,000배였습니다 (arXiv:2611.17309). 파라미터는 CRAM이 0이 아닌 값만 센 7,700개이고, 비교 모델은 신경망 전체의 개수라 실제로 쓰이는 수보다 클 수 있습니다 (arXiv:2611.17309).
적은 데이터에서도 비슷한 그림이었습니다. 시험 퍼즐의 98%를 푸는 데 CRAM은 서로 다른 학습 퍼즐 30개가 필요했고, EBR은 700개가 필요했습니다. 다만 학습 퍼즐이 10개도 안 되는 극단에서는 TRM이 가장 많이 맞혔고, 그 구간에서 CRAM은 틀린 판으로 많이 수렴했습니다 (arXiv:2611.17309).
여러 답이 가능한 두 과제, 곧 체스판에 서로 공격하지 않게 퀸을 놓는 N퀸 문제와 이웃한 점끼리 다른 색을 칠하는 그래프 색칠에서는 그림이 덜 극적입니다. CRAM은 가장 좋은 반복 모델과 비슷한 수준이었고, 8×8 판의 N퀸에서 답 하나만 뽑을 때의 정답률은 EBR이 100%, CRAM이 99.95%였습니다. 학습 시간은 여기서도 CRAM이 몇 초, 반복 모델이 수십 분에서 몇 시간으로 갈렸습니다 (arXiv:2611.17309). 1,000배는 저자들이 Sudoku-Extreme과 Maze-Unique 두 퍼즐에서 잰 학습 시간 비교이고, 282배는 Sudoku-Extreme에서 반복 모델의 최고 정확도에 맞췄을 때의 계산 비교입니다.
가중치를 열어 보면
스도쿠 판에는 칸이 81개 있고, 한 칸과 같은 행·열·3×3 칸을 공유하는 칸은 20개입니다. 이런 칸 쌍은 모두 810개입니다. CRAM은 행과 열과 칸이 어디인지 입력으로 받지 않았는데도, 학습을 돌릴 때마다 바로 그 810쌍에만 「같은 숫자면 벌점」을 매기고 나머지 칸 쌍의 벌점은 모두 0으로 남겼습니다 (arXiv:2611.17309). 정답 판들을 낮추고 칸 하나 바꾼 판들을 돋우다 보니 지형이 스도쿠 규칙의 모양으로 깎인 것입니다. 학습에는 작은 벌점을 0으로 끌어내리는 항도 함께 들어 있었습니다 (arXiv:2611.17309).
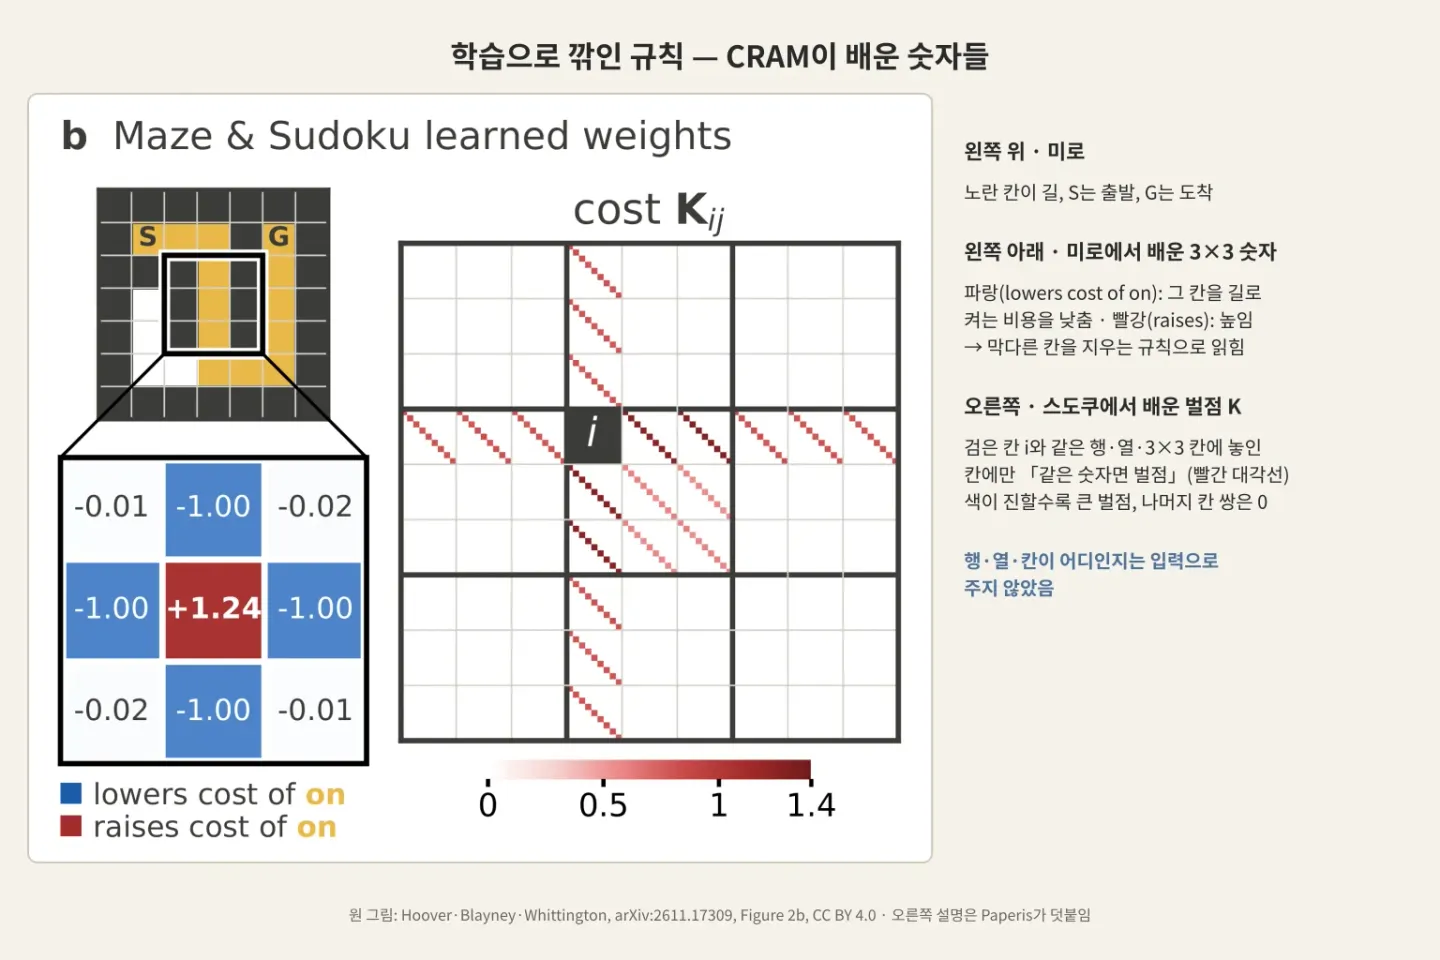
그림: Hoover·Blayney·Whittington, arXiv:2611.17309, Figure 2b, CC BY 4.0
미로에서도 같은 일이 일어났습니다. Maze-Unique에서 학습된 숫자 18개는 탐색의 매 걸음마다 막다른 칸 하나를 지우는 규칙으로 읽혔습니다. 막다른 길을 끝에서부터 메워 나가 길이 하나만 남게 하는 이 방법은, 길이 하나뿐인 미로라면 언제나 푸는 것으로 알려진 국소 규칙입니다 (arXiv:2611.17309).
그렇다면 규칙을 손으로 적어 넣어도 됩니다. 저자들은 각 퍼즐의 규칙만 보고 숫자를 손으로 정한 CRAM 에너지도 시험했습니다. 스도쿠는 서로 다른 값 하나, 미로는 서로 다른 값 셋으로 된 에너지가 시험 퍼즐을 하나도 빼놓지 않고 풀었습니다. 스도쿠에서는 학습한 에너지보다 계산을 최대 19배 적게 썼고, N퀸과 그래프 색칠에서는 모든 지표에서 가장 좋은 모델이었습니다 (arXiv:2611.17309).
저자들은 이 벤치마크에서의 높은 점수가 답 칸들 사이의 짝 규칙 몇 개를 익혔다는 것까지만 보여 준다고 적었습니다. 그리고 이를 「이런 추론 문제에 더 큰 반복 모델을 들이붓는 일에 대한 부드러운 경고」라고 불렀습니다 (arXiv:2611.17309). 이 퍼즐들의 점수가 높다는 사실만으로는 더 어려운 과제로 넘어갈 힘을 읽어 낼 수 없다는 뜻입니다.
이 결과가 말하지 않는 것
저자들은 CRAM의 단순한 에너지만으로는 ARC 같은 더 복잡한 추론 과제를 배우기 어려울 것이라고 적었습니다. 이 논문이 시험한 퍼즐들은 모두 CRAM의 「칸 짝 벌점」 에너지로 정확히 나타낼 수 있는 종류입니다. 저자들의 설명으로는 ARC-AGI-1 같은 더 어려운 과제에서 답이 보이는 판으로부터 모델이 따로 계산해 내야 하는 양에 달려 있습니다. 더 어려운 미로에서 각 칸이 목표까지 얼마나 먼지가 그런 양의 예입니다 (arXiv:2611.17309).
부록의 실험이 그 경계를 보여 줍니다. 고리가 있는 미로 묶음 Maze-Hard에서는 막다른 길 메우기가 통하지 않고, CRAM 혼자서는 시험 미로를 하나도 풀지 못했습니다. 목표에서 한 걸음 멀어질 때마다 값이 일정하게 줄도록 설계한 숨은 층을 하나 덧붙이자, 파라미터 29개로 1,000개 가운데 999개를 풀었습니다. 그러나 이 층은 미로가 거리에 달린 과제라는 것을 알고 넣은 장치이고, 저자들은 이런 숨은 양을 과제 설계를 미리 알지 못한 채 일반적으로 배우는 일이 중요한 열린 연구 과제로 남아 있다고 적었습니다 (arXiv:2611.17309). 저자들 스스로 이 에너지가 모든 추론 과제에 대한 최종 답은 아니라고 썼고, 같은 문장에서 명시적 에너지가 주는 이점은 크다고 덧붙였습니다 (arXiv:2611.17309).
CRAM도 반복 계산입니다. CRAM의 에너지를 내려가는 기본 갱신 식은 한 번이 반복 모델의 층 하나와 같은 꼴이고, 저자들은 에너지를 낮추는 일을 반복 계산에 원리를 주는 틀로 소개합니다. 반복 모델들이 멈춤 장치나 안정된 수렴 같은 에너지의 장점을 하나씩 따로 덧붙여 왔으니, 아예 에너지를 직접 배우면 어떻겠느냐는 것이 이 논문의 질문이었습니다 (arXiv:2611.17309). 같은 달 다른 연구진도 반복 추론 모델을 에너지 기반 모델로 만들자는 프리프린트를 내, Sudoku-Extreme 99.9%를 보고했습니다 (arXiv:2611.08977). 위 표의 EBR이 그 모델입니다.
비교의 범위도 좁습니다. 이 논문은 스도쿠·미로·N퀸·그래프 색칠, 네 종류의 퍼즐에서 반복 모델을 다시 학습시켜 견줬고, 부록에서 더 어려운 미로 하나를 원 논문 값과 나란히 놓았습니다. TRM이 보고한 ARC 점수에 해당하는 비교는 이 논문에 없습니다 (arXiv:2510.04871; arXiv:2611.17309). 반복 계산 자체도 퍼즐 밖에서 연구됩니다. 층 몇 개를 여러 번 되풀이한 언어 모델이 같은 수만큼 층을 실제로 쌓은 모델과 겨룰 만하다는 연구가 있습니다 (arXiv:2502.17416).
근거의 무게도 따져 둘 만합니다. 이 결과는 심사를 거치지 않은 프리프린트 한 편이고, CRAM과 비교 모델을 모두 같은 저자들이 학습시키고 쟀습니다. 저자들은 코드와 실행 기록, 표와 그림 뒤의 결과를 모두 공개했다고 밝혔습니다. 다른 연구진이 다시 해 본 결과는 아직 없습니다 (arXiv:2611.17309).
스도쿠 점수가 재는 것
ARC를 만든 프랑수아 숄레는 2019년에 한 가지 과제에서의 솜씨만 재서는 지능을 잴 수 없다고 주장했습니다. 솜씨는 미리 넣어 준 지식과 경험에 크게 좌우되고, 사전 지식이나 학습 데이터를 무한히 주면 실험자가 원하는 만큼의 솜씨를 「사들일」 수 있어 시스템 자신의 일반화 능력이 가려진다는 것입니다 (arXiv:1911.01547).
이 논문의 손으로 적은 에너지는 그 지적과 나란히 놓입니다. 스도쿠 규칙을 숫자 하나로 적어 넣은 에너지가 Sudoku-Extreme을 다 풀었습니다. 같은 탐색에 규칙만 적어 넣어도 이 시험지의 만점에 닿았습니다 (arXiv:2611.17309).
같은 「스도쿠」라는 이름 아래에도 재는 것은 다를 수 있습니다. 규칙을 비틀어 퍼즐마다 새로운 제약이 붙는 변형 스도쿠를 모은 벤치마크에서는, 최신 큰 언어 모델이 도움 없이 푼 퍼즐이 15%에 못 미쳤습니다 (arXiv:2505.16135). 이 벤치마크는 퍼즐마다 규칙이 달라 외워서는 풀 수 없도록 고른 것입니다. 이 벤치마크에서 CRAM이나 작은 반복 모델을 시험한 결과는 없습니다.
저자들은 이 퍼즐들이 파라미터 몇 개로도 쉽게 풀리는 만큼, 여기서의 높은 정확도가 더 어려운 과제에서의 성능을 가리키지 않는다고 적었습니다 (arXiv:2611.17309). 학습 1초 미만, 파라미터 7,700개로 풀리는 시험지에서 몇 시간 학습한 모델이 몇 점을 더 받았는지는 그 모델이 더 큰 문제로 커질 수 있는지를 말해 주지 못한다는 뜻입니다. 저자들이 같은 결과에서 에너지가 데이터로 추론을 배우는 유망한 길이라고 결론 내린 것도 함께 남습니다. 「작은 모델이 어려운 퍼즐을 풀었다」는 소식을 들으면, 그 퍼즐의 규칙을 손으로 적은 에너지가 숫자 몇 개로 그 퍼즐을 푸는지를 함께 물어볼 수 있습니다.
어디를 더 볼까
파라미터가 무엇이고 학습이 그 숫자를 어떻게 조금씩 고치는지는 「신경망과 파라미터 — 수천억 개의 다이얼을 조금씩 돌린다는 것」에서 차근차근 다룹니다. CRAM은 사람이 적던 규칙을 풀린 퍼즐에서 배웠는데, 규칙을 적어 넣는 대신 예시에서 계산 방식을 찾게 하는 생각 자체는 「AI 모델 — 규칙 대신 예시에서 배우는 계산」에 있습니다. 시험지 점수와 그 밖에서의 실력이 어긋나는 다른 사례는 「AI의 오류 — 시험장 밖에서 틀리는 수험생」에서 이어집니다.
근거 논문
- "Classical Energies Learn to Reason 1,000x Faster than Looped Models" (2026) — arXiv:2611.17309 (프리프린트) — 학습형 홉필드·탱크 에너지(CRAM)가 Sudoku-Extreme 99.996%·Maze-Unique 100%를 42·132 ms 학습으로 풀고, Sudoku-Extreme에서 반복 모델 최고 정확도에 282배 이상 적은 계산으로 맞춤. 에너지는 유망하나 쉽게 풀리는 벤치마크로 반복 추론의 확장성을 재지 말라는 경고.
- "Hierarchical Reasoning Model" (2025) — arXiv:2506.21734 (프리프린트) — 2,700만 파라미터·학습 예시 1,000개로 어려운 스도쿠와 큰 미로에서 거의 완벽한 성능, ARC에서 더 큰 모델을 앞섰다고 보고.
- "Less is More: Recursive Reasoning with Tiny Networks" (2025) — arXiv:2510.04871 (프리프린트) — 층 2개·700만 파라미터의 TRM이 ARC-AGI-1 45%, ARC-AGI-2 8%로 대부분의 큰 언어 모델보다 높았다고 보고.
- "Are Your Reasoning Models Reasoning or Guessing? A Mechanistic Analysis of Hierarchical Reasoning Models" (2026) — arXiv:2601.10679 (프리프린트) — HRM이 빈칸 하나짜리 퍼즐에서도 틀리고 첫 고정점을 「추측」함. 보강으로 Sudoku-Extreme 54.5%→96.9%.
- "Probabilistic Tiny Recursive Model" (2026) — arXiv:2605.19943 (프리프린트) — TRM에 잡음을 넣어 Sudoku-Extreme 87.4%→98.75%.
- "Energy-Based Reasoners: Your Recurrent Reasoner Should Be an Energy-Based Model" (2026) — arXiv:2611.08977 (프리프린트) — 반복 추론을 학습된 에너지의 경사 하강으로 바꿔 Sudoku-Extreme 99.9%.
- ""Neural" computation of decisions in optimization problems." (1985) — PMID 4027280 — 촘촘히 이어진 아날로그 뉴런 망이 제약 아래 최적화 문제(외판원 문제)의 좋은 해를 빠르게 집단 계산.
- "Neural networks and physical systems with emergent collective computational abilities." (1982) — PMID 6953413 — 단순한 단위가 많이 이어진 계에서 일부로부터 전체 기억을 되살리는 내용 주소 기억이 집단 성질로 나타남.
- "On the Measure of Intelligence" (2019) — arXiv:1911.01547 (프리프린트) — 특정 과제의 솜씨는 사전 지식과 경험으로 「살 수」 있어 일반화를 가린다. 지능을 기술 습득 효율로 정의하고 ARC를 제안.
- "Sudoku-Bench: Evaluating creative reasoning with Sudoku variants" (2025) — arXiv:2505.16135 (프리프린트) — 퍼즐마다 새 제약이 붙는 변형 스도쿠에서 최신 언어 모델이 도움 없이 15% 미만을 풂.
- "Reasoning with Latent Thoughts: On the Power of Looped Transformers" (2025) — arXiv:2502.17416 (프리프린트) — k층을 L번 되풀이한 모델이 kL층 모델과 거의 맞먹고, 언어 모델에서도 경쟁력이 있음.