Paperis 아티클
AI는 의사보다 진단을 잘하나 — 시험장 점수와 진료실 사이
몇몇 통제된 벤치마크와 사례 문제 시험에서 언어모델은 일반의보다 높은 점수를 냈지만, 연구를 모은 메타분석에서는 의료인과 뚜렷이 갈리지 않았습니다. 같은 AI를 의사 옆에 둔 시험에서 의사 점수는 시험에 따라 거의 또는 조금 올랐고, 실제 유방촬영 검진에서는 AI가 판독을 나누고 의심 부위를 표시한 갈래가 암을 더 찾았습니다. 세 숫자가 왜 다른지 따라갑니다.
AI는 의사보다 진단을 잘하나 — 시험장 점수와 진료실 사이
83.2%와 36.1%
한 환자의 짧은 첫 소견만 주어집니다. 무엇을 더 물을지, 어떤 검사를 낼지 스스로 골라 정보를 한 조각씩 받아 가며 진단에 이르러야 하고, 검사마다 비용이 매겨집니다. 2026년에 발표된 한 연구는 진단을 이렇게 한 걸음씩 좁혀 가는 방식으로 채점하는 시험을 만들고, 여러 의사가 모여 의견을 나누는 회의를 흉내 내도록 짠 AI 시스템에게 풀게 했습니다 (PMID 42912144). 이 시스템은 의학 학술지 『뉴잉글랜드 의학 저널』의 임상병리 토론 증례에서 83.2%, 응급실 입원 기록 모음(MIMIC-IV-ED)에서 80.3%를 맞혔고, 같은 시험을 치른 일반의는 각각 36.1%와 46.8%였습니다 (PMID 42912144).
이 시스템의 바탕은 언어모델입니다. 대규모 언어모델(large language model)은 방대한 양의 글로 다음에 올 낱말을 맞히도록 훈련받아, 질문에 문장으로 답하는 AI입니다. 의사에게 묻듯 증상을 적어 넣으면 가능한 병명과 그 이유를 글로 돌려줍니다.
83.2%와 36.1%는 같은 문제지에서 나온 숫자입니다. 벤치마크는 여러 AI나 사람을 같은 문제 묶음으로 채점해 견주는 표준 시험입니다. 같은 문제를 풀게 하니 비교가 공정하고, 바로 그 이유로 결과는 그 문제지 안에서만 성립합니다. 연구진도 초록에 이 결과가 통제된 벤치마크 설정에서 얻은 것이라고 적었고, 그 위에서 언어모델이 더 정확하고 비용이 덜 드는 진단을 도울 가능성을 보여 준다고 결론지었습니다 (PMID 42912144). 이 글은 그 문제지 안의 점수와, AI를 실제 진료실과 검진실에 들였을 때 일어난 일 사이의 거리를 따라갑니다.
점수는 문제지를 따라 움직인다
의사 면허시험형 문제에서 선두 언어모델은 84~90%를 맞힙니다 (PMID 41325597). 2025년까지 나온 의학용 벤치마크 39개를 모은 체계적 고찰에서, 실제 진료 업무를 흉내 낸 벤치마크에서는 성공률이 45~69%였고, 진단 과제는 45~55%, 안전 판단을 묻는 과제는 40~50%였습니다 (PMID 41325597). 저자들은 시험 점수가 진료에 나설 준비가 됐는지를 재는 대리 지표로는 불충분하고 오해를 부른다고 결론지었습니다 (PMID 41325597). 어떤 형식의 문제지로 재느냐에 따라 성적표가 이만큼 달라집니다.
진단 과정의 단계를 나눠 채점하면 차이가 더 또렷해집니다. 감별진단(differential diagnosis)은 환자의 증상을 설명할 수 있는 병의 후보를 여럿 세워 두고, 소견과 검사로 하나씩 지워 가며 좁히는 과정입니다. 처음 본 환자 앞에서 불확실성을 다루는 일이 많이 걸려 있는 단계입니다. 언어모델 21개를 의학 참고서(MSD 매뉴얼)의 환자 사례 29개로 채점한 단면 연구에서, 모든 모델이 최종 진단에서는 실패율이 0.40 아래였지만 감별진단에서는 실패율이 0.80을 넘었습니다 (PMID 41973425). 저자들은 이 모델들이 최종 진단은 잘 맞히지만 감별진단을 세우고 불확실성을 헤쳐 나가는 데서는 다른 추론 단계에 비해 약하고, 기성 모델들은 안전하게 진료에 쓸 수준에 아직 이르지 못했다고 결론지었습니다 (PMID 41973425). 정답 하나를 고르는 문제에서 높은 점수는 후보를 넓게 펼치는 능력까지 보증하지 않습니다.
사람과 직접 견준 연구를 모으면 그림은 한쪽으로 기울지 않습니다. 객관식을 빼고 진단을 직접 적게 한 연구 50편을 모은 메타분석에서, 첫 번째로 꼽은 진단이 맞을 비율은 언어모델이 의료인의 0.89배(신뢰구간 0.79~1.00)였습니다 (PMID 41652180). 꼽는 진단의 수를 늘릴수록 둘은 가까워져, 후보 열 개까지 허용하면 1.17배(신뢰구간 0.87~1.57)였습니다 (PMID 41652180). 다른 메타분석은 연구 30편과 사례 4,762개를 모았는데, 대부분의 연구가 치우침 위험이 높았고 그 주된 이유는 이미 진단이 알려진 증례를 썼다는 점이었습니다 (PMID 40279517). 이 메타분석에서 연구마다 가장 좋은 모델의 주진단 정확도는 25%에서 97.8%까지 흩어졌습니다 (PMID 40279517). 저자들은 언어모델의 정확도가 아직 의료인에 못 미치지만, 조심해서 쓰면 좋은 보조 도구가 될 수 있다고 결론지었습니다 (PMID 40279517). 한 벤치마크에서 크게 앞선 점수와, 여러 연구를 모았을 때 의료인과 뚜렷이 갈리지 않는 결과가 함께 있습니다.
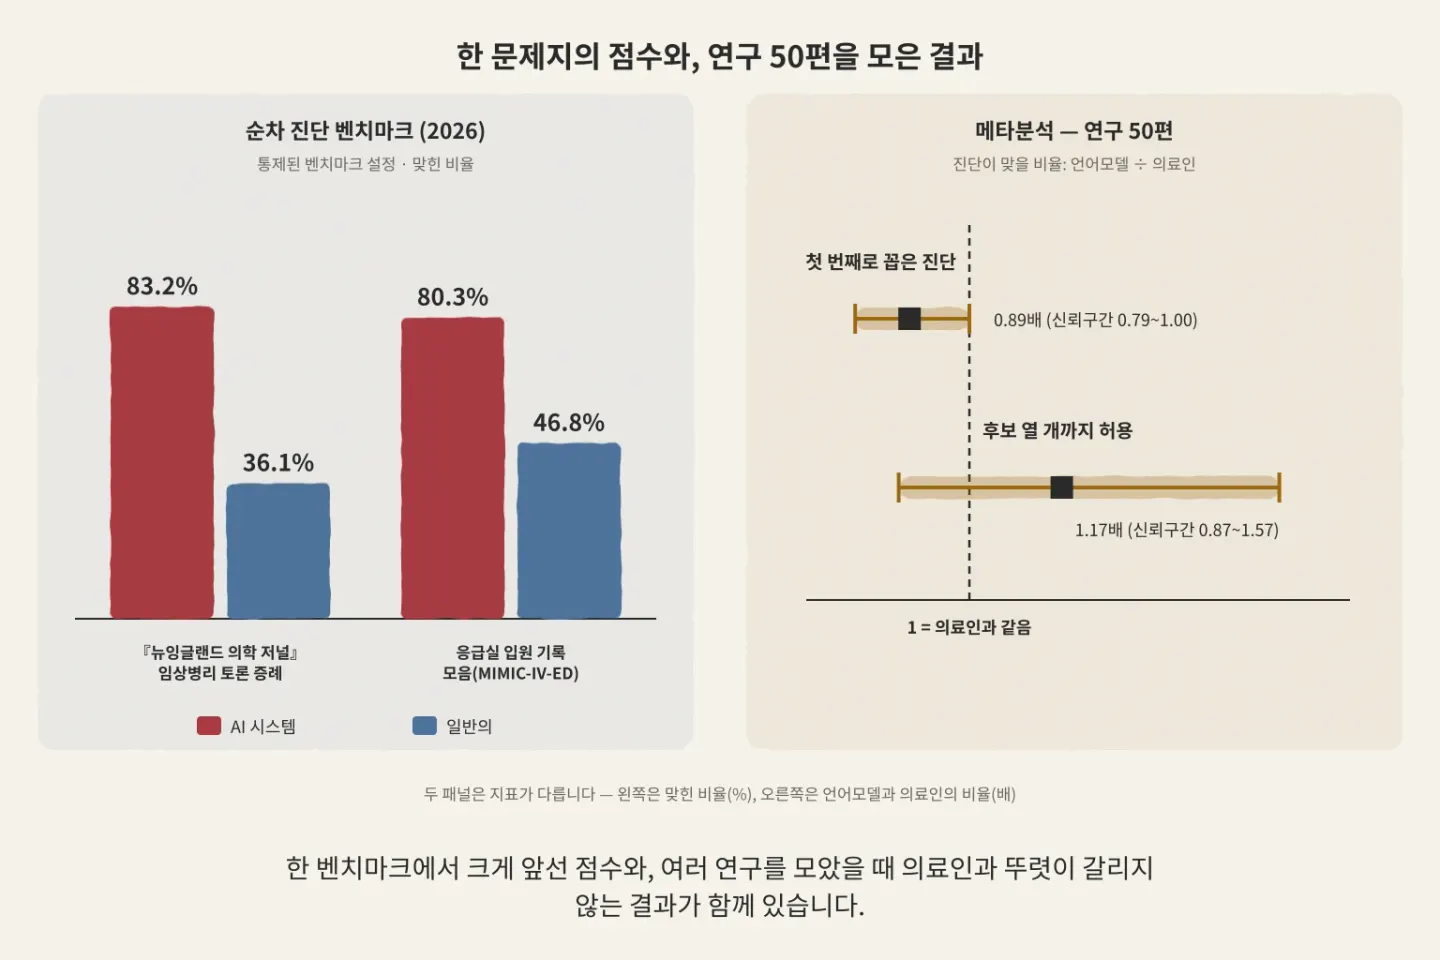
그림: Paperis가 본문 내용만으로 그린 도식
들고 갈 한 줄은 이렇습니다. AI의 진단 점수는 어떤 문제지로 쟀는지를 함께 말할 때만 뜻을 가집니다.
같은 AI를 의사 옆에 두면
AI가 문제지에서 의사를 앞선다면, 의사에게 그 AI를 쥐여 주면 의사 점수가 올라갈 것이라는 기대가 자연스럽습니다. 이 기대를 시험한 방법이 무작위 대조 시험입니다. 무작위 대조 시험은 참가자를 제비뽑기처럼 무작위로 나눠 한쪽에만 어떤 처치를 하고, 다른 쪽과 결과를 견주는 시험입니다. 여기서 처치는 AI를 쓸 수 있게 해 주는 것입니다.
2023년 말 미국 여러 대학병원의 연구진은 가정의학·내과·응급의학을 수련한 의사 50명(전문의 26명, 전공의 24명)을 무작위로 둘로 나눴습니다 (PMID 39466245). 한쪽은 평소 쓰는 자료에 더해 언어모델(GPT-4)을 쓸 수 있었고, 다른 쪽은 평소 자료만 썼으며, 두 집단 모두 60분 동안 사례 문제를 최대 6개 풀었습니다 (PMID 39466245; PMID 38559045). 사례 문제는 기존 진단 추론 시험에서 가져와 다듬은, 글로 적은 환자 사례이고 (PMID 38559045), 채점은 감별진단이 맞는지, 그 근거와 반대 근거를 적절히 댔는지, 다음 검사를 무엇으로 할지까지 봤습니다 (PMID 39466245). 진단 추론 점수의 중앙값은 언어모델을 쓴 집단이 76%, 평소 자료만 쓴 집단이 74%였고, 보정한 차이는 2%포인트로 통계적으로 의미가 없었습니다 (PMID 39466245).
같은 연구의 탐색적 분석에서는 언어모델에게 혼자 문제를 풀게 했는데, 평소 자료만 쓴 의사 집단보다 16%포인트 높았습니다 (PMID 39466245). 신뢰구간은 2~30%포인트로 넓었습니다 (PMID 39466245). 연구진은 AI 혼자가 두 의사 집단 모두보다 높았다고 적고, 의사와 AI의 협업이 제 몫을 하려면 기술과 인력 양쪽의 발전이 필요하다고 결론지었습니다 (PMID 39466245). 이 시험에서 AI를 옆에 둔 의사의 점수는 AI 혼자의 점수만큼 오르지 않았습니다. 이 결과는 미국 의사 50명이 글로 된 사례 문제를 푼 시험에서 나온 것이고, 실제 환자를 보는 진료실에서 잰 것은 아닙니다.
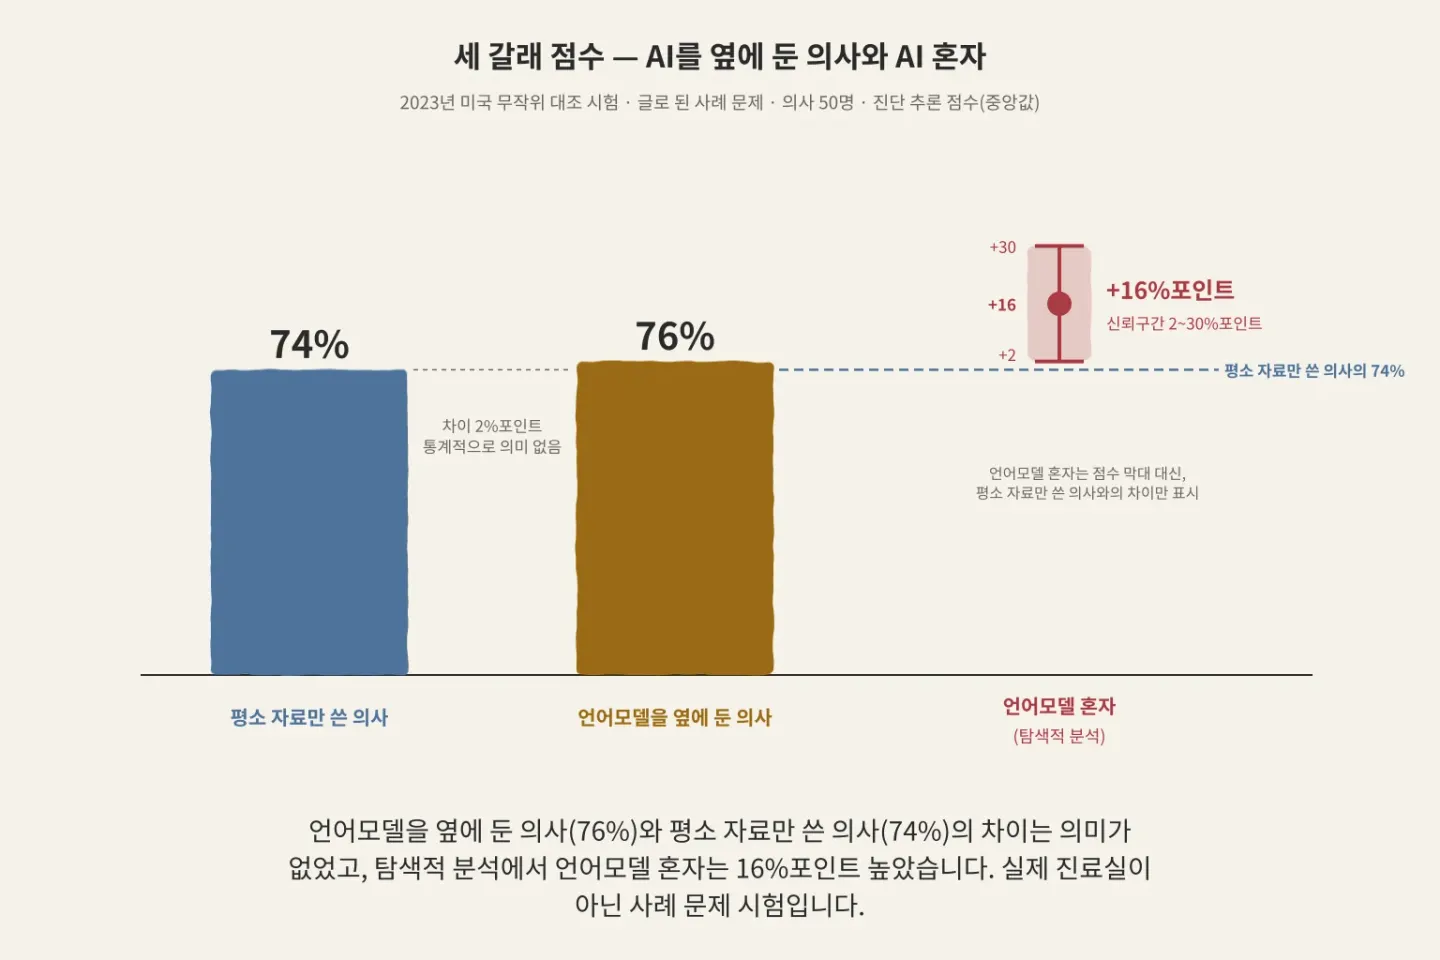
그림: Paperis가 본문 내용만으로 그린 도식
영국에서 이 시험을 다시 해 본 연구는 조금 다른 숫자를 얻었습니다. 영국 의사 22명이 사례 문제 4개를 풀며 그중 2개에서만 언어모델을 쓸 수 있게 한 설계였고, 언어모델을 쓸 수 있을 때 의사 점수는 74.3%로 평소 자료만 쓸 때의 65.7%보다 높았습니다 (PMID 42053372). 그래도 언어모델 혼자의 점수는 언어모델을 쓴 의사보다 평균 21.3%포인트 높았습니다 (PMID 42053372). 치료와 검사 계획을 묻는 관리 추론에서는, 의사 92명이 모의 설정에서 사례 문제 5개를 푼 무작위 대조 시험에서 GPT-4를 쓴 의사가 6.5% 높은 점수를 받았고, 사례당 시간은 119.3초 더 걸렸으며, GPT-4를 쓴 의사와 GPT-4 혼자 사이에는 의미 있는 차이가 없었습니다 (PMID 39910272). 연구진은 이 결과를 실제 진료에서 검증해야 한다고 적었습니다 (PMID 39910272).
단일 시험 여럿을 모으면 의사 쪽 이득이 더 분명하게 보입니다. 앞의 50편 메타분석에서, 언어모델의 도움을 받은 의료인은 혼자인 의료인보다 첫 번째로 꼽은 진단을 1.13배(신뢰구간 1.00~1.27), 세 번째 후보까지 넣으면 1.11배(신뢰구간 1.01~1.23) 더 맞혔습니다 (PMID 41652180). 이 메타분석의 저자들은 포함된 연구들의 방법론적 결함 때문에 진료에 들이기 전에 실제 환경에서 엄격하게 평가해야 한다고 결론지었습니다 (PMID 41652180). 하나하나의 시험에서는 「거의 오르지 않았다」와 「조금 올랐다」가 엇갈리고, 모아 보면 도움을 받은 쪽이 앞서는 방향이 나옵니다.
AI가 의사 점수를 분명히 끌어올린 결과도 있습니다. 의사 20명이 진단이 이미 알려진 어려운 학술지 증례 보고 302개를 읽은 연구에서, 진단 추론용으로 다듬은 언어모델의 도움을 받은 의사가 후보 열 개 안에 정답을 넣은 비율은 51.7%로, 도움 없이 풀었을 때의 36.1%와 검색 엔진을 쓴 의사의 44.4%보다 높았습니다 (PMID 40205049). 같은 연구에서 언어모델 혼자는 59.1%로, 같은 비교에서 도움 없이 푼 의사의 33.6%보다 높았습니다 (PMID 40205049). 반면 사람과 AI의 협업을 다룬 연구 10편을 모은 다른 메타분석은, 진단 정확도에 관한 연구가 둘뿐이라 결과가 불확실했고 세 집단을 견준 연구에서 사람과 AI의 조합이 AI 혼자보다 늘 낫지는 않았다고 적었습니다 (PMID 41606089).
여러 시험을 겹쳐 보면 하나의 모양이 나옵니다. AI를 옆에 둔 의사는 대체로 혼자일 때와 비슷하거나 나았고(연구에 따라 폭이 컸고), 몇몇 사례 문제 시험에서는 AI 혼자의 점수에 미치지 못했습니다.
묻지 않고, 따르고
영국 재현 연구에서 AI를 옆에 둔 의사들이 언어모델에게 직접 물은 것은 사례 질문의 30%였습니다 (PMID 42053372). 연구진은 의사들이 언어모델을 덜 쓴 것이 AI 혼자와의 점수 차이에 기여했다고 해석했고, 언어모델을 쓸 수 있게 했을 때 의사마다 얻은 이득의 크기가 크게 달랐다고 보고했습니다 (PMID 42053372). 이들의 결론은 의사가 이 도구를 자기 생각의 흐름에 끼워 넣도록 훈련하고, 그렇게 쓰는 것이 선택 사항에 머물지 않고 기본값이 되도록 시스템을 설계해야 한다는 것이었습니다 (PMID 42053372). 옆에 둔 AI에게 묻지 않으면 AI의 실력은 의사의 점수로 옮겨 가지 않습니다.
반대 방향의 문제도 있습니다. 자동화 편향(automation bias)은 기계가 내놓은 답에 지나치게 기대어, 틀린 답까지 따라가는 경향입니다. 2025년 파키스탄에서 열린 무작위 대조 시험은 AI를 비판적으로 평가하는 교육을 20시간 받은 의사 44명을 둘로 나눴습니다 (PMID 42932681). 두 집단 모두 사례 문제 6개를 풀며 언어모델(ChatGPT-4o)의 진단 제안을 원할 때 볼 수 있었는데, 한쪽에는 오류 없는 제안을, 다른 쪽에는 6개 중 3개에 일부러 오류를 넣은 제안을 줬습니다 (PMID 42932681). 오류가 섞인 제안을 받은 집단의 진단 추론 정확도는 73.3%로, 오류 없는 제안을 받은 집단의 84.9%보다 보정 차이로 14.0%포인트 낮았고, 가장 유력한 진단 하나를 맞힌 비율은 76.1% 대 90.5%였습니다 (PMID 42932681). 연구진은 의사들이 AI 교육을 받고 자발적으로 상담하는 조건에서도 상당한 자동화 편향을 보였다고 결론지었고, 이를 널리 진료에 들이기 전에 엄격한 검증 체계와 규제 안전장치가 필요한 안전 위험으로 보았습니다 (PMID 42932681).
자동화 편향은 AI가 도움이 될 때도 함께 나타납니다. 임상의 40명이 무릎 자기공명영상 200건에서 십자인대 파열을 판정한 실험에서, AI의 도움으로 정확도는 87.2%에서 96.4%로 올랐지만, 도움을 받은 판독에서 남은 실수의 45.5%가 AI를 따라간 실수였고 이 현상은 모든 경력 수준의 임상의에게서 나타났습니다 (PMID 37561535). 210명이 참여한 상처 진단 실험에서는 시스템이 쓸모 있다고 여길수록 틀린 AI 권고에 동의하는 비율이 높았고, 해당 분야 전문 수련을 받지 않은 사람일수록 이 편향에 취약했습니다 (PMID 39234734). 이 연구의 저자들은 AI에게서 가장 많이 얻을 사람이 이 편향에 가장 취약한 사람이기도 하다고 적었습니다 (PMID 39234734).
AI를 따라가는 성향은 AI가 맞을 때는 득이 됩니다. 판독자 30명이 흉부 엑스선 사진 120장에서 폐암 결절을 찾은 연구에서, 정확도가 높은 AI를 받은 판독자는 낮은 AI를 받은 판독자보다 발견 성적이 더 많이 올랐고, AI 제안을 보고 원래 판독을 바꾼 비율도 67%(334건 중 224건)로 59%(386건 중 229건)보다 높았습니다 (PMID 37367443). 호주의 유방촬영 자료로 검진 경로를 모의 실험한 연구에서는, 자동화 편향이 여러 판독자가 함께 읽는 체계에서는 성적을 떨어뜨렸지만 혼자 읽는 판독자에게서는 오히려 성적을 올렸습니다 (PMID 39214982). 따라가는 성향 자체는 같아도, AI가 얼마나 정확한지와 누가 어떤 체계에서 읽는지에 따라 결과의 방향이 바뀝니다.
AI가 답을 어떻게 보여 주느냐도 결과를 바꿉니다. 영상의학과 의사들이 판독 사례를 2,020회 평가한 무작위 실험에서, 언어모델이 진단에 이른 추론 과정을 단계별로 풀어 쓴 설명을 받은 경우 정확도가 AI 도움 없는 조건보다 12.2% 높았고, 진단명만 받은 경우보다 7.2%, 후보 목록을 받은 경우보다 9.7% 높았습니다 (PMID 42026140). 저자들은 이 결과가 사례 문제를 쓴 통제된 설정에서 나왔다고 밝히며, 추론을 설명해 주면 의사가 AI의 오류를 알아보고 고칠 수 있다고 해석했습니다 (PMID 42026140). 그런데 무릎 자기공명영상 판독자 12명과 심전도 판독자 44명을 대상으로 한 다른 연구에서는 AI의 판단 근거를 보여 주는 설명이 효과가 없거나 오히려 해로운 경우가 있었고, AI의 답을 먼저 보여 준 순서가 사람이 먼저 판단한 순서보다 정확도가 높았습니다 (PMID 36990586). 설명이 언제 돕고 언제 방해하는지는 아직 연구마다 엇갈립니다.
이 절의 연구들을 진단 하나를 앞에 둔 의사의 책상 위에 겹쳐 보면 갈림길이 셋 보입니다. 첫째는 순서입니다. 의사는 스스로 감별진단을 먼저 세울 수도 있고 AI의 답부터 볼 수도 있는데, 판독 연구 하나에서는 AI의 답을 먼저 본 순서가 더 정확했습니다 (PMID 36990586). 둘째는 물을지 말지입니다. 영국 의사들은 질문의 30%만 AI에게 물었습니다 (PMID 42053372). 셋째는 받은 답을 따를지입니다. AI의 도움을 받은 무릎 판독 실험에서는 정확도가 87.2%에서 96.4%로 올랐고(그래도 남은 실수의 45.5%는 AI를 따라간 실수였습니다) (PMID 37561535), 일부러 틀린 답이 섞인 사례 문제에서는 AI 교육을 받은 의사도 정확도가 14.0%포인트 낮았습니다 (PMID 42932681). 세 갈림길은 각각 다른 연구에서 잰 것이라, 한 의사에게서 셋이 함께 일어날 때 어떻게 겹치는지는 아직 측정되지 않았습니다.
결과는 AI의 정답률만큼이나, 의사가 AI에게 무엇을 묻고 그 답을 어떻게 받아들이느냐에서 갈립니다.
검진실에서 일어난 일
스웨덴 남서부의 유방촬영 검진소 네 곳에서는 2021년 4월부터 2022년 12월까지 검진 대상 여성 105,934명이 무작위로 두 갈래에 배정됐습니다 (PMID 39904652). 한 갈래는 표준대로 영상의학과 의사 두 명이 읽었고, 다른 갈래에서는 한 여성의 영상이 찍히면 AI가 먼저 1에서 10까지 열 단계의 위험 점수를 매겼습니다 (PMID 37541274). 1~9점이면 영상의학과 의사 한 명이, 가장 높은 10점이면 두 명이 읽었고, 8~10점인 영상에는 AI가 의심 부위를 표시해 주었습니다 (PMID 37541274). 점수는 모든 영상에서 판독하는 의사에게 보였습니다 (PMID 37541274). 이 AI는 영상을 읽는 프로그램으로, 앞에서 다룬 언어모델과는 다른 종류입니다. 이 시험이 MASAI입니다.
AI 보조 갈래에서 찾아낸 암은 1,000명당 6.4명으로 표준 갈래의 5.0명보다 많았고, 비율로는 1.29배였습니다 (PMID 39904652). 암이 아닌데 다시 불려 온 비율은 의미 있게 늘지 않았고, 의사가 읽은 판독 횟수는 44.2% 줄었습니다 (PMID 39904652). 더 찾아낸 암에는 주변 조직으로 퍼진 암과 함께, 아직 생긴 자리에 머문 초기 단계의 암도 있었습니다. 이런 암은 68건 대 45건이었고, 늘어난 몫의 절반가량은 악성도가 높은 쪽이었습니다 (PMID 39904652).
검진에서 더 찾아냈다는 것만으로는 이득을 말하기 어렵습니다. 검진이 놓친 암이 나중에 드러나는지를 봐야 합니다. 중간암(interval cancer)은 검진에서 이상이 없다고 본 뒤, 다음 검진이 오기 전에 진단되는 암입니다. MASAI의 1차 평가 결과인 중간암 비율은 1,000명당 AI 보조 갈래 1.55명, 표준 갈래 1.76명으로, 미리 정한 기준에 따라 AI 보조 검진이 열등하지 않았습니다 (PMID 41620232). 두 갈래의 비는 0.88이었고 신뢰구간은 0.65~1.18이었습니다 (PMID 41620232). 실제 암 가운데 검진에서 잡아낸 비율은 AI 보조 갈래 80.5%, 표준 갈래 73.8%였고, 암이 없는 사람을 정상으로 본 비율은 두 갈래 모두 98.5%였습니다 (PMID 41620232). 연구진은 AI 보조 유방촬영 검진을 실제 진료에 도입하는 것을 고려할 수 있다고 해석했습니다 (PMID 41620232).
스웨덴 여성 10만여 명을 무작위로 나눈 이 시험에서, AI가 판독을 나누고 의심 부위를 표시한 뒤 의사가 읽은 갈래는 더 많은 암을 찾고 의사의 판독량은 줄었으며 중간암 비율은 열등하지 않았습니다. 같은 근거를 두고 남은 한정어도 있습니다. 2015~2025년 문헌을 모은 메타분석은 무작위 시험 하나(MASAI)와 짝지은 전향 시험 둘, 세 편을 합친 암 발견 비가 1.13(신뢰구간 0.83~1.55)이었고, MASAI 하나만 보면 1.29(신뢰구간 1.09~1.51)였다고 적었습니다 (PMID 42793830). 같은 메타분석은 더 크고 정밀한 이득이 무작위 배정이 없는 연구에서 나왔으며 이는 교란이 만들어 낼 모양이라, 기준으로 삼을 것은 무작위 근거라고 적었습니다 (PMID 42793830). 이 메타분석은 10년의 근거가 AI를 조직된 검진의 두 번째 판독자이자 분류 도구로 쓰는 쪽을 받치고, 영상의학과 의사를 대신하는 자율 판독은 받치지 않는다고 결론지었습니다 (PMID 42793830). 이 메타분석은 2025년 말까지의 문헌을 모아 중간암과 사망 지표를 아직 기다리는 중이라고 적었는데, 앞의 MASAI 중간암 결과는 2026년에 나왔고, 사망 지표는 여전히 나오지 않았습니다 (PMID 42793830; PMID 41620232). 대장내시경에서도 이득과 한정어가 나란히 있습니다. 선종은 암으로 자랄 수 있는 용종인데, 대조군의 선종 발견 수준이 이미 높은 무작위 시험들을 모은 메타분석에서 AI의 병변 표시는 놓치는 선종을 절반 가까이 줄였고(6편 합산 0.473배), 선종을 하나 이상 찾아낸 검사의 비율을 28편 합산 1.137배로 올렸지만, 진행된 선종을 더 찾는 이득은 통계적으로 확인되지 않았습니다 (PMID 43050091).
AI가 실제 사람을 대상으로 한 무작위 시험에서 이득을 보인 자리는, 영상 속 병변을 찾는 일처럼 범위가 좁고 정답의 경계가 분명한 일이었습니다. 2026년의 한 종설도 가장 믿을 만한 진전은 끝점이 분명하고 좁게 정의된 과제에서 일어난다고 정리했습니다 (PMID 42825240).
기계가 꺼진 날
폴란드의 내시경 센터 네 곳은 2021년 말 대장 용종을 찾는 AI를 들였고, 이후 검사 날짜에 따라 AI를 켜고 하는 대장내시경과 끄고 하는 대장내시경이 무작위로 정해졌습니다 (PMID 40816301). 연구진은 AI를 들이기 전 3개월과 들인 뒤 3개월 동안 AI 없이 대장내시경을 받은 환자 1,443명의 기록을 되짚어 봤습니다 (PMID 40816301). 선종을 하나 이상 찾아낸 비율은 AI 도입 전 28.4%(795명 중 226명)에서 도입 뒤 22.4%(648명 중 145명)로 떨어졌습니다 (PMID 40816301). 연구진은 AI에 계속 노출되면 AI 없이 하는 검사의 성적이 떨어질 수 있고, 이는 내시경 의사의 행동에 미치는 부정적 영향을 시사한다고 해석했습니다 (PMID 40816301).
이 현상에는 이름이 있습니다. 탈숙련(deskilling)은 자동화에 기대는 사이에 사람이 원래 갖고 있던 기술이 무뎌지는 일입니다. 다만 폴란드 연구는 이미 일어난 일을 되짚어 본 관찰 연구이고, 관찰 연구는 무작위 배정이 없어 원인을 확정하지 못합니다. AI가 의사의 성적을 떨어뜨릴 수 있다는 근거를 검토한 2026년의 한 종설은, 그 근거가 단일 연구이거나 설계에 한계가 있는 연구에서 나왔고 효과가 얼마나 크고 오래가는지는 밝혀지지 않았다고 적었습니다 (PMID 42984954).
탈숙련은 이미 기술을 가진 의사의 이야기입니다. 수련 초기부터 AI에 기대는 의사는 그 기술을 처음부터 갖추지 못할 수 있다는 우려도 제기됐지만, 이 관점을 낸 저자들 스스로 의학 수련에서 나온 직접 근거는 아직 없다고 밝혔습니다 (PMID 42174254). AI가 켜진 상태의 의사 성적과 꺼진 상태의 의사 성적은 서로 다른 숫자입니다.
환자 앞에 선 AI, 그리고 아직 모르는 것
환자와 직접 대화하며 진단에 이르도록 만든 언어모델 기반 AI(AMIE)는, 실제 환자 앞에 서기 전에 환자 역할을 맡은 배우와 글로 대화하는 시험을 먼저 거쳤습니다 (PMID 40205050). 캐나다·영국·인도에서 모은 사례 159개로 1차 진료 의사 20명과 견준 무작위 이중맹검 교차 연구에서, 이 AI는 진단 정확도가 더 높았고 전문의가 평가한 32개 항목 중 30개에서 앞섰습니다 (PMID 40205050). 저자들은 의사들이 진료에서 익숙하지 않은 실시간 문자 대화로 상담했다는 한계를 적고, 결과를 조심해서 해석해야 한다고 밝혔습니다 (PMID 40205050).
그다음 단계에서, 응급 1차 진료 예약을 잡은 환자 98명이 진료 최대 닷새 전에 같은 AI와 증상을 주고받은 뒤 의사를 만났습니다 (PMID 42849491). 한 기관에서 대조군 없이 진행한 이 전향 연구에서, 의사 안전 감독자가 모든 대화를 지켜봤고 미리 정한 기준에 따라 대화를 멈춰야 했던 경우는 한 번도 없었습니다 (PMID 42849491). 감독자는 사실과 다른 내용을 지어낸 경우 한 번을 기록했고, 다섯 번은 임상 정보를 보탰습니다 (PMID 42849491). 1차 진료 의사가 대화 기록을 미리 읽은 44건 가운데 33건에서 의사는 진료 준비에 도움이 됐다고 답했습니다 (PMID 42849491). 연구비는 Alphabet이 댔고, 연구진은 이 결과를 감독 아래에서 대화의 안전성과 질, 사용자 수용성을 확인한 첫 단계로 규정하며 추가 연구가 필요하다고 적었습니다 (PMID 42849491). 이 연구가 1차 결과로 삼은 것은 대화의 안전, 대화의 질, 환자와 의사의 경험이었고, 진단 정확도는 그 목록에 없었습니다 (PMID 42849491).
진료실 전체를 놓고 보면 측정된 것보다 측정되지 않은 것이 많습니다. 2026년의 한 종설은 최신 언어모델이 모의 진단 추론 과제에서 의사와 비슷하거나 앞서는 성적을 낸다고 정리하면서도, 미국 식품의약국이 허가한 AI·기계학습 기기 가운데 동료 심사를 거친 평가를 받은 것이 5%도 안 되고, 전향적 무작위 시험은 여전히 드물다고 정리했습니다 (PMID 42825240). 같은 종설은 최신 모델들이 자기 답을 얼마나 확신해야 하는지 가늠하는 데서 계속 실패하고, 사람과 AI의 협업은 아직 최적에 못 미치며, 자동화 편향과 탈숙련의 위험이 드러나고 있다고 적었습니다 (PMID 42825240). 한 저자가 고른 1차 연구 9편을 검토한 종설은, 열린 진단 추론에서 의사가 AI를 쓸 때와 안 쓸 때를 견준 무작위 시험이 그중 사례 문제를 쓴 한 편뿐이었다고 평가했습니다 (PMID 42984954).
문제지 점수가 높아도 그 한계는 남습니다. 어려운 사례를 일부러 많이 넣은 응급실 맹장염 사례 문제 150개에서, 가장 높은 AI 시스템은 95.3%를 맞혀 외과 전문의 합의의 92.7%를 조금 넘었고, 웹 검색을 붙인 시스템에서는 검색이 불러온 지어낸 답이라는 고유한 실패도 관찰됐습니다 (PMID 42500998). 이 연구의 저자들은 사례 문제 기반 비교를 진료에 쓸 준비가 됐다는 근거로 해석해서는 안 되고, 응급 분류를 AI 혼자 맡기기보다 감독 아래에서 진단별로 평가해야 한다고 적었습니다 (PMID 42500998). 한 종설은 AI 모델의 정확도만으로는 이득을 추론할 수 없고, AI를 쓴 의사와 쓰지 않은 의사의 성적을 직접 재야 한다고 결론지었습니다 (PMID 42984954).
처음의 질문으로 돌아가면, 답은 질문을 둘로 나눌 때 보입니다. AI가 문제지에서 의사보다 높은 점수를 받는가에는 일부 벤치마크와 사례 문제 시험이 그렇다고 답하지만, 연구를 모은 메타분석에서는 둘이 뚜렷이 갈리지 않았습니다. AI를 들인 검진실에서 암을 더 잘 찾는가에는 유방촬영 검진의 무작위 시험 하나가 그렇다고 답합니다. 그 검진이 사망까지 줄이는지, 그리고 넓은 진료실에서 환자가 더 정확한 진단을 받는지는 아직 측정을 기다립니다. AI 혼자의 점수, AI를 쓰는 의사의 점수, 기계가 꺼졌을 때 의사의 점수는 서로 다른 세 숫자이고, 진료실의 답은 그 셋을 모두 재야 나옵니다.
어디를 더 볼까
시험장의 점수가 시험장 밖에서 어떻게 무너지는지는 「AI의 오류 — 시험장 밖에서 틀리는 수험생」이 이어서 다룹니다. 언어모델이 무엇을 훈련받아 어떻게 문장을 만드는지는 「다음 낱말을 맞히는 훈련이 어떻게 대화가 되는가 — 언어모델을 읽기 위한 최소 토대」에서 바닥부터 볼 수 있습니다. 검진에서 잡아낸 비율과 정상으로 본 비율이 무엇을 말해 주는지는 「검사는 무엇을 말해 주나 — 민감도·특이도와 사전확률 입문」, AI 검진이 더 찾아낸 초기 단계의 암이 늘 이득인지는 「일찍 찾으면 늘 좋은가 — 과진단 입문」이 이어집니다. 이 글이 기댄 시험 설계의 힘과 한계는 「무작위 대조시험은 정말 '황금표준'인가」에서 따로 다룹니다.
근거 논문
- "Sequential diagnosis with language models." (2026) — PMID 42912144 — 순차 진단 벤치마크에서 AI 시스템 83.2%(NEJM 증례)·80.3%(MIMIC-IV-ED) vs 일반의 36.1·46.8%, 저자 스스로 통제된 벤치마크 설정이라 명시.
- "Knowledge-Practice Performance Gap in Clinical Large Language Models: Systematic Review of 39 Benchmarks." (2025) — PMID 41325597 — 지식 시험 84~90% vs 실무형 45~69%, 진단 45~55%·안전 40~50%, 시험 점수는 불충분하고 오해를 부르는 대리 지표.
- "Large Language Model Performance and Clinical Reasoning Tasks." (2026) — PMID 41973425 — 언어모델 21개·사례 29개, 최종 진단 실패율 0.40 미만 vs 감별진단 0.80 초과.
- "Independent and collaborative performance of large language models and healthcare professionals in diagnosis and triage." (2026) — PMID 41652180 — 50편 메타분석, 언어모델/의료인 첫 진단 0.89·열 개 1.17, 언어모델 도움 받은 의료인 첫 진단 1.13배(1.00~1.27)·세 번째까지 1.11배(1.01~1.23), 실제 환경 평가 필요.
- "Comparing Diagnostic Accuracy of Clinical Professionals and Large Language Models: Systematic Review and Meta-Analysis." (2025) — PMID 40279517 — 30편·4,762사례, 다수가 치우침 위험 높음(주 원인: 이미 진단이 알려진 증례), 정확도는 아직 의료인에 못 미침.
- "Large Language Model Influence on Diagnostic Reasoning: A Randomized Clinical Trial." (2024) — PMID 39466245 — 미국 의사 50명 무작위, 76% vs 74%(차이 2%p, 의미 없음), 탐색적 분석에서 언어모델 혼자 +16%p(2~30).
- "Influence of a Large Language Model on Diagnostic Reasoning: A Randomized Clinical Vignette Study." (2024) — PMID 38559045 — 같은 시험의 프리프린트, 사용 모델 GPT-4·60분·사례 최대 6개.
- "Human-AI collaboration in clinical reasoning: a UK replication and interaction analysis." (2026) — PMID 42053372 — 영국 의사 22명, 언어모델 사용 시 74.3 vs 65.7%, 언어모델 혼자가 21.3%p 높음, 질문의 30%만 직접 물음, 훈련·설계 필요.
- "GPT-4 assistance for improvement of physician performance on patient care tasks: a randomized controlled trial." (2025) — PMID 39910272 — 의사 92명·모의 설정 사례 5개 관리 추론, GPT-4 사용 +6.5%, 사례당 119.3초 더, GPT-4 혼자와 차이 없음.
- "Towards accurate differential diagnosis with large language models." (2025) — PMID 40205049 — 의사 20명·증례 302개, 도움 받은 의사 후보 열 개 정답률 51.7% vs 무도움 36.1%·검색 44.4%, 모델 혼자 59.1%.
- "Human-large language model collaboration in clinical medicine: a systematic review and meta-analysis." (2026) — PMID 41606089 — 10편, 진단 정확도 연구 2편이라 불확실, 세 집단 비교에서 사람+AI가 AI 혼자보다 늘 낫지 않음.
- "Automation Bias in Large Language Model-Assisted Diagnostic Reasoning among Physicians Trained in AI Literacy - A Randomized Clinical Trial." (2026) — PMID 42932681 — 파키스탄 의사 44명(AI 교육 20시간), 오류 제안 집단 73.3% vs 84.9%(−14.0%p), 첫 진단 76.1 vs 90.5%, 상당한 자동화 편향.
- "Artificial intelligence suppression as a strategy to mitigate artificial intelligence automation bias." (2023) — PMID 37561535 — 의사 40명·무릎 MRI 200건, 정확도 87.2→96.4%, 남은 실수의 45.5%가 자동화 편향, 경력 무관.
- "Automation Bias in AI-Decision Support: Results from an Empirical Study." (2024) — PMID 39234734 — 210명 상처 진단, 체감 유용성↑ → 틀린 동의↑, 비전문가가 가장 취약.
- "The effect of medical explanations from large language models on diagnostic accuracy in radiology." (2026) — PMID 42026140 — 영상의학과 2,020회 평가, 단계별 추론 설명이 무도움 대비 +12.2%, 통제된 사례 문제 설정.
- "Rams, hounds and white boxes: Investigating human-AI collaboration protocols in medical diagnosis." (2023) — PMID 36990586 — 무릎 MRI 12명·심전도 44명, 설명이 효과 없거나 해로운 「화이트박스 역설」, AI 먼저 보여 준 순서가 정확도 높음.
- "Screening performance and characteristics of breast cancer detected in the Mammography Screening with Artificial Intelligence trial (MASAI)..." (2025) — PMID 39904652 — 스웨덴 105,934명 무작위, 암 발견 6.4 vs 5.0/1000(1.29배), 위양성 유의한 증가 없음, 판독량 44.2%↓, 제자리에 머문 초기 암 68 vs 45.
- "Artificial intelligence-supported screen reading versus standard double reading in the MASAI..." (2023) — PMID 37541274 — 안전성 중간 분석, AI 위험 점수로 1인/2인 판독 분류·의심 부위 표시.
- "Interval cancer, sensitivity, and specificity comparing AI-supported mammography screening with standard double reading without AI in the MASAI study..." (2026) — PMID 41620232 — 중간암 1.55 vs 1.76/1000 비열등(0.88, 0.65~1.18), 민감도 80.5 vs 73.8%, 특이도 98.5% 동일, 도입 고려 가능.
- "Ten Years of Artificial Intelligence in Screening Mammography: A Systematic Review and Meta-Analysis..." (2026) — PMID 42793830 — 무작위·짝 전향 3편 합산 1.13(0.83~1.55), MASAI 단독 1.29(1.09~1.51), 큰 이득은 비무작위 연구(교란 패턴)라 무작위 근거가 기준, 대체가 아닌 두 번째 판독자, 2025년 말까지 문헌 기준 중간암·사망 지표 대기.
- "Does computer-aided detection still add value in high-performing colonoscopy?..." (2026) — PMID 43050091 — 무작위 시험 28편 선종 발견 1.137배, 발견율 높은 곳에서 진행 선종 이득 미확인.
- "State of clinical AI in 2026." (2026) — PMID 42825240 — FDA 허가 AI 기기 중 동료 심사 평가 5% 미만, 전향 RCT 드묾, 확신 보정 실패, 협업 미흡, 좁은 과제에서 가장 믿을 만한 진전.
- "Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: a multicentre, observational study." (2025) — PMID 40816301 — 폴란드 4개 센터 관찰, AI 없이 한 검사의 선종 발견 비율 28.4→22.4%, 부정적 영향 시사.
- "Augmentation or erosion? Artificial intelligence and the transformation of clinical reasoning: a critical narrative review." (2026) — PMID 42984954 — 열린 진단 추론의 무작위 시험은 사례 문제 1편, 해의 근거는 단일·설계 한계 연구, 모델 정확도로 이득 추론 불가·직접 측정 필요.
- "AI-induced never-skilling in medical education." (2026) — PMID 42174254 — 수련의의 「처음부터 못 익힘」 우려, 의학 수련의 직접 근거는 없음.
- "Conversational diagnostic artificial intelligence in ambulatory primary care: a prospective feasibility study." (2026) — PMID 42849491 — 단일 기관·단일군 환자 98명, 안전 정지 0, 지어낸 내용 1회, 대화 기록을 미리 읽은 44건 중 33건에서 도움, Alphabet 연구비, 추가 연구 필요.
- "Diagnostic Ambiguity in Appendicitis: Comparing Failure Modes of Large Language Models and Surgeons." (2026) — PMID 42500998 — 사례 문제 기반 비교를 진료 준비의 근거로 해석해선 안 된다.
- "Effect of Human-AI Interaction on Detection of Malignant Lung Nodules on Chest Radiographs." (2023) — PMID 37367443 — 판독자 30명·흉부 엑스선 120장, 고정확 AI가 성적을 더 올리고 AI 제안을 따라 바꾼 비율도 67% vs 59%로 높음.
- "Comparison of AI-integrated pathways with human-AI interaction in population mammographic screening for breast cancer." (2024) — PMID 39214982 — 호주 자료 모의 실험, 자동화 편향은 다중 판독 체계에선 성적↓, 단독 판독자에선 성적↑.
- "Towards conversational diagnostic artificial intelligence." (2025) — PMID 40205050 — 환자 배우와 문자 상담, 사례 159개·1차 진료 의사 20명, AMIE가 진단 정확도 높고 32개 중 30개 항목 우세, 익숙하지 않은 문자 채팅이라는 한계.