Paperis 아티클
AI가 쓴 문장 — 읽는 사람이 걸려 넘어지던 자리
한 프리프린트가 AI 모델 14종(상황마다 9~14종)의 영어 글에서, 사람의 처리 부담과 이어진다고 심리언어학 실험들이 보고한 문장의 꼴을 셌다. 큰 모델 대부분이 뜻을 고정한 바꿔 쓰기(왕복 번역)보다 그 꼴을 더 자주 썼고, 학생 에세이와 견주면 9종 모두가 사물 주어에 붙은 사람 동사와 드문 낱말 짝을 더 썼다. 사람의 읽기 속도나 이해도는 재지 않았다. 원인으로 든 「수학·코딩·추론 학습이 낳는 압축 압력」은 저자들의 가설이고, 작은 모델에 길이 벌점을 건 실험은 그 개념 증명이다.
AI가 쓴 문장 — 읽는 사람이 걸려 넘어지던 자리
저자들이 맨 앞에 놓은 한 문장
Your instinct is right; the convoluted sentence you are currently reading is quietly eating its own reader-patience budget — footnote it.
우리말로 옮기면 대략 이렇습니다. 「직감이 맞아요. 지금 읽고 있는 이 꼬인 문장은 제 독자 인내심 예산을 조용히 먹어 치우는 중이니, 각주로 돌리세요.」
이 문장은 2026년 10월 21일 논문 공개 서버 arXiv에 올라온 한 논문의 첫 줄입니다. 제목은 「AI가 만든 말은 왜 이렇게 알아듣기 어려운가」입니다. 저자는 뉴욕대학교의 토머스 히카루 클라크, 텍사스대학교 오스틴의 마티아스 마틴과 카일 마호월드 세 사람입니다. 아직 동료 심사를 거치지 않은 단일 프리프린트입니다 (arXiv:2610.29162).
저자들은 이 문장을 시범으로 놓고, 이런 문장을 어디선가 보면 요즘 AI 모델이 썼다고 의심할 만하다고 적습니다. 문장 안에는 가장 앞선 AI 모델의 글에 유난히 자주 나오는 꼴이 넷 들어 있습니다. 명사 footnote를 동사로 썼고, 사물인 문장을 「먹는다」의 주어로 세웠고, reader-patience budget처럼 명사를 줄줄이 붙였고, 꾸미는 절 앞의 that을 뺐습니다. 저자들은 이 꼴이 모두 읽기 부담과 이어진다고 적습니다 (arXiv:2610.29162).
출발점은 AI 글이 요즘 더 알아듣기 어려워졌다는, 널리 퍼진 느낌입니다 (arXiv:2610.29162). 저자들은 그 느낌을 직접 재는 대신 다른 길을 골랐습니다. 먼저 심리언어학, 곧 사람이 말을 알아듣고 만들어 내는 과정을 실험으로 재는 분야에서 읽기 부담과 이어진다고 알려진 문장의 꼴을 골랐습니다. 그다음 AI 모델 14종(큰 모델 9종과 작은 공개 모델 5종)이 쓴 글에서 그 꼴이 얼마나 자주 나오는지 셌습니다 (arXiv:2610.29162).
이 논문은 문장의 꼴을 셌고, 사람이 그 글을 읽는 속도나 이해도는 재지 않았습니다. 그래서 이 글은 고리 둘을 따로 놓습니다. 하나는 그 꼴이 사람에게 부담이라는 근거이고, 다른 하나는 AI가 그 꼴을 더 자주 쓴다는 근거입니다. 논문은 영어 글만 다룹니다. 이 글에 나오는 한국어 예문은 이해를 도우려고 지은 것입니다.
사람이 읽다 느려지는 자리
계약서는 왜 읽기 어려울까요. 한 연구가 약 1,000만 낱말 규모의 말뭉치로 계약서를 영어의 다른 아홉 장르와 견주었습니다. 계약서에는 드문 전문용어, 절 한가운데에 다른 절을 끼워 넣은 문장, 수동태, 들쭉날쭉한 대문자가 유난히 많았습니다. 이어진 두 실험(184명)에서는 이런 꼴이 든 대목을 사람들이 덜 기억했고 덜 이해했습니다. 경험 많은 독자도 그랬고, 절을 한가운데 끼워 넣은 문장이 기억을 가장 크게 떨어뜨렸습니다 (PMID 35257980). 저자들은 그 어려움이 법률 지식이 모자라서라기보다, 멀리 떨어진 말을 이어야 하는 작업 기억의 한계에서 주로 온다고 결론 내립니다 (PMID 35257980). 계약서가 어려운 까닭의 큰 몫이 내용보다 문장의 꼴에 있다는 뜻입니다.
「멀리 떨어진 말」에는 이름이 있습니다. 의존 거리(dependency length)는 문법으로 이어진 두 낱말, 예컨대 주어와 그 동사가 문장 안에서 몇 낱말이나 떨어져 있는가입니다. 예를 들어 이런 문장입니다(이 글에서 지은 예시). 「민수가 지난주 회의에서 모두가 반대했던 그 계획을 어제 다시 꺼냈습니다.」 「민수가」와 「꺼냈습니다」 사이에 여덟 덩이가 끼어 있습니다. (뜻을 보이려고 지은 예입니다. 한국어는 동사가 끝에 와서 주어와 동사 사이가 원래 벌어지기 쉽고, 아래 실험들은 영어 문장을 다뤘습니다.)
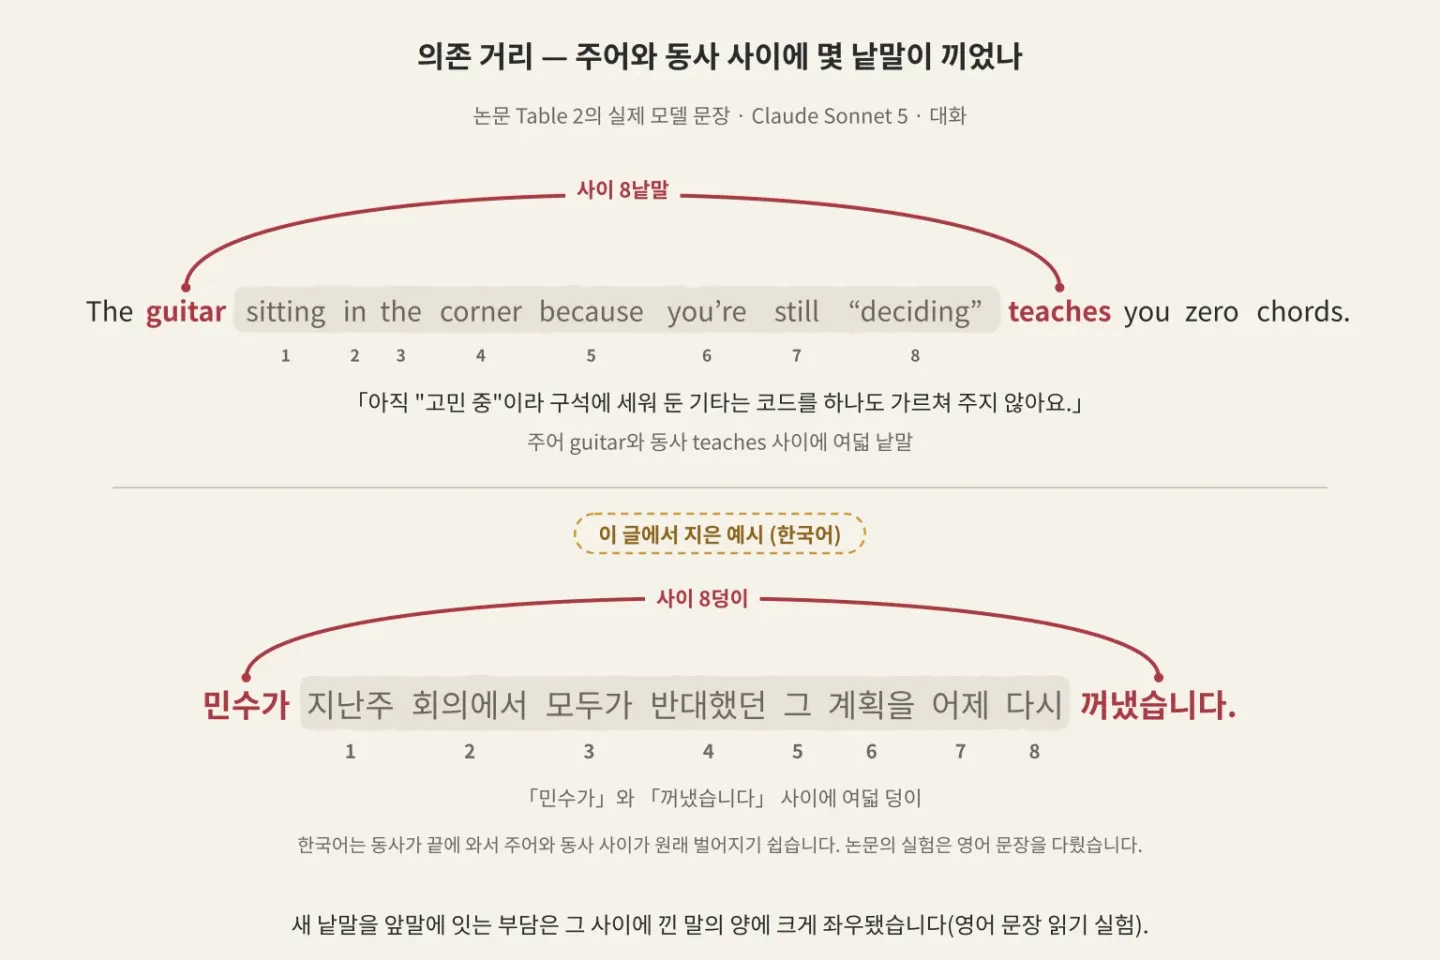
그림: Paperis가 그린 도식. 영어 문장은 Clark·Martin·Mahowald, arXiv:2610.29162, Table 2(CC BY 4.0), 한국어 문장은 이 글에서 지은 예시
영어 문장을 한 낱말씩 스스로 넘기며 읽게 한 실험에서, 새 낱말을 앞말에 잇는 데 드는 부담은 그 사이에 낀 말의 양에 크게 좌우됐습니다 (PMID 21702774). 사람이 실제로 쓰고 말한 문장을 37개 언어에서 분석하면, 의존 거리는 모든 언어에서 낱말을 무작위로 섞은 배치보다 짧았습니다 (PMID 26240370). 사람은 이어진 말을 대개 가까이 둔다는 뜻입니다.
두 번째 걸림돌은 예상하지 못한 낱말입니다. 놀라움(surprisal)은 앞에 나온 말을 보고 다음 낱말을 얼마나 예상하지 못했는지를 나타낸 값입니다. 덜 예상되는 낱말일수록 읽는 데 오래 걸린다는 관계는 다섯 어족 11개 언어의 읽기 자료에서 확인됐습니다 (arXiv:2307.03667). 저자들은 사람 글 자료에 없는 낱말 짝을, 독자가 예상하기 어려운 자리의 대리 지표로 셉니다 (arXiv:2610.29162).
세 번째는 명사를 줄줄이 붙이는 꼴입니다. 명사 쌓기(stacked noun compound)는 명사 셋 이상을 줄줄이 붙여 앞의 명사들이 맨 뒤 명사를 꾸미게 하는 표현입니다. 영어에서는 명사가 다른 명사를 꾸밀 수 있어서, 아주 구체적인 뜻을 짧게 담을 수 있습니다. 대신 어디까지가 한 덩이인지 헷갈리기 쉽습니다. 저자들이 드는 옛 신문 제목 「Squad Helps Dog Bite Victim」은 「경찰대가 개에게 물린 피해자를 돕다」로도, 「경찰대가 개를 도와 피해자를 물게 하다」로도 읽힙니다. 저자들이 정리한 선행 연구에서 이런 쌓기는 읽기를 방해했습니다 (arXiv:2610.29162). 명사 둘만 새로 붙여도 걸릴 수 있습니다. 눈 움직임을 잰 세 실험에서, 따로 떼어 놓으면 뜻을 풀기 어려운 새 조합 「dictionary treatment」는 풀기 쉬운 「torture treatment」보다 뒤 명사 treatment에 처음 머무는 시간이 길었습니다. 앞 문장이 풀이를 미리 귀띔해도 그 도움은 더 늦은 단계에서야 나타났습니다 (PMID 23697393). 이 실험은 두 명사 조합을 다뤘고, 이 논문이 센 것은 셋 이상 쌓은 꼴입니다.
저자들이 고른 꼴은 셋이 더 있습니다. 첫째는 명사를 그대로 동사로 쓰는 꼴입니다. Claude Fable 5가 대화에서 쓴 「So yes — calendar it.」(「그러니까 네, 그거 캘린더 해 두세요.」)처럼 calendar를 동사로 씁니다. 독자는 이런 새 쓰임을 알아듣지만, 품사가 바뀌는 자리에서 문장 구조를 다시 따지게 된다는 연구가 있습니다 (arXiv:2610.29162).
둘째는 사람이나 동물에게 쓰는 동사를 사물 주어에 붙이는 꼴입니다. Claude Opus 5가 대화에서 쓴 「The whole conversation is eating its own tail.」(「대화 전체가 제 꼬리를 먹고 있어요.」)이 그 예입니다. 독자는 문장을 풀 때 주어가 살아 있는 것인지를 단서로 씁니다. 앞뒤 맥락 없이 이 단서가 어긋나면, 뇌파에 문장을 다시 분석할 때 나타나는 반응이 생길 수 있습니다 (arXiv:2610.29162).
셋째는 목적어 자리 꾸밈절, 특히 앞의 that을 뺀 꼴입니다. 「the book that the professor wrote」(교수가 쓴 책)를 「the book the professor wrote」로 쓰는 식입니다. 꾸밈을 받는 명사가 절 안에서 목적어 자리에 있는 절은 주어 자리에 있는 절보다 처리하기 어렵다고 알려져 있고, 꾸밈을 받는 명사가 사물이거나 흔한 꼴이면 그 차이가 줄어듭니다 (arXiv:2610.29162). that을 빼는 것 자체가 부담을 더한다는 실험은 저자들도 들지 않았습니다. 저자들은 that 생략을, 생략할 수 있는 낱말을 건너뛴 압축의 흔적으로 봅니다 (arXiv:2610.29162).
이 꼴들은 하나하나 영어 문법에 맞습니다. 사람의 처리 부담과 이어진다는 근거의 세기는 꼴마다 다릅니다. 의존 거리와 예상하기 어려운 낱말은 읽기 시간을 잰 실험이 받칩니다. 명사 쌓기에는 명사 둘짜리 새 조합을 다룬 눈 움직임 실험이 있습니다. 명사를 동사로 쓰는 꼴과 사물 주어는 뇌파 연구에 기대고, 사물 주어는 부담이 「생길 수 있다」는 수준입니다. that을 빼는 것 자체가 부담을 더한다는 실험은 없고, 저자들은 이것을 압축의 흔적으로 봅니다. 적어도 의존 거리에서는, 사람이 쓴 글이 그 부담을 줄이는 쪽으로 기울어 있습니다.
무엇을 무엇과 견주었나
연구진은 AI 모델 14종에게 글을 쓰게 했습니다. 그중 9종은 지금 가장 앞선 등급이거나 그 바로 아래 등급의 큰 모델입니다. Anthropic의 Claude 넷(Sonnet 5, Opus 5, Opus 5.5, Fable 5), OpenAI의 GPT-5.6 셋(Luna, Terra, Sol), 그리고 가중치를 공개한 GLM-5와 Kimi K2.5입니다. 나머지 5종은 훨씬 작은 공개 모델로, 학습 단계가 서로 다른 판을 골랐습니다. Llama 3.1 8B의 기본판과 지시판, Olmo 3 7B의 기본판·지시판·추론판입니다. 모든 모델이 모든 상황에 들어간 것은 아닙니다. 에세이는 14종 모두, 대화는 기본판 둘을 뺀 12종, 코딩은 큰 모델 9종만 썼습니다 (arXiv:2610.29162). 기본판은 사람 글을 배우는 첫 학습만 마친 판이고, 지시판은 거기에 대화하도록 다듬는 학습을 더한 판이고, 추론판은 답하기 전에 생각을 길게 늘어놓도록 더 학습한 판입니다.
글을 쓴 상황은 셋입니다. 첫째는 대화입니다. 「마흔에 기타를 배우는 건 바보 같은 생각일까」 같은 첫마디 10가지로 시작해 최대 12번 주고받았고(120번 중 113번이 12번을 채웠습니다), 모델 12종이 120번의 대화를 했습니다. 사람 쪽 말은 다른 AI 모델(Claude Sonnet 4.6)이 사람 흉내를 내며 썼습니다. 둘째는 코딩입니다. 큰 모델 9종이 공개된 파이썬 프로그램 5개에서 버그를 찾아 고쳤고, 분석에는 모델이 사람에게 한 말만 들어갔습니다. 셋째는 에세이입니다. 미국 학생 글쓰기 자료집의 과제 7개(학교 휴대전화 규정 등)에 모델마다 10편씩, 모두 980편을 썼습니다 (arXiv:2610.29162).
비교 대상은 둘입니다. 하나는 장르를 대략 맞춘 사람 글입니다. 대화에는 영화·TV 자막을, 코딩에는 프로그래머 질의응답 사이트 StackExchange의 글을 댔습니다. 에세이에는 같은 과제로 미국 6~12학년 학생이 쓴 글 가운데 6점 만점에 5~6점을 받은 2,934편을 댔습니다. 위키백과도 함께 견주었습니다 (arXiv:2610.29162).
다른 하나는 같은 뜻의 다른 표현입니다. 왕복 번역(round-trip translation)은 글을 다른 언어로 옮겼다가 다시 원래 언어로 되돌려, 뜻은 그대로 두고 표현만 바꾸는 방법입니다. 연구진은 모델이 쓴 문장을 하나씩 번역 모델 NLLB-200으로 일본어에 옮겼다가 영어로 되돌렸습니다. 영어와 먼 언어를 거쳐야 표현이 더 다양하게 바뀌기 때문에 일본어를 골랐습니다 (arXiv:2610.29162).
왕복 번역이 기준선이 되는 이유는 이렇습니다. 뜻은 그대로인데 어떤 꼴이 왕복 뒤에 줄었다면, 모델은 같은 뜻을 담을 다른 표현이 있었는데도 그 꼴을 고른 것입니다 (arXiv:2610.29162). 한계도 있습니다. 번역은 원래 글을 흔한 꼴 쪽으로 고르고, 어휘와 문장 구조의 다양함을 줄이고, 글쓴이의 문체를 지웁니다 (arXiv:2610.29162). 왕복 번역본은 같은 뜻을 담은 더 밋밋한 기계 번역 글이고, 사람이 쓴 글과는 다른 기준선입니다.
꼴을 찾는 일은 모두 기계가 했습니다. 문장 구조 분석 프로그램이 의존 거리, 명사 쌓기, that을 뺀 절을 찾았습니다. 명사를 동사로 쓴 자리와 사물 주어 자리는 그 프로그램이 후보를 고르고 별도의 자동 분류기가 판정했습니다 (arXiv:2610.29162). 문장이 길면 의존 거리도 길어지기 쉬워서, 연구진은 의존 거리를 잴 때 문장 길이 분포를 위키백과에 맞춰 보정했습니다(30낱말 넘는 문장은 뺐습니다) (arXiv:2610.29162).
세어 보니
먼저 왕복 번역과 견준 결과입니다. 대화·코딩·에세이 세 상황 모두에서, 큰 모델 거의 전부가 왕복 번역본보다 드문 낱말 짝을 더 많이 썼습니다. 드문 낱말 짝은 사람 글 자료에 한 번도 나오지 않은 두 낱말 조합이고, 연구진은 사람 글로 만든 단순한 예측기로 평균 놀라움도 쟀습니다 (arXiv:2610.29162). 「Every behavioral test was verified red against the original source」는 이런 조합으로 꼽힌 문장으로, Opus 5가 코딩 세션 한 번에 네 번 썼습니다 (arXiv:2610.29162).
명사를 동사로 쓴 자리, 사물 주어에 사람 동사를 붙인 자리, that을 뺀 꾸밈절도 대체로 같은 방향이었습니다. 반대로 that을 넣은 꾸밈절은 모델 글에서 더 적었습니다. 저자들은 이를 생략할 수 있는 낱말을 건너뛰는 쪽을 택한 흔적으로 읽습니다 (arXiv:2610.29162). 명사 쌓기와 의존 거리도 대화와 코딩에서는 비슷한 방향이었습니다. 에세이에서는 달랐습니다. 의존 거리는 왕복 뒤에 그대로이거나 조금 길어졌고, 명사 쌓기는 두 모델에서만 뚜렷하게 달랐습니다 (arXiv:2610.29162).
왕복 번역 전후의 차이는 에세이에서 대화·코딩보다 대체로 작았습니다. 드문 낱말 짝, 의존 거리, 명사 쌓기, 명사를 동사로 쓴 자리가 그랬습니다. 저자들은 에세이가 한 번의 요청으로 끝나는 반면, 대화와 코딩은 여러 번 주고받기 때문일 수 있다고 봅니다. 길게 주고받는 대화가 압축을 더 부추길 수 있다는 것은 저자들의 추측입니다 (arXiv:2610.29162).
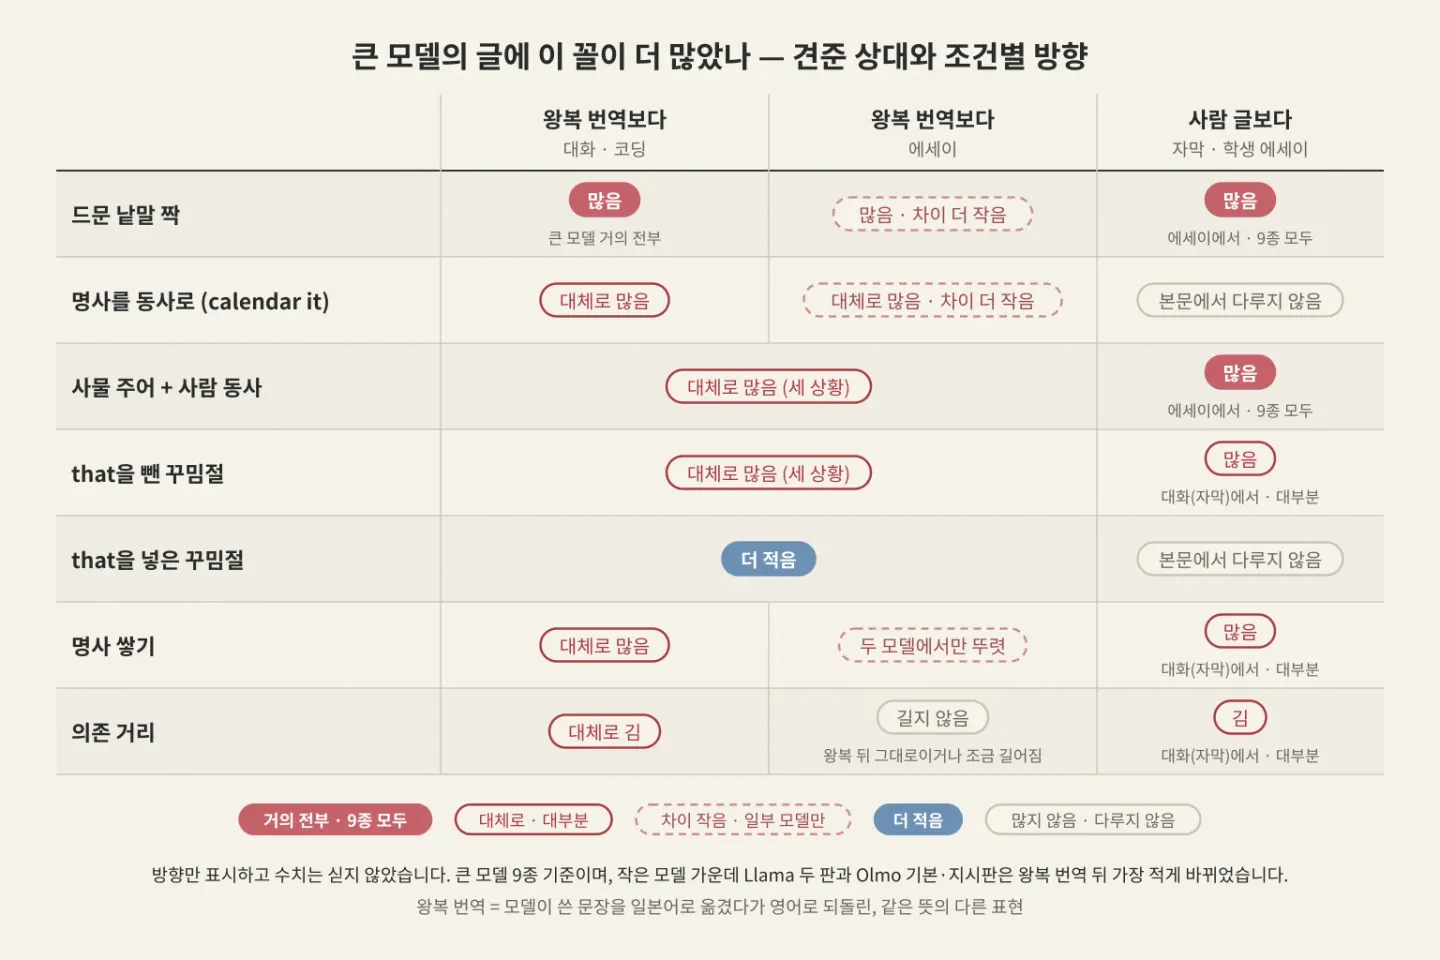
그림: Paperis가 논문(Clark·Martin·Mahowald, arXiv:2610.29162)의 결과 서술에서 방향만 옮겨 정리한 표
다음은 사람 글과 견준 결과입니다. 큰 모델 9종 모두가 사람 글보다 사물 주어에 사람 동사를 붙인 자리와 드문 낱말 짝을 더 많이 썼습니다 (arXiv:2610.29162). 이 두 꼴의 사람 비교는 학생 에세이와 맞댄 에세이 과제에서 나왔습니다. 대화와 코딩에서는 이 두 꼴을 사람 글과 견주지 않았기 때문입니다 (arXiv:2610.29162). 대화에서는 큰 모델 대부분이 영화·TV 자막보다 의존 거리가 길었고, 명사 쌓기와 that을 뺀 꾸밈절도 더 많았습니다 (arXiv:2610.29162).
모델마다 차이도 컸습니다. 작은 모델 가운데 Llama 두 판과 Olmo 기본판·지시판은 왕복 번역 뒤에 가장 적게 바뀌었고, 드문 낱말 짝과 동사 쓰임에서 학생 에세이와 가장 가까웠습니다. 그런데 같은 Olmo라도 추론판은 큰 모델들만큼 큰 차이를 보였습니다. Olmo 안에서는 기본판에서 지시판, 추론판으로 갈수록 차이가 커졌습니다 (arXiv:2610.29162). 같은 바탕 모델이라도 덧붙인 학습에 따라 꼴이 달라질 수 있음을 시사합니다. 다만 추론판은 다른 판과 달리 기본 지시문으로 돌았습니다 (arXiv:2610.29162).
같은 회사의 다음 판에서 줄어든 경우도 있었습니다. Claude Opus 5.5는 앞선 판 Opus 5보다 읽기 부담과 이어진 지표에서, 세 상황에 걸친 21개 비교 가운데 19개가 낮았습니다. 그중 8개는 95% 신뢰구간이 겹치지 않았습니다 (arXiv:2610.29162). 큰 모델 대부분에서 같은 방향이 나왔지만, 그 크기는 모델과 상황마다 달랐고 같은 회사 안에서도 줄어들 수 있었습니다.
짧게 쓰라는 압력 — 저자들의 가설
사람의 말은 소통에 맞춰 다듬어져 있다는 것이 심리언어학의 한 줄기입니다. 말하기 쉬운 것과 알아듣기 쉬운 것 사이에서 균형을 잡는다는 뜻이고, 앞에서 본 의존 거리 줄이기가 그 증거로 꼽힙니다 (arXiv:2610.29162)(PMID 26240370). 그렇다면 사람 글로 배운 모델도 사람 같은 꼴로 써야 합니다. 저자들은 그렇지 않은 까닭을 모델이 받는 학습의 다른 단계에서 찾습니다.
요즘 AI 모델은 사람 글을 배우는 데서 끝나지 않고, 그 뒤에 수학·코딩·추론 과제로 한 번 더 학습합니다. 이런 학습에 쓰이는 강화학습은 정답을 알려 주는 대신, 해 본 행동에 점수를 주고 점수가 커지는 쪽으로 행동을 고쳐 가게 하는 방식입니다. 저자들에 따르면 이런 학습에서 모델은 정답을 맞히면 점수를 받고, 그 답이 알아듣기 쉬웠는지로는 반드시 점수를 받지 않습니다 (arXiv:2610.29162).
저자들의 가설은 이렇습니다. 이런 목표로 학습하는 데다 모델이 한 번에 다룰 수 있는 글의 길이에도 한계가 있어서, 모델은 정보를 빽빽하게 압축하는 쪽으로 기웁니다. 그 압축이 알아듣기 쉬움과 부딪힌다는 것입니다 (arXiv:2610.29162). 수학·코딩·추론 학습이 압축을 부추겨 이런 꼴을 늘렸다는 것은 저자들의 가설이고, 큰 모델의 학습 과정에서 확인된 사실은 아닙니다. 저자들도 큰 모델을 학습 도중에 들여다볼 수 없어 대리 지표에 기댔다고 밝힙니다 (arXiv:2610.29162).
모델에게 쉬운 것과 사람에게 쉬운 것은 다릅니다. 사람의 기억은 앞말을 온전히 담아 두지 못하고, 흐려진 기억을 바탕으로 다음 말을 예상한다고 보는 처리 모형이 있습니다 (PMID 32100918). 반면 모델은 아주 긴 글 전체를 한꺼번에 볼 수 있습니다 (arXiv:2610.29162). 큰 모델일수록 사람의 읽기 시간을 덜 잘 맞히는데, 그 어긋남은 드문 낱말에서 가장 컸습니다. 큰 모델이 드문 낱말을 사람보다 지나치게 잘 예상했기 때문입니다 (arXiv:2402.02255). 모델이 보기에 놀랍지 않은 낱말이 사람에게는 놀라울 수 있다는 뜻입니다.
답에 이르는 추론 과정을 짧게 만드는 학습은 실제로 활발히 연구되고 있습니다. 토큰은 언어 모델이 글을 잘라 다루는 단위로, 낱말 하나일 때도 있고 낱말의 한 조각이나 문장부호일 때도 있습니다. 길이 벌점(length penalty)은 학습 중에 답이 길수록 점수를 깎아, 짧게 답하는 쪽으로 기울게 하는 장치입니다. 추론 모델이 생각을 너무 길게 늘어놓는 것을 줄이려고 이런 벌점을 거는 연구가 많습니다. 한 방법은 평균 토큰 사용을 50% 줄이면서 성능은 크게 떨어지지 않았고 (arXiv:2506.05256), 다른 방법은 추론 길이를 평균 60% 줄였습니다 (arXiv:2512.21540). 두 연구 모두 프리프린트이고, 길이와 정답률을 쟀을 뿐 문장이 읽기 쉬운지는 재지 않았습니다.
저자들은 사람이 매긴 순위로 모델을 다시 학습하는 방식과도 견줍니다. 그 방식에서는 오히려 긴 답이 점수를 더 받는 경향이 보고됐습니다. 그래서 저자들은 압축 압력이 정답을 기계가 채점하는 학습 쪽과 더 그럴듯하게 이어진다고 봅니다 (arXiv:2610.29162). 사람이 매긴 점수는 다른 버릇과 이어진다는 보고가 있습니다. 과학 논문 초록에 delve, intricate, underscore 같은 낱말이 최근 몇 해 사이 크게 늘었는데, 한 학회 논문은 이런 낱말 21개를 AI 사용의 흔적으로 꼽았습니다. 모델 비교 결과는 사람 점수 학습이 한몫했을 가능성과 들어맞았고, 사람 참가자 실험의 결과는 낱말마다 달랐습니다 (arXiv:2412.11385). delve는 낱말 하나의 빈도이고, 이 논문이 센 것은 문장 구조의 꼴입니다.
길이 벌점 실험
가설을 시험하려고 저자들은 앞의 큰 모델들보다 훨씬 작은 공개 모델 Qwen2.5-1.5B-Instruct 하나를 골랐습니다. 과제는 「누가, 무엇을, 누구에게」를 적은 짧은 사건 기록을 영어 문장 하나로 옮기는 일입니다 (arXiv:2610.29162). 예를 들어 「보낸 사람 he, 보낸 것 a photo, 받는 사람 us, 사건 send」를 받으면, 정답은 둘입니다.
He sent us a photo. (6토큰) He sent a photo to us. (7토큰)
뜻은 같고, 첫 문장이 한 토큰 짧습니다. 학습에 쓴 짝은 넷입니다. 위의 「us a photo / a photo to us」, 꾸밈절의 that 넣기와 빼기, 「knew (that) the answer was wrong」처럼 이어지는 절의 that 넣기와 빼기, 그리고 길이가 같은 대조용 짝 「picked up the book / picked the book up」입니다 (arXiv:2610.29162).
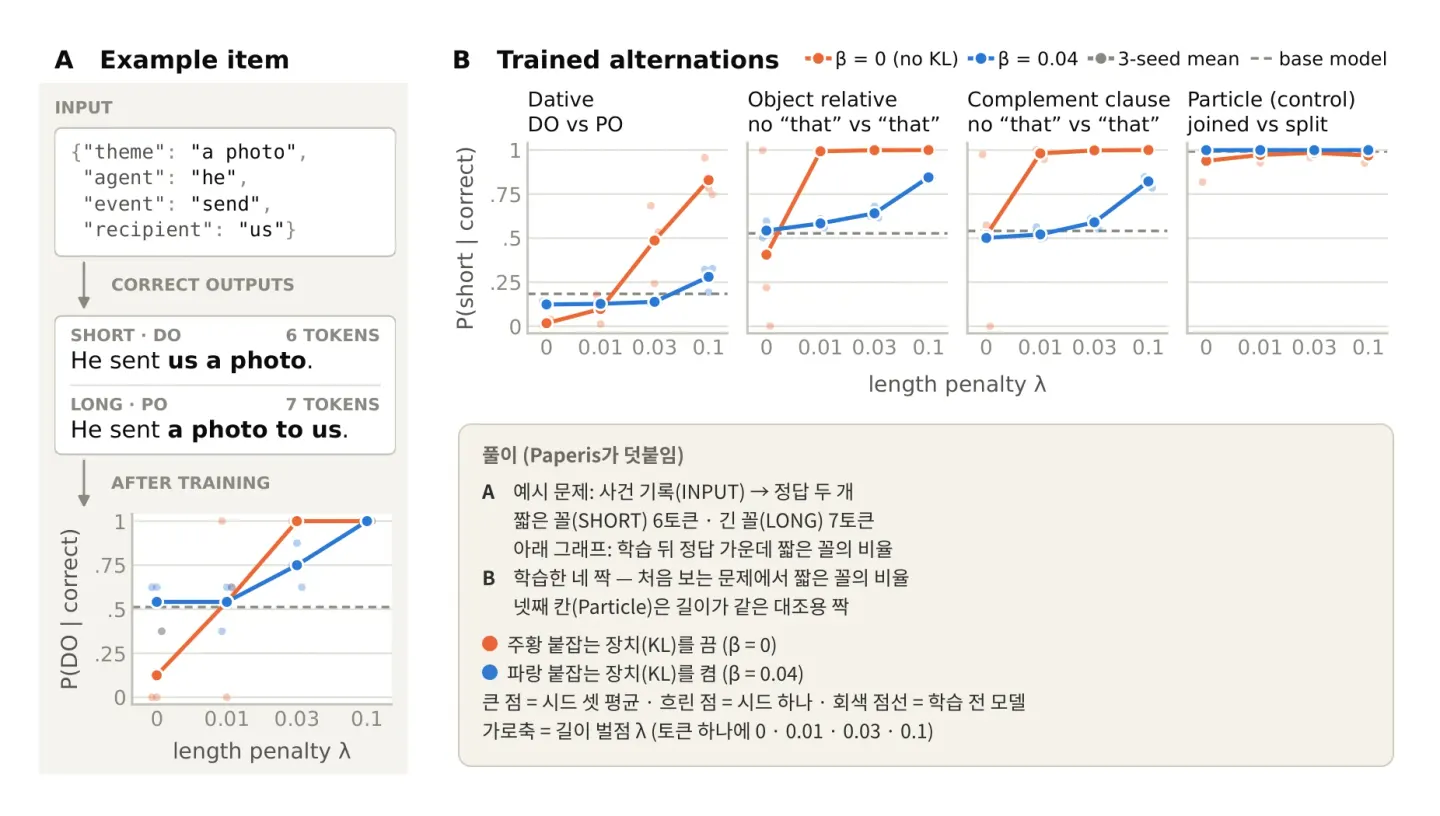
그림: Clark·Martin·Mahowald, arXiv:2610.29162, Figure 7 A·B, CC BY 4.0. 주황은 붙잡는 장치(KL)를 껐을 때(β = 0), 파랑은 켰을 때(β = 0.04). 풀이 상자는 Paperis가 덧붙임
연구진은 이 모델을 강화학습으로 다시 학습시키면서 앞에서 본 길이 벌점을 걸었습니다. 벌점 세기는 토큰 하나에 0, 0.01, 0.03, 0.1 네 가지였습니다. 모델이 원래 모습에서 너무 멀어지지 못하게 붙잡는 장치는 켠 경우와 끈 경우를 나눴고, 설정마다 무작위 설정(시드)을 세 번 바꿔 모두 24번 학습했습니다 (arXiv:2610.29162). 정답 판정은 두 꼴 모두 맞게 쳤습니다. 그래서 짧은 쪽을 고르든 긴 쪽을 고르든 과제는 똑같이 성공입니다 (arXiv:2610.29162).
벌점이 세질수록 짧은 꼴을 고르는 비율이 올라갔습니다. 붙잡는 장치를 켜도 올라갔고, 다만 더 천천히 올랐습니다. 장치를 끄고 벌점이 0이면 짧은 꼴의 비율이 시드에 따라 0%에서 100%까지 제각각이었습니다. 같은 조건에서 벌점이 조금이라도 있으면 시드 셋 모두 짧은 꼴 쪽으로 굳었습니다. 장치를 끈 경우, 학습한 두 that 짝에서는 벌점이 0보다 크기만 하면 짧은 꼴이 98%를 넘었습니다 (arXiv:2610.29162).
학습하지 않은 꼴로도 번졌는지는 두 꼴 가운데 하나를 고르게 해서 봤습니다. 「sure (that)」, 「so (that)」처럼 that이 들어가는 다른 자리에서는 짧은 꼴로 가는 변화가 일관되게 나타났습니다. 그보다 먼 꼴 넷 가운데서는 소유격 하나만, 그것도 붙잡는 장치를 껐을 때만 바뀌었습니다. 수동태와 목적을 나타내는 「in order to」는 바뀌지 않았고, 「all (of) the」는 학습 전부터 이미 짧은 쪽에 몰려 있었습니다 (arXiv:2610.29162).
사람은 이런 짝을 문맥에 따라 고릅니다. 예컨대 뒤에 올 말이 덜 예상될수록 생략할 수 있는 that을 더 넣습니다 (arXiv:2610.29162). 두 꼴 가운데 어느 쪽이 더 자연스러운지 사람에게 판단하게 한 연구에서도, 정보를 고르게 펴는 쪽과 의존 거리를 줄이는 쪽이 그 선택을 잘 설명했습니다 (PMID 24077911). 붙잡는 장치 없이 길이 벌점을 받은 모델은 문맥과 상관없이 짧은 꼴로 거의 다 몰렸고, 저자들은 이것을 사람다운 말에서 벗어난 것으로 봅니다. 모델에게 압축하라고 지시하지도 않았고, 두 꼴이 있다는 것을 알려 주지도 않았습니다 (arXiv:2610.29162).
이 실험은 작은 모델과 단순한 과제에서 「짧을수록 점수」가 문법 선택을 바꿀 수 있음을 보인 개념 증명입니다. 저자들도 이것을 개념 증명이라 부릅니다. 큰 모델들이 실제로 이런 압력 아래 학습됐다는 증거는 아닙니다. 이 실험에서 사람이 그 문장을 읽은 일도 없습니다. 저자들은 정답만 채점하는 보상이 정답과 사람다운 소통을 떼어 놓아, 덜 알아듣기 쉬운 말 쪽으로 모델을 몰아갈 수 있다고 추측합니다 (arXiv:2610.29162).
한 문장을 따라 읽어 보기
맨 앞의 시범 문장으로 돌아가, 앞에서부터 한 덩이씩 따라가 보겠습니다.
「Your instinct is right;」까지는 걸릴 데가 없습니다. 이어서 「the convoluted sentence」가 나오고, 독자는 이것이 주어라고 짐작한 채 동사를 기다립니다. 그런데 바로 「you are currently reading」이 끼어듭니다. 앞에 that이 없어서, 여기서 꾸밈절이 시작된다는 표지도 없습니다. sentence는 이 절 안에서 reading의 목적어입니다. 목적어 자리 꾸밈절은 대개 처리하기 어렵다고 알려져 있지만, 꾸밈을 받는 명사가 사물이면 그 차이가 줄어듭니다 (arXiv:2610.29162). sentence는 사물이라 여기서는 줄어드는 쪽입니다.
그 네 낱말을 지나서야 동사 「is quietly eating」이 옵니다. 주어와 동사 사이가 벌어진 이 자리는 의존 거리가 긴 자리이고, 사이에 낀 말이 많을수록 잇는 부담이 커진다는 실험이 있습니다 (PMID 21702774). 동시에 이 동사는 「먹는다」입니다. 문장은 먹지 않으므로, 살아 있는 주어를 기대하는 단서가 여기서 어긋납니다 (arXiv:2610.29162).
다음은 「its own reader-patience budget」입니다. reader, patience, budget 세 명사가 줄지어 서 있고, 어디까지가 한 덩이인지 독자가 스스로 묶어야 합니다. 저자들은 이 묶음이 드문 낱말 조합을 이룬다고 짚습니다 (arXiv:2610.29162). 저자들은 이런 드문 조합을 예상하기 어려운 자리의 대리 지표로 셉니다. 마지막 「footnote it」에서는 명사가 동사로 바뀝니다 (arXiv:2610.29162).
논문 부록에 실린 실제 모델 문장 하나도 같은 식으로 셀 수 있습니다. 「The guitar sitting in the corner because you're still "deciding" teaches you zero chords.」(「아직 "고민 중"이라 구석에 세워 둔 기타는 코드를 하나도 가르쳐 주지 않아요.」) Claude Sonnet 5가 대화에서 쓴 문장으로, 연구진이 의존 거리가 긴 예로 골랐습니다 (arXiv:2610.29162). 주어 guitar와 동사 teaches 사이에 여덟 낱말이 끼어 있고, 가르치는 주체는 기타라는 사물입니다.
이 논문은 이 문장 하나를 사람이 얼마나 느리게 읽는지 재지 않았습니다. 확인된 것은 둘입니다. 하나는 이런 걸림돌이 따로따로 사람의 처리 부담과 이어진다는 선행 연구이고, 그 세기는 꼴마다 다릅니다. 다른 하나는 큰 AI 모델 대부분의 글에 그 걸림돌이 왕복 번역본보다 더 자주 놓인다는 셈입니다. 저자들은 결론에서 이런 꼴을 영어 문법이 허락하지만 사람 말의 분포 밖에 있는 꼴이라고 부릅니다 (arXiv:2610.29162).
이 논문이 재지 않은 것
가장 큰 빈칸은 사람 독자입니다. 같은 글을 사람에게 읽히고 시간을 재거나, 내용을 묻는 문제를 풀게 한 실험은 이 논문에 없습니다. 이 논문으로 말할 수 있는 것은 「처리 부담과 이어진다고 알려진 꼴이, 큰 AI 모델 대부분의 글에 바꿔 쓴 글보다 더 많다」까지입니다.
측정 방식에도 한계가 있습니다. 꼴을 찾는 일은 모두 자동 도구가 했고, 사람이 그 판정을 검토했다는 기록은 논문에 없습니다. 모델과 특징마다 원문과 왕복 번역본의 차이를 검정했는데, 여러 번 비교한 것을 보정하지 않았습니다 (arXiv:2610.29162). 대화 첫마디는 10가지, 코딩 프로그램은 5개뿐이고, 모델도 널리 쓰이는 일부만 골랐습니다. 저자들도 더 많은 첫마디와 모델로 다시 해 봐야 한다고 적습니다 (arXiv:2610.29162).
대화 상대도 사람이 아니었습니다. 사람 흉내를 낸 것은 다른 AI 모델이었습니다 (arXiv:2610.29162). 실제 사용자와의 대화에서 같은 결과가 나올지는 따로 확인해야 합니다. 왕복 번역은 모델의 글에만 적용했고, 사람 글을 같은 왕복에 넣은 결과는 논문에 실려 있지 않습니다. 다만 작은 모델의 글은 왕복 뒤에 거의 바뀌지 않아서, 번역이 글마다 다른 만큼 바꾼다는 점은 보입니다 (arXiv:2610.29162).
논문은 영어 글만 다뤘습니다 (arXiv:2610.29162). 한국어 AI 글에서 같은 일이 일어나는지는 이 논문이 답하지 않습니다.
반대쪽 결도 있습니다. 모델 30종과 글 영역 10가지에서 언어 특징 284개를 살핀 대규모 분석(프리프린트)에서는, AI 글의 표지로 제안됐던 특징 상당수가 모델과 영역에 따라 크게 달라졌습니다. 영역을 넘어 꾸준했던 것은 어휘의 풍부함 정도였습니다 (arXiv:2606.04177). 이 논문에서도 에세이의 차이가 대화보다 작았던 것과 같은 결입니다. 한 상황의 결과를 모든 AI 글로 넓히기 어렵다는 뜻입니다.
같은 방향의 더 이른 결과도 있습니다. 2023년에 영어 뉴스 기사를 모델 6종의 글과 견준 분석에서, 사람 글은 문장 길이가 더 들쭉날쭉했고 어휘가 더 다양했으며 의존 거리가 더 짧게 다듬어져 있었습니다 (arXiv:2308.09067).
AI가 사람의 글을 바꾸는 일은 다른 층에서도 보고됩니다. 인도와 미국 참가자 118명에게 자기 문화에 뿌리를 둔 글을 쓰게 한 실험에서, AI의 문장 제안을 받으며 쓴 인도 참가자들은 서구식 문체 쪽으로 옮겨 갔습니다 (arXiv:2409.11360). 이 실험은 사람이 AI의 도움을 받아 쓴 글이 얼마나 비슷해지는지를 봤고, 읽기 부담은 재지 않았습니다.
모델의 문체는 요청으로도 움직입니다. 무릎 반월상 연골 수술에 대한 환자 안내문을 ChatGPT에게 쓰게 한 한 연구에서, 기본 답의 읽기 수준은 미국의사협회와 국립보건원이 권고하는 수준보다 높았습니다(미국 학년 기준 11.4~12.1). 6~8학년 읽기 수준을 겨냥해 쉬운 말로 다시 쓰라는 표준화된 지시를 더하자 읽기 수준이 약 다섯 학년 내려갔고, 정확성과 깊이는 그대로였습니다 (PMID 42106008). 다만 이 연구는 한 주제를 다뤘고, 문장 길이와 낱말 길이로 계산하는 공식으로 읽기 수준을 쟀습니다. 이 논문이 센 꼴들을 잰 것은 아닙니다.
AI 글이 사람 글보다 오히려 읽기 쉽다거나 사람이 더 좋아한다는 직접 결과는, 이 글이 함께 살펴본 연구들 가운데에는 없었습니다. 반대로 사람이 AI 글을 실제로 더 느리게 읽는다는 직접 결과도 없었습니다. 저자들은 사람이 AI 글에 많이 노출되면 이런 꼴에 익숙해질 수도 있다고 적으면서도, 여기서 평가한 꼴 상당수가 알아듣기에 근본적인 어려움을 준다고 봅니다 (arXiv:2610.29162).
두 고리를 한 실험에서 이을 재료는 이미 있습니다. 영어 원어민 107명이 언어 모델 세 종류가 쓴 글을 읽는 동안의 눈 움직임을 기록하고, 글에 언어 특징을 표시해 둔 자료집이 공개돼 있습니다 (PMID 40461827). 이런 자료에 이 논문의 셈을 겹치면, 꼴이 많은 자리에서 사람의 눈이 더 머무는지 살펴볼 수 있습니다. 다만 그 자료의 글은 이 논문이 본 모델들이 쓴 것이 아닙니다.
저자들의 결론은 이렇습니다. 모델을 코딩과 수학 추론에 능하게 만드는 학습 목표는 사람의 말을 다듬어 온 압력과 저절로 맞아떨어지지 않습니다. 그래서 앞으로는 모델의 글을 사람 독자의 필요에 맞추는 방법을 생각해 볼 수 있다고 적습니다 (arXiv:2610.29162). 저자들은 일반 논의에서, 소통을 잘하는 쪽에 점수를 주는 학습도 물론 가능하다고 적고 Opus 5.5의 개선을 그 예로 듭니다 (arXiv:2610.29162). Opus 5.5가 실제로 어떻게 학습됐는지는 논문이 다루지 않습니다.
어디를 더 볼까
- 「생성형 AI의 대답 — 한 조각씩 골라 이어 붙인 문장」 — 토큰과 다음 낱말 예측. 모델이 문장을 어떻게 이어 붙이는지.
- 「AI 모델 — 규칙 대신 예시에서 배우는 계산」 — 사람 글을 배우는 첫 학습과 그 뒤에 덧붙이는 학습의 바탕.
- 「AI 추론 시험 — 스도쿠 점수는 무엇을 재고 있었나」 — 이 논문이 원인 후보로 든 추론 학습과, 그 점수가 재는 것.
- 계약서 연구 (PMID 35257980) — 이 논문이 다룬 꼴과 겹치는 의존 거리·드문 전문용어가 실제 독자의 기억과 이해를 떨어뜨린 사례.
- 기계가 쓴 글을 읽는 눈 움직임 자료집 EMTeC (PMID 40461827) — 꼴의 셈을 사람의 읽기와 잇는 다음 단계의 재료.
근거 논문
- "Why is AI-generated language so hard to understand?" (2026) — arXiv:2610.29162 (프리프린트) — 모델 14종의 대화·코딩·에세이 글에서 읽기 부담과 이어진 특징을 셈. 큰 모델 대부분이 왕복 번역보다 많이 씀, 사람(학생 에세이) 대비 사물 주어·드문 낱말 짝은 9종 모두. 길이 벌점 강화학습이 작은 모델의 문법 선택을 짧은 쪽으로 몰아감(개념 증명). 사람 읽기 실험은 없음.
- "Poor writing, not specialized concepts, drives processing difficulty in legal language." (2022) — PMID 35257980 — 계약서에 드문 전문용어·중앙 내포·수동태가 많고, 이런 대목은 회상·이해가 낮음(N=184), 중앙 내포가 회상을 가장 크게 떨어뜨림.
- "Consequences of the serial nature of linguistic input for sentenial complexity." (2005) — PMID 21702774 — 자율 속도 읽기 2건, 새 낱말의 통합 부담은 사이에 낀 말의 양에 크게 좌우.
- "Large-scale evidence of dependency length minimization in 37 languages." (2015) — PMID 26240370 — 37개 언어 모두에서 실제 의존 거리가 무작위 기준선보다 짧음.
- "Testing the Predictions of Surprisal Theory in 11 Languages" (2023) — arXiv:2307.03667 (프리프린트) — 다섯 어족 11개 언어에서 덜 예상되는 낱말일수록 읽기 시간이 길다.
- "Lossy-Context Surprisal: An Information-Theoretic Model of Memory Effects in Sentence Processing." (2020) — PMID 32100918 — 처리 부담을 앞말을 온전히 담지 못한 기억 위의 놀라움으로 설명하는 모형.
- "Frequency Explains the Inverse Correlation of Large Language Models' Size, Training Data Amount, and Surprisal's Fit to Reading Times" (2024) — arXiv:2402.02255 (EACL 2024 학회 논문) — 큰 모델일수록 읽기 시간을 덜 맞히며, 드문 낱말을 사람보다 지나치게 잘 예상하는 것이 주된 까닭.
- "Just Enough Thinking: Efficient Reasoning with Adaptive Length Penalties Reinforcement Learning" (2025) — arXiv:2506.05256 (프리프린트) — 적응형 길이 벌점으로 평균 토큰 50% 감소, 성능 큰 하락 없음.
- "Leash: Adaptive Length Penalty and Reward Shaping for Efficient Large Reasoning Model" (2025) — arXiv:2512.21540 (프리프린트) — 적응형 길이 벌점으로 평균 추론 길이 60% 감소.
- "Why Does ChatGPT "Delve" So Much? Exploring the Sources of Lexical Overrepresentation in Large Language Models" (2024) — arXiv:2412.11385 (COLING 2025 학회 논문) — 과학 초록에서 AI 사용으로 늘어난 낱말 21개, 사람 피드백 학습의 역할과 들어맞는 모델 비교.
- "Information density and dependency length as complementary cognitive models." (2014) — PMID 24077911 — 두 문형 중 자연스러운 쪽을 고르는 판단을 정보 밀도 균일성과 의존 거리 최소화가 함께 설명.
- "A Systematic Analysis of Linguistic Features in AI-Generated English Text Detection Across Domains and Models" (2026) — arXiv:2606.04177 (프리프린트) — 모델 30종·영역 10가지·특징 284개, 제안된 표지 상당수가 맥락 의존적이고 어휘 풍부함만 꾸준.
- "Contrasting Linguistic Patterns in Human and LLM-Generated News Text" (2023) — arXiv:2308.09067 (프리프린트) — 뉴스에서 사람 글이 문장 길이 분포가 넓고 어휘가 다양하며 의존 거리가 더 다듬어져 있음.
- "Plain-language prompting improves readability of ChatGPT-generated patient education for meniscal surgery without loss of accuracy." (2026) — PMID 42106008 — 기본 답은 권고 읽기 수준 초과, 쉬운 말 지시로 약 5학년 낮아짐, 정확성 유지(근거 수준 IV).
- "EMTeC: A corpus of eye movements on machine-generated texts." (2025) — PMID 40461827 — 영어 원어민 107명이 기계 생성 글을 읽는 눈 움직임 자료집, 언어 특징 주석 포함.
- "Online processing of novel noun-noun compounds: eye movement evidence." (2014) — PMID 23697393 — 눈 움직임 실험 3건, 풀기 어려운 새 명사-명사 조합에서 머리 명사 첫 읽기 시간이 길고, 앞 문맥의 도움은 늦은 단계에서만.
- "AI Suggestions Homogenize Writing Toward Western Styles and Diminish Cultural Nuances" (2024) — arXiv:2409.11360 (CHI 2025 학회 논문) — 인도·미국 118명 통제 실험, AI 제안이 인도 참가자의 글을 서구식 문체로 옮김.