Paperis 아티클
알고리즘 — 하나씩 부르는 숫자, 반씩 지우는 질문
알고리즘은 문제를 풀려고 정해 둔, 끝이 있는 단계의 순서다. 같은 문제도 푸는 방법이 여럿이고, 빠르기는 입력이 커질 때 일이 얼마나 늘어나는지로 잰다. 모든 프로그램이 멈출지를 늘 옳게 판정하는 알고리즘은 없다는 것이 증명돼 있다.
알고리즘 — 하나씩 부르는 숫자, 반씩 지우는 질문
1부터 100 사이의 수 하나
한 사람이 1부터 100 사이의 수 하나를 마음속에 정합니다. 다른 사람은 그 수를 맞혀야 하고, 정한 사람은 묻는 말에 「맞아」, 「더 커」, 「더 작아」 가운데 하나로만 답합니다.
첫 번째 사람은 1부터 차례로 부릅니다. 「1?」 「더 커.」 「2?」 「더 커.」 정한 수가 작으면 금방 끝나지만, 정한 수가 100이면 백 번을 불러야 합니다.
두 번째 사람은 처음에 50을 부릅니다. 「더 커」라는 답이 오면 1부터 50까지는 다시 볼 필요가 없습니다. 이제 남은 51부터 100의 한가운데인 75를 부르고, 답에 따라 또 절반을 지웁니다. 질문 하나마다 남은 후보가 절반으로 줄어듭니다 (OpenStax Introduction Computer Science 3.3). 100을 절반씩 일곱 번 나누면 1보다 작아지니, 셈해 보면 정한 수가 무엇이든 일곱 번 안에 맞힙니다.
두 사람 모두 결국 수를 맞힙니다. 다른 것은 몇 번 묻느냐이고, 그 차이는 범위가 넓어질수록 크게 벌어집니다. 이 글은 이 놀이 하나를 들고 알고리즘이 무엇인지, 같은 문제를 푸는 방법이 왜 여럿이고 그 빠르기가 왜 그렇게 다른지, 컴퓨터가 아무리 빨라도 풀 수 없는 문제가 왜 있는지까지 따라갑니다.
알고리즘은 끝이 있는 단계의 순서입니다
두 사람이 따른 방법은 말로 적어 둘 수 있습니다. 첫 번째 사람의 방법은 「1부터 부르고, 맞을 때까지 하나씩 올려 부른다」입니다. 두 번째 사람의 방법은 「남은 범위의 한가운데 수를 부르고, 답에 따라 절반을 지운다」입니다. 알고리즘은 어떤 문제를 풀기 위해 정해 둔, 끝이 있는 단계의 순서입니다 (OpenStax Introduction Computer Science 1.1) (OpenStax Introduction Computer Science 3.1).
알고리즘은 무언가를 받아서 시작하고 무언가를 내놓고 끝납니다. 입력(input)은 알고리즘이 받아서 시작하는 재료이고, 출력(output)은 알고리즘이 끝에 내놓는 결과입니다. 숫자 맞히기에서 입력은 1부터 100이라는 범위와 질문마다 돌아오는 답이고, 출력은 맞힌 수 하나입니다. 컴퓨터과학은 문제를 대개 이렇게, 어떤 입력에 어떤 출력이 맞는지가 정해진 꼴로 세웁니다 (OpenStax Introduction Computer Science 3.2).
이 순서를 컴퓨터에 맡기려면 두 가지를 지켜야 합니다. 하나는 단계가 모호하지 않아야 한다는 것입니다. 사람끼리라면 「가운데쯤 불러 봐」로 충분합니다. 남은 수가 51부터 100까지 쉰 개라 한가운데가 둘일 때 어느 쪽을 부를지도 알아서 정합니다. 컴퓨터는 적어 준 단계에 아무것도 보태거나 빼지 않고 그 자리에서 그대로 밟습니다 (OpenStax Introduction Computer Science 3.1). 그래서 「한가운데가 둘이면 작은 쪽을 부른다」처럼 갈림길마다 할 일이 하나로 정해져 있어야 합니다.
다른 하나는 끝이 있어야 한다는 것입니다. 두 번째 방법은 남은 범위가 한 칸으로 줄면 반드시 멈춥니다. 같은 단계를 되풀이하는 방법에 멈출 조건이 빠져 있으면, 그 방법은 같은 일을 끝없이 되풀이합니다 (OpenStax Introduction Computer Science 2.1).
이 단계를 컴퓨터가 읽는 언어로 옮겨 적은 것이 프로그램입니다. 프로그램(program)은 컴퓨터가 할 일을 순서대로 적어 둔 명령의 묶음입니다. 알고리즘이 방법이라면, 프로그램은 그 방법을 특정한 프로그래밍 언어(programming language)로 옮겨 실제로 돌아가게 만든 것입니다 (OpenStax Introduction Computer Science 3.1). 옮겨 적는 일은 이 시리즈의 다른 편, 「프로그램과 프로그래밍 언어 — 사람이 쓰는 악보, 구멍대로 치는 피아노」가 다룹니다. 놀이의 두 방법은 종이에 적은 순간 이미 알고리즘이고, 컴퓨터는 그것을 적힌 그대로 따르는 기계입니다.
큰 물음을 같은 모양의 작은 물음으로
두 번째 사람이 50을 먼저 부른 데에는 생각의 버릇 두 가지가 들어 있습니다. 컴퓨팅 사고(computational thinking)는 복잡한 문제를 작은 부분으로 나누고, 그 풀이를 사람이나 컴퓨터가 따를 수 있는 단계로 적을 수 있게 다듬는 생각의 방식입니다 (OpenStax Introduction Computer Science 2.1). 이 말에는 아직 모두가 합의한 한 가지 정의가 없습니다 (DOI: 10.1177/21582440211016418).
분해(decomposition)는 복잡한 문제를 다루기 쉬운 작은 부분으로 나누는 일입니다 (OpenStax Introduction Computer Science 2.1). 「1부터 100 사이 어디에 있나」라는 물음은 「앞쪽 절반인가, 뒤쪽 절반인가」로 바뀝니다. 답을 들으면 「51부터 100 사이 어디에 있나」라는, 크기만 작아진 같은 물음이 남습니다. 큰 문제를 같은 모양의 작은 문제로 줄여 가다가 충분히 작아지면 바로 답하는 이 방식은 알고리즘을 짜는 대표적인 틀의 하나입니다 (OpenStax Introduction Computer Science 3.4).
추상화(abstraction)는 지금 하려는 일에 필요한 것만 남기고, 상관없는 세부는 덜어 내거나 감추는 일입니다 (OpenStax Introduction Computer Science 2.1). 숨긴 것이 수이든 사람 이름이든, 두 번째 방법에 필요한 정보는 하나뿐입니다. 찾는 것과 부른 것을 견주어 어느 쪽이 앞인지 말할 수 있으면 됩니다. 이름끼리 견줄 때도 컴퓨터는 글자마다 매겨 둔 수를 차례로 견줍니다 (OpenStax Introduction Computer Science 3.1). 글자를 수로 바꾸는 일은 이 시리즈의 다른 편, 「비트와 데이터 — 솟은 점과 평평한 자리, 손끝이 아는 약속」이 다룹니다.
이런 생각에는 컴퓨터도 코드도 필요 없습니다. 컴퓨터 없이 몸을 움직이거나 종이로 하는 활동으로 컴퓨팅 사고를 가르치는 방법이 있고, 지금까지의 연구는 좋은 결과를 보고하지만 큰 규모로 확인하는 일은 아직 남아 있습니다 (DOI: 10.4018/978-1-7998-4576-8.ch009). 그런데도 교사 양성 과정에서는 컴퓨팅 사고를 코딩과 같은 것으로 여기는 오해가 거듭 보고됩니다. 이 대목은 문헌 54편을 엮은 검토 논문이 정리한 것이고, 동료 심사 전의 프리프린트입니다 (DOI: 10.20944/preprints202602.1017.v1). 컴퓨팅 사고 교육 연구 80편을 검토한 종설도 이 분야의 교육이 코드 중심으로 기울어 있다고 결론지었습니다 (DOI: 10.1177/21582440211016418). 알고리즘의 출발점은 문제를 쪼개고 추리는 생각이고, 코드는 그다음입니다.
하나씩 부르기와 반씩 지우기
이제 두 방법에 이름을 붙입니다. 순차 탐색(sequential search)은 모아 둔 것들을 처음부터 하나씩 차례로 확인하며 찾는 것을 찾는 방법입니다 (OpenStax Introduction Computer Science 3.5). 이진 탐색(binary search)은 순서대로 늘어선 목록의 한가운데와 찾는 것을 견주어, 남은 후보의 절반을 한 번에 지워 가며 찾는 방법입니다 (OpenStax Introduction Computer Science 3.5). 앞의 것이 첫 번째 사람의 방법이고, 뒤의 것이 두 번째 사람의 방법입니다.
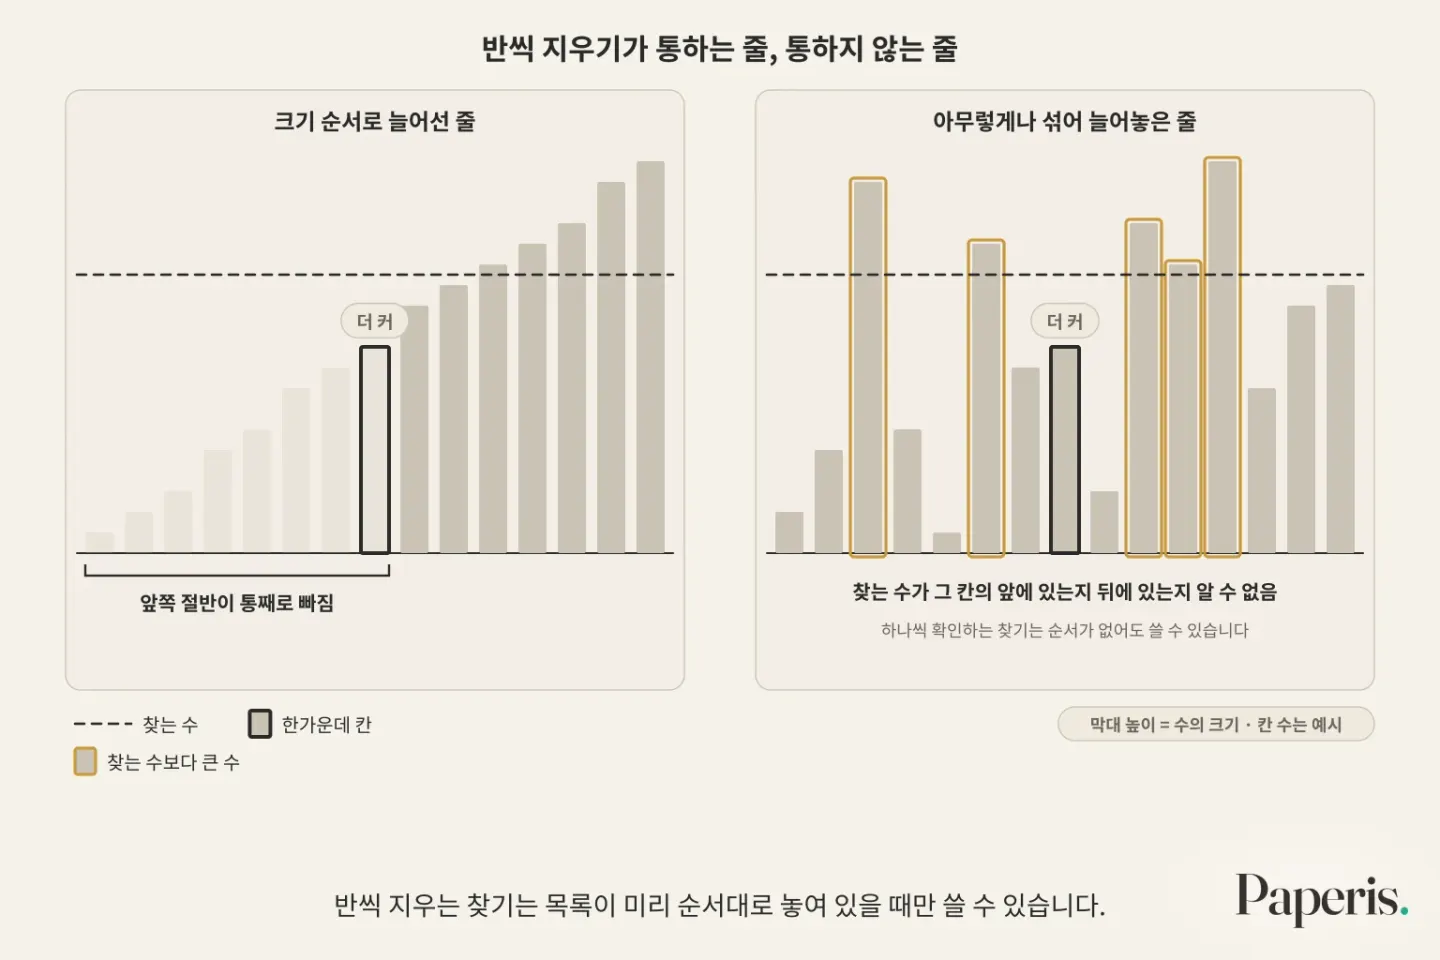
반씩 지우기가 통하는 까닭은 「더 커」 한마디가 지워도 되는 절반을 알려 주기 때문입니다. 1부터 100까지의 수는 처음부터 크기 순서로 늘어서 있어서, 50보다 크다는 답만으로 앞쪽 절반이 통째로 빠집니다. 같은 100개의 수를 아무렇게나 섞어 한 줄로 늘어놓았다고 해 봅시다. 줄 한가운데 칸의 수가 찾는 수보다 작다고 해도, 찾는 수가 그 칸의 앞에 있는지 뒤에 있는지는 알 수 없습니다. 그래서 반씩 지우는 찾기는 목록이 미리 순서대로 놓여 있을 때만 쓸 수 있습니다 (OpenStax Introduction Computer Science 3.5). 하나씩 확인하는 찾기는 순서가 없어도 쓸 수 있습니다 (OpenStax Introduction Computer Science 3.5).
미리 순서대로 놓는 일에도 이름이 있습니다. 정렬(sorting)은 흩어진 것들을 작은 것부터 큰 것처럼 정해 둔 순서대로 다시 늘어놓는 일입니다 (OpenStax Introduction Computer Science 3.5). 반씩 지우는 찾기가 통하려면 누군가 먼저 정렬해 두어야 하니, 정렬은 다른 많은 알고리즘의 바탕이 됩니다 (OpenStax Introduction Computer Science 3.5). 정렬하는 일도 공짜는 아니어서, 늘어놓을 것이 많을수록 일이 늘어납니다 (OpenStax Introduction Computer Science 3.5). 정렬하는 방법은 여럿 알려져 있지만, 모든 경우에 가장 좋은 하나를 고를 수는 없습니다. 데이터(data)가 얼마나 많은지, 이미 얼마나 정돈돼 있는지, 작업하는 동안 따로 쓸 자리가 얼마나 넉넉한지에 따라 알맞은 방법이 달라집니다 (DOI: 10.28925/2663-4023.2023.21.8698).
반씩 지우기에는 조건이 하나 더 있습니다. 한가운데 칸으로 곧장 건너뛸 수 있어야 합니다. 이 조건은 데이터를 어떻게 담아 두느냐에 달려 있습니다. 자료구조(data structure)는 데이터를 어떤 모양으로 늘어놓고 어떻게 꺼내 쓸지 정해 둔 짜임입니다 (OpenStax Introduction Computer Science 3.1). 칸마다 번호가 붙어 몇 번째 칸이든 바로 열어 볼 수 있는 목록에서는 이진 탐색이 빠릅니다. 앞 칸에서 다음 칸으로 줄줄이 따라가야만 닿는 목록에서는 한가운데에 닿는 데만도 한참 걸려 이진 탐색이 느립니다 (OpenStax Introduction Computer Science 3.5). 알고리즘을 짤 수 있는지부터가 데이터를 어떻게 나타내느냐에 달린 경우가 많습니다 (OpenStax Introduction Computer Science 3.1). 반씩 지우기는 정렬된 목록과 곧장 건너뛸 수 있는 칸, 이 두 가지를 전제로 합니다.
범위가 두 배가 되면
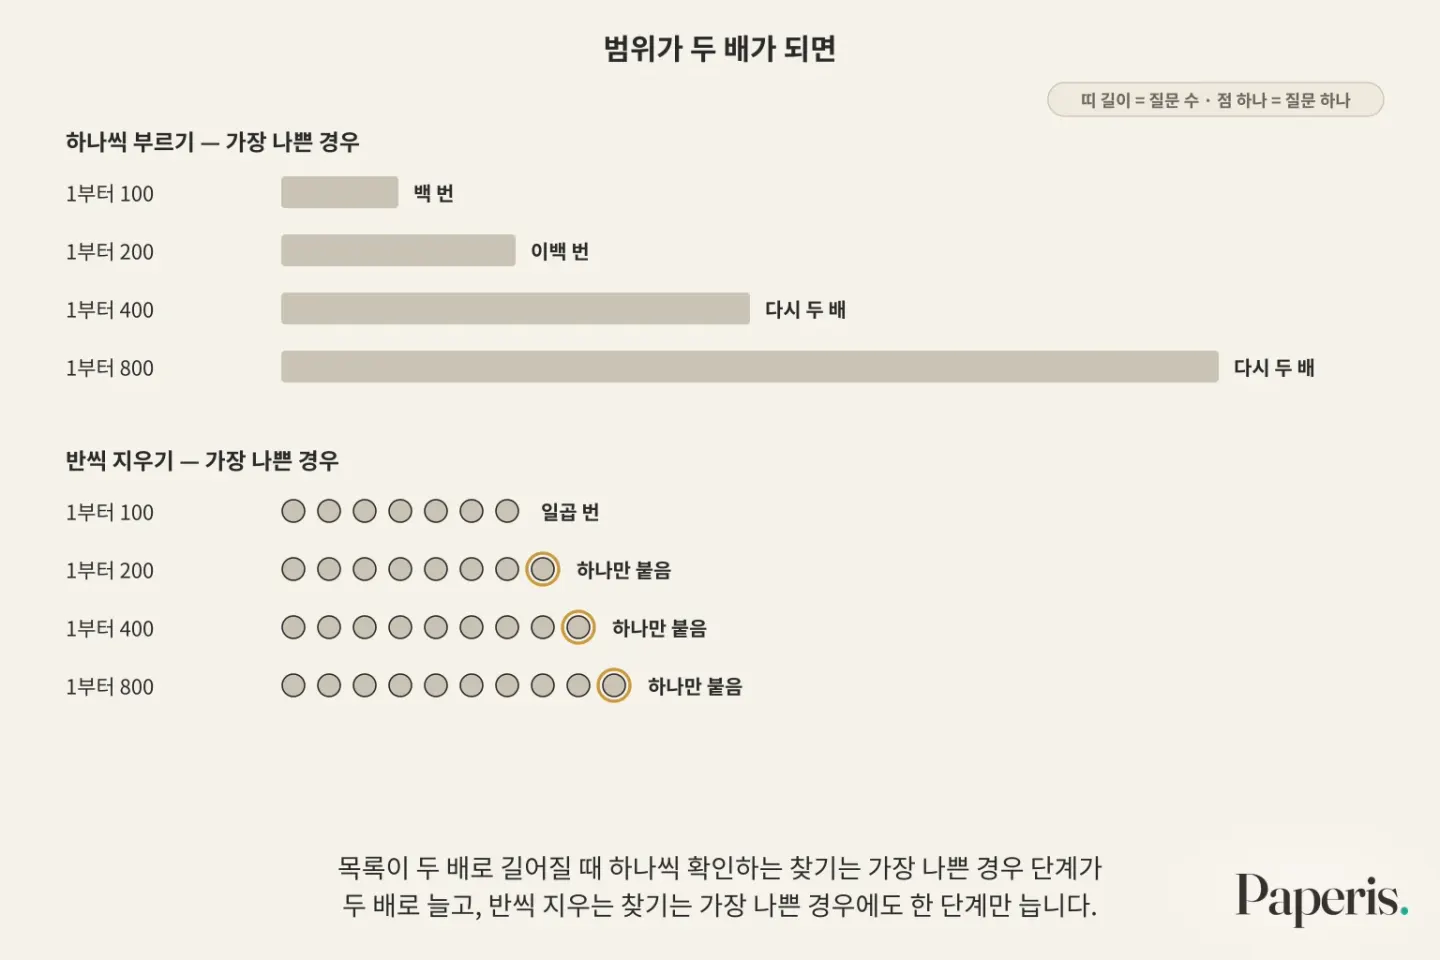
이번에는 범위를 1부터 200으로 넓혀 다시 놀아 봅니다. 정한 수가 200이면 하나씩 부르는 사람은 이백 번을 불러야 합니다. 범위가 두 배가 되자 질문도 두 배가 됐습니다. 반씩 지우는 사람은 「100?」 한 번으로 남은 범위를 백 칸 이하로 줄이고, 거기서부터는 처음 놀이와 똑같이 풉니다. 늘어난 질문은 한 번뿐입니다. 목록이 두 배로 길어질 때 하나씩 확인하는 찾기는 가장 나쁜 경우 단계가 두 배로 늘고, 반씩 지우는 찾기는 가장 나쁜 경우에도 한 단계만 늡니다 (OpenStax Introduction Computer Science 3.3). 범위를 400, 800으로 계속 넓혀도 앞사람의 질문은 매번 두 배가 되고, 뒷사람의 질문에는 매번 하나씩만 붙습니다.
두 사람을 견줄 때 우리가 센 것은 질문 횟수입니다. 누가 더 빨리 말하는지는 따지지 않았습니다. 알고리즘을 견줄 때도 같은 이유로 횟수를 셉니다. 같은 방법을 빠른 컴퓨터에서 돌리면 금방 끝나고 느린 컴퓨터에서 돌리면 오래 걸리니, 방법 자체의 차이를 보려면 밟는 단계를 세는 편이 낫습니다 (OpenStax Introduction Computer Science 3.3). 시간 복잡도(time complexity)는 입력의 크기가 커질 때 알고리즘이 밟아야 하는 단계 수가 얼마나 늘어나는지를 나타낸 것입니다 (OpenStax Introduction Computer Science 3.3). 숫자 맞히기의 두 방법은 바로 이 늘어나는 모양에서 갈립니다.
그 모양에 붙이는 짧은 이름표도 있습니다. 빅오 표기(Big O notation)는 입력이 아주 커질 때 단계 수가 어떤 모양으로 늘어나는지를 간단한 기호로 적는 방법입니다 (OpenStax Introduction Computer Science 3.3). 「범위에 비례해 는다」와 「범위가 두 배가 될 때마다 하나씩 는다」는 두 사람의 차이가 이 표기로는 기호 하나씩으로 적힙니다. 이 글은 기호 대신 말로 적습니다.
그렇다면 빠른 방법이면 다 좋을까요. 두 사람에게 물을 것이 하나 더 있습니다. 끝났을 때 손에 든 수가 정말 정한 수인가입니다. 정확성(correctness)은 가능한 모든 입력에 대해 알고리즘이 기대한 출력을 내는 성질입니다 (OpenStax Introduction Computer Science 3.2). 두 방법은 모두 반드시 끝나고 끝날 때 맞힌 수가 정답이니, 둘 다 옳습니다. 갈린 것은 질문 횟수뿐입니다. 거꾸로 답은 옳게 내면서 필요 없이 오래 걸리는 프로그램도 있습니다 (OpenStax Introduction Computer Science 3.3). 옳다는 것을 보이는 일도 늘 쉽지는 않습니다. 숫자 맞히기는 정할 수 있는 수가 백 개뿐이라 전부 해 볼 수 있지만, 받을 수 있는 입력이 끝없이 많은 알고리즘은 하나하나 다 넣어 볼 길이 없습니다 (OpenStax Introduction Computer Science 3.2). 옳은 답을 내는가와 얼마나 빨리 내는가는 서로 다른 물음입니다.
다 대 보기로는 안 되는 일, 원래 안 되는 일
반씩 지우는 사람이 없었다면 어땠을까요. 하나씩 부르는 사람도 결국은 맞혔을 것입니다. 후보의 수가 정해져 있으면, 전부 불러 보는 방법은 언젠가 답에 닿기 때문입니다 (OpenStax Introduction Computer Science 3.2). 남는 문제는 언제 닿느냐입니다. 알고리즘을 견줄 때 따지는 것도 걸리는 시간과 차지하는 자리입니다 (OpenStax Introduction Computer Science 3.2).
숨긴 것이 수 하나 대신 여러 조각을 엮은 조합이라면 사정이 달라집니다. 조각이 늘수록 맞춰 볼 후보 조합이 폭발적으로 불어나서, 후보를 전부 대 보는 방법은 조각이 몇 개 안 될 때나 쓸 만합니다. 컴퓨터가 빨라져도 이 한계는 남습니다 (OpenStax Introduction Computer Science 3.4). 입력이 하나 늘 때마다 일이 두 배가 되는 방법이라면, 우주의 나이보다 오래 걸리게 만드는 데 다룰 것 천 개면 충분합니다 (OpenStax Introduction Computer Science 3.3). 이것은 다 대 보는 방법의 한계이고, 같은 문제를 다른 방법으로 더 빨리 풀 수 있는지와는 다른 이야기입니다.
시간을 아무리 줘도 어떤 방법으로도 풀 수 없는 문제는 따로 있습니다. 놀이의 두 방법은 반드시 끝납니다. 그렇다면 아무 프로그램과 그 입력을 받아 들고, 그 프로그램이 그 입력에서 언젠가 멈추는지를 늘 옳게 판정해 주는 알고리즘도 만들 수 있을까요. 이 물음을 정지 문제라고 부르고, 모든 프로그램에 대해 늘 옳게 답하는 그런 알고리즘은 없다는 것이 증명돼 있습니다. 이 대목의 근거는 동료 심사 전 프리프린트의 개관입니다 (DOI: 10.20944/preprints202512.0580.v1). 결정 불가능 문제(undecidable problem)는 모든 입력에 대해 예나 아니오로 옳게 답하는 알고리즘이 원리적으로 있을 수 없는 문제입니다. 정지 문제가 그 대표입니다 (DOI: 10.20944/preprints202512.0580.v1).
1936년 앨런 튜링은 계산을 수학으로 본뜬 모형, 오늘날 튜링 기계라고 부르는 것을 만들었습니다. 그는 이 모형을 수학자 다비트 힐베르트가 세운, 수학을 기계적 절차로 다루려는 계획의 핵심 부분을 반박하는 데 쓰려 했습니다. 이 모형은 뒤에 컴퓨터가 할 수 있는 일의 범위를 정하는 틀이 됐습니다 (DOI: 10.1093/oso/9780198747826.003.0049). 같은 1930년대에 쿠르트 괴델과 알론조 처치도 계산의 뜻과 한계를 따지는 일의 중심에 있었습니다 (DOI: 10.1093/oso/9780198747826.003.0014). 정지 문제를 풀 수 없다는 증명은 흔히 튜링의 1936년 논문에 돌립니다. 이 귀속을 따진 2026년 논문은 한마디로 잘라 말하기 어렵다는 결론에 이르렀습니다 (DOI: 10.1093/logcom/exaf075).
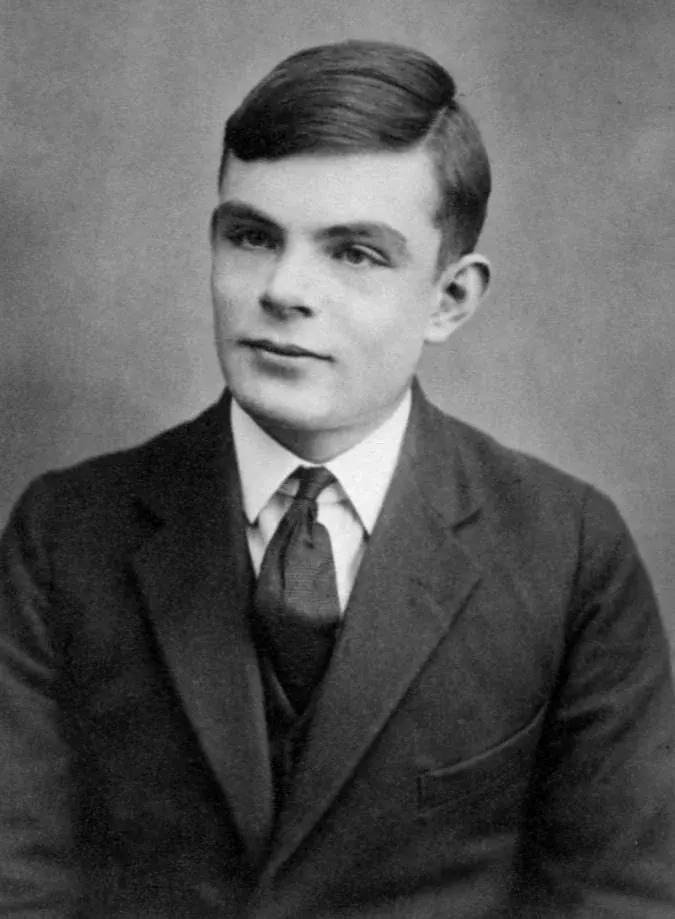
열여섯 살 무렵의 앨런 튜링 · 여권 사진(촬영자 아서 레지널드 채핀 추정), 1928~29년 · 위키미디어 커먼즈(퍼블릭 도메인)
후보를 전부 대 보는 방법으로는 빠른 컴퓨터로도 감당 못 할 만큼 일이 불어나는 문제가 있고, 정지 문제처럼 어떤 알고리즘으로도 풀 수 없다는 것이 증명된 문제도 있습니다 (OpenStax Introduction Computer Science 3.4) (DOI: 10.20944/preprints202512.0580.v1).
뉴스 속 「알고리즘」
「알고리즘이 이 영상을 추천했다」는 문장의 알고리즘도 이 글의 알고리즘과 같은 말입니다. 볼 만한 것을 가늠할 자료가 입력이고, 권할 목록이 출력입니다. 그 절차를 설계한 것은 사람입니다 (OpenStax Introduction Computer Science 3.2).
그럼 추천 알고리즘이 옳은지는 어떻게 따질까요. 숫자 맞히기라면 정한 수와 맞힌 수를 견주면 끝납니다. 추천에는 그렇게 견줄 하나의 정답이 없고, 무엇이 옳은 출력인지 사람들끼리도 합의하지 못하는 문제가 있습니다 (OpenStax Introduction Computer Science 3.2).
알고리즘을 설계하는 사람은 현실을 통째로 다룰 수 없어서, 어떤 세부를 남기고 어떤 세부를 버릴지 정해 컴퓨터가 다룰 틀을 만듭니다. 이 틀을 모형이라고 부릅니다 (OpenStax Introduction Computer Science 3.2). 알고리즘이 옳다는 말은 대개 그 모형을 잘 따른다는 뜻이고, 모형이 놓친 현실까지 맞힌다는 보장은 없습니다 (OpenStax Introduction Computer Science 3.2). 알고리즘과 그것이 낳는 사회적 결과의 관계는 지금도 논쟁 중입니다 (OpenStax Introduction Computer Science 3.2).
뉴스의 「알고리즘」도 입력을 받아 정해 둔 절차대로 출력을 내고, 그 결과에는 설계한 사람이 무엇을 남기고 버리도록 모형을 짰는지가 들어 있습니다. 규칙을 사람이 하나하나 적는 대신 예시에서 배우게 하는 계산은 「AI 모델 — 규칙 대신 예시에서 배우는 계산」이 다룹니다.
다시 숫자 맞히기 앞에서
처음의 두 사람으로 돌아가 봅니다. 두 사람은 같은 문제를 다른 알고리즘으로 풀었습니다. 둘 다 끝이 있고 옳았지만, 범위가 넓어질수록 질문 수는 크게 벌어졌습니다. 반씩 지우기의 빠르기는 범위가 크기 순서로 놓여 있다는 사실에서 나왔습니다. 그리고 아무 프로그램이 주어진 입력에서 멈추는지를 모든 경우에 옳게 판정해 주는 방법은 원리적으로 만들 수 없다는 것이 증명돼 있습니다. 이 근거는 동료 심사 전 프리프린트입니다 (DOI: 10.20944/preprints202512.0580.v1).
놀이는 쓸모 있는 그림이지만 두 군데에서 실제와 다릅니다. 첫째, 놀이에서는 사람이 답하고 생각합니다. 컴퓨터 안에서는 두 값을 견주는 일까지 모두 기계가 밟는 단계 하나이고 (OpenStax Introduction Computer Science 3.3), 컴퓨터는 그 단계를 적힌 그대로 따를 뿐입니다 (OpenStax Introduction Computer Science 3.1). 그 단계를 실제로 하나씩 처리하는 부품은 이 시리즈의 다른 편, 「CPU와 메모리 — 비워지는 책상, 남는 서고」가 다룹니다. 둘째, 놀이의 1부터 100은 저절로 크기 순서가 있습니다. 실제 데이터는 누군가 미리 정렬해 두고, 한가운데로 곧장 건너뛸 수 있는 모양으로 담아 두어야 반씩 지우기가 통합니다 (OpenStax Introduction Computer Science 3.5).
어디를 더 볼까
- 컴퓨터가 규칙을 사람이 적어 주는 대신 예시에서 배우는 방식: 「AI 모델 — 규칙 대신 예시에서 배우는 계산」
- 그 배움이 실제로 숫자를 조금씩 고치는 일이라는 것: 「신경망과 파라미터 — 수천억 개의 다이얼을 조금씩 돌린다는 것」
- 글자를 숨기는 일도 알고리즘의 한 갈래입니다 (OpenStax Introduction Computer Science 3.2). 그 가운데 공개키 암호: 「열쇠와 자물쇠 — 공개키는 왜 공개해도 안전한가」
- 이 시리즈의 다른 편: 알고리즘을 프로그래밍 언어로 옮기는 일은 「프로그램과 프로그래밍 언어 — 사람이 쓰는 악보, 구멍대로 치는 피아노」, 단계를 실제로 처리하는 부품은 「CPU와 메모리 — 비워지는 책상, 남는 서고」, 글자와 그림을 수로 바꾸는 일은 「비트와 데이터 — 솟은 점과 평평한 자리, 손끝이 아는 약속」이 다룹니다.
근거 논문
- "Introduction to Computer Science — 1.1 Computer Science" (2024) — OpenStax Introduction Computer Science 1.1 — 알고리즘은 입력과 유한한 수의 단계로 셈을 하고 출력을 낸다(공용 정의 「끝이 있는」의 근거, 산술 연산 맥락의 서술).
- "Introduction to Computer Science — 2.1 Computational Thinking" (2024) — OpenStax Introduction Computer Science 2.1 — 컴퓨팅 사고는 복잡한 문제를 작은 부분으로 나누고 체계적인 풀이를 세우는 과정. 분해·추상화의 정의, 되풀이에는 멈출 조건이 있어야 무한 반복을 피한다.
- "Introduction to Computer Science — 3.1 Introduction to Data Structures and Algorithms" (2024) — OpenStax Introduction Computer Science 3.1 — 알고리즘은 데이터를 다루는 정밀한 명령의 순서, 컴퓨터는 정해진 명령만 적힌 그대로 실행하며, 프로그램은 알고리즘을 프로그래밍 언어로 구현한 것. 알고리즘 설계는 데이터를 어떻게 나타내는지에 달려 있다.
- "Introduction to Computer Science — 3.2 Algorithm Design and Discovery" (2024) — OpenStax Introduction Computer Science 3.2 — 입력에 대응하는 출력을 정한 문제, 유한한 입력은 전수 탐색으로 늘 풀리므로 목표는 효율적인 풀이. 모형은 일부 세부를 버리며, 정확성은 모든 입력에서 기대 출력과 맞는 것이고 주로 모형과의 일치를 뜻한다. 추천과 알고리즘의 사회적 결과는 논쟁 중.
- "Introduction to Computer Science — 3.3 Formal Properties of Algorithms" (2024) — OpenStax Introduction Computer Science 3.3 — 실행 시간은 컴퓨터마다 달라 단계 수로 따진다. 시간 복잡도·빅오 표기. 입력이 두 배가 되면 순차 탐색 최악은 두 배, 이진 탐색은 한 단위 증가. 지수 시간 알고리즘은 원소 천 개에서 우주의 나이를 넘는다.
- "Introduction to Computer Science — 3.4 Algorithmic Paradigms" (2024) — OpenStax Introduction Computer Science 3.4 — 분할 정복은 문제를 같은 꼴의 작은 문제로 나눠 푼다. 조합 문제의 전수 대입은 조합 폭발로 컴퓨터가 빨라져도 아주 작은 입력에서만 쓸 수 있다.
- "Introduction to Computer Science — 3.5 Sample Algorithms by Problem" (2024) — OpenStax Introduction Computer Science 3.5 — 순차 탐색은 어떤 모음에도 쓰이고, 이진 탐색은 번호로 곧장 접근할 수 있는 정렬된 목록에 기대 절반씩 지운다. 정렬은 이진 탐색 등 많은 알고리즘의 기초.
- "Teaching Computational Thinking Unplugged" (2020) — DOI: 10.4018/978-1-7998-4576-8.ch009 — 컴퓨터 없이 가르치는 「언플러그드」 컴퓨팅 사고 교육, 기존 연구는 긍정적이나 대규모 평가는 더 필요하다는 장(章).
- "Generative AI to Foster Computational Thinking in Initial Teacher Education: A Thematic Literature Review and Model" (2026) — DOI: 10.20944/preprints202602.1017.v1 — 54편 문헌 검토(프리프린트). 교사 양성 과정에서 컴퓨팅 사고를 코딩과 동일시하는 오해가 지속적으로 보고된다.
- "The Code-Centric Nature of Computational Thinking Education: A Review of Trends and Issues in Computational Thinking Education Research" (2021) — DOI: 10.1177/21582440211016418 — 컴퓨팅 사고 교육 연구 80편 검토. 연구 공동체에 합의된 개념 정의가 없고, 교육이 코드 중심이라는 결론.
- "A PERFORMANCE COMPARISON OF SORTING ALGORITHMS IN DIFFERENT PROGRAMMING LANGUAGES" (2023) — DOI: 10.28925/2663-4023.2023.21.8698 — 정렬 알고리즘 아홉 가지를 네 언어로 비교. 모든 경우에 가장 좋은 하나는 고를 수 없고 데이터 크기·구조·정돈 정도·추가 메모리 등에 따라 달라진다.
- "Analyzing the Halting Problem: Limits of Computation and Decidability in Turing Machines" (2025) — DOI: 10.20944/preprints202512.0580.v1 — 정지 문제를 개관한 프리프린트. 임의의 프로그램과 입력에 대해 멈춤을 판정하는 문제는 결정 불가능하다(모든 프로그램에 대해 늘 옳게 예측하는 알고리즘은 없다).
- "Decidability and the Entscheidungsproblem" (2017) — DOI: 10.1093/oso/9780198747826.003.0049 — 1936년 튜링이 계산의 수학적 모형(튜링 기계)을 만들어 힐베르트의 수학 기계화 계획의 핵심 부분을 반박하는 수단으로 의도했고, 그 모형이 비인간 컴퓨터가 할 수 있는 일의 범위를 정하게 됐다.
- "Hilbert and his famous problem" (2017) — DOI: 10.1093/oso/9780198747826.003.0014 — 『The Turing Guide』의 한 장. 1930년대 튜링·괴델·처치 등이 계산의 뜻과 한계를 따지는 이론 컴퓨터과학을 열었다.
- "Did Turing prove the undecidability of the halting problem?" (2026) — DOI: 10.1093/logcom/exaf075 — 정지 문제의 결정 불가능성을 튜링(1936)에게 돌리는 흔한 귀속의 정확성을 따져 단순하지 않은(nuanced) 결론에 이른 논문.