Paperis 아티클
비트와 데이터 — 솟은 점과 평평한 자리, 손끝이 아는 약속
컴퓨터는 두 가지만 구별하는 자리, 비트를 여럿 이어 수와 글자, 그림과 소리를 담는다. 같은 비트 줄이 무엇인지는 그것을 읽는 약속이 정하고, 압축은 그 줄을 더 짧게 다시 적는 일이다.
비트와 데이터 — 솟은 점과 평평한 자리, 손끝이 아는 약속
손끝으로 읽는 글
점자책을 펼치면 종이 위에 작은 점들이 볼록 솟아 있습니다. 점자 한 칸에는 점이 놓일 수 있는 자리가 여섯 개 있고, 읽는 사람은 손끝으로 자리마다 점이 솟았는지 평평한지를 느낍니다. 여섯 자리가 어떻게 섞였느냐에 따라 그 칸이 무엇을 뜻할지가 정해집니다.
종이 위에 있는 것은 솟은 점과 평평한 자리뿐입니다. 그 모양을 어떤 글자로 읽을지는 쓰는 사람과 읽는 사람이 미리 맞춰 둔 약속이 정합니다. 같은 모양이 바로 앞에 놓인 표시에 따라 글자가 되기도 하고 숫자가 되기도 합니다.
휴대폰에 담긴 사진 한 장, 노래 한 곡, 메시지 한 줄도 이와 닮은 방식으로 담겨 있습니다. 이 글은 점자 한 칸을 길잡이로 삼아, 두 가지만 구별하는 자리에서 출발해 수와 글자, 그림과 소리가 어떻게 담기는지, 그렇게 담긴 것이 너무 커질 때 어떻게 줄이는지를 따라갑니다.
두 가지만 구별하는 자리
컴퓨터는 사람의 말을 알아듣지 못하고, 우리가 쓰는 컴퓨터 안에 담기는 것은 모두 1과 0이 늘어선 줄입니다 (OpenStax Introduction Computer Science 5.1). 0과 1 가운데 하나가 들어가는 자리 하나를 비트라고 부릅니다. 점자로 치면 점 자리 하나입니다.
여기서 0과 1은 부품이 구별하는 두 가지 상태에 사람이 붙인 이름입니다. 점자 칸의 자리가 솟음과 평평함 둘 중 하나이듯, 비트 하나도 두 상태 가운데 하나입니다. 계산하는 칩 안에서는 프로세서를 이루는 기본 부품이 전류를 흘려보내는 상태와 막는 상태, 이 두 가지만 가지고, 그 두 상태가 1과 0에 대응합니다 (OpenStax Introduction Computer Science 5.2). 그 부품이 어떻게 전류를 여닫는지는 「트랜지스터는 스위치다 — 전기로 여닫는 아주 작은 수도꼭지」가 다룹니다.
비트는 여덟 개씩 묶어 세기도 합니다. 바이트(byte)는 비트 여덟 개를 한 묶음으로 센 단위입니다. 컴퓨터에 담기는 것은 비트와 바이트의 줄로 저장됩니다 (OpenStax Introduction Computer Science 5.1).
그 줄에 담기는 재료를 따로 부르는 이름이 있습니다. 데이터(data)는 컴퓨터가 담아 두고 다루는 재료로, 노래·사진·글 같은 것입니다. 휴대폰에 내려받은 노래 한 곡도 데이터이고 (OpenStax Introduction Computer Science 5.1), 사진첩에 쌓인 사진 한 장 한 장도 마찬가지입니다. 노래도 사진도 글도, 컴퓨터 안에서는 모두 같은 두 상태의 줄입니다.
자리 하나가 늘 때마다
점자 칸에 점 자리를 하나 보탠다고 생각해 봅시다. 그때까지 만들 수 있던 모양 하나하나가, 새 자리가 솟았느냐 평평하냐에 따라 다시 두 갈래로 나뉩니다. 비트도 똑같습니다. 비트를 하나 더 이을 때마다 나타낼 수 있는 경우가 두 배로 늘어납니다 (OpenStax Introduction Computer Science 5.3). 그래서 점 자리 여섯 개인 점자 한 칸은 두 배를 여섯 번 거듭해 64가지 모양을 만들고, 비트 여덟 개, 곧 1바이트는 여덟 번 거듭해 256가지를 구별합니다.
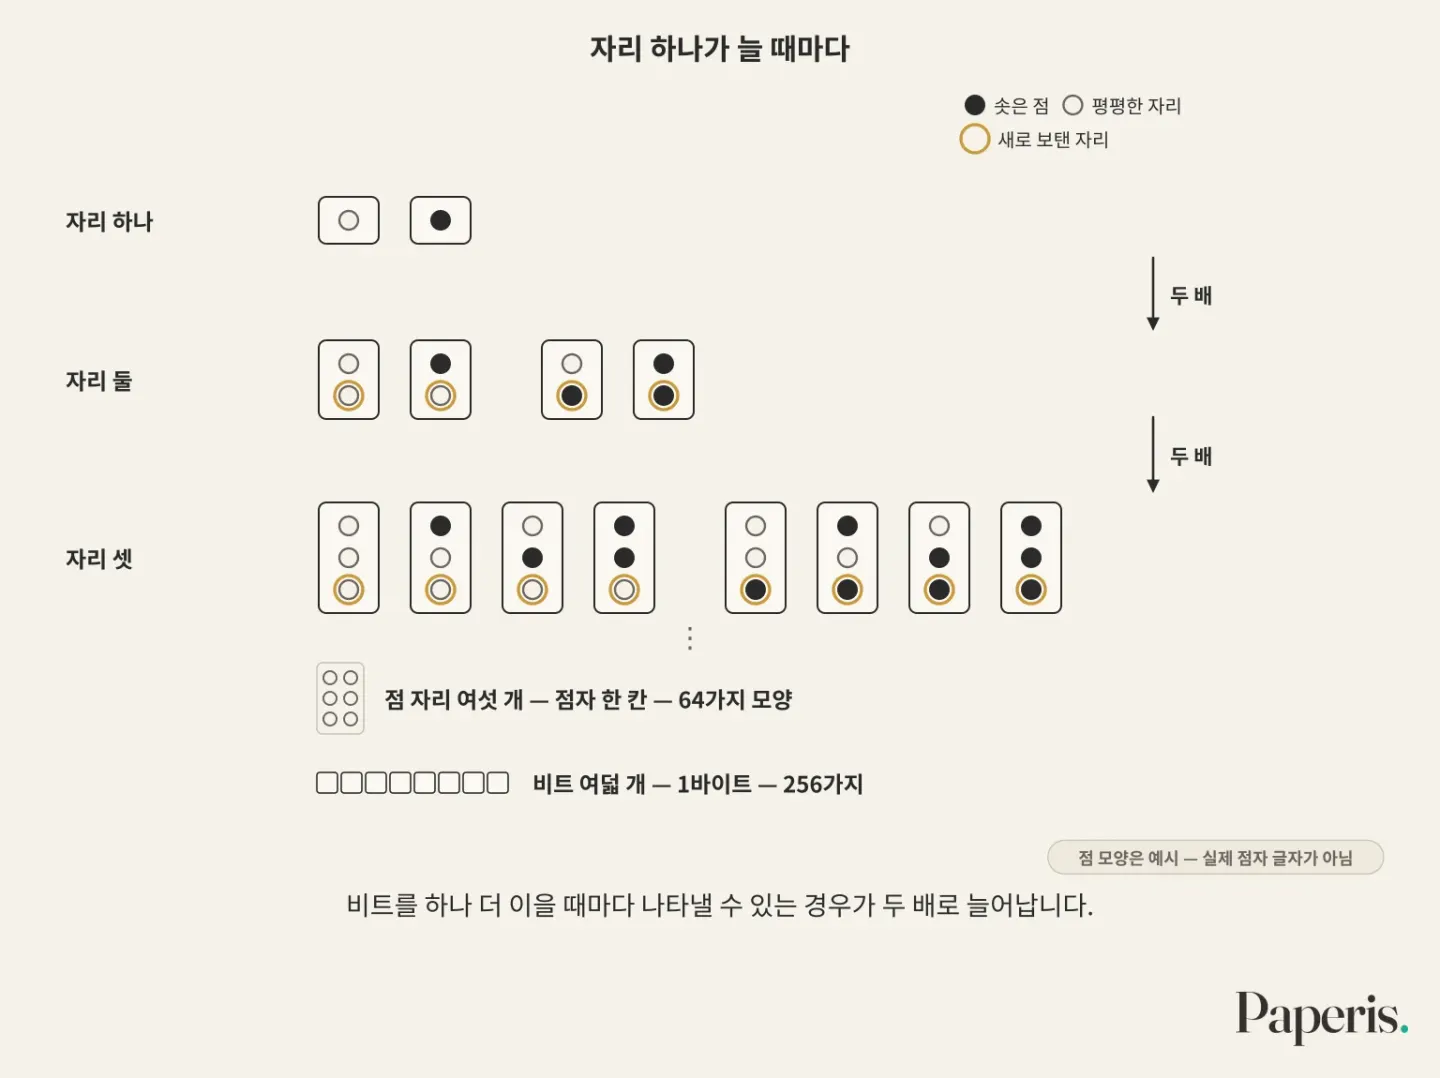
이 경우들에 차례로 수를 붙이면 수를 셀 수 있습니다. 이진법(binary)은 0과 1 두 숫자만으로 수를 나타내는 방법입니다. 우리가 평소 쓰는 십진법에서는 왼쪽으로 한 자리 갈 때마다 자릿값이 열 배가 되고, 이진법에서는 두 배가 됩니다 (OpenStax Introduction Computer Science 5.3). 그래서 이진법의 자릿값은 오른쪽부터 1, 2, 4, 8로 커집니다. 예를 들어 이진법으로 「110」이라고 적으면 4가 한 번, 2가 한 번, 1은 없으니 십진법의 6입니다.
컴퓨터 초창기에는 기계 안쪽을 십진법으로 짤지 이진법으로 짤지를 두고 학계와 업계가 크게 다퉜고, 다툼은 이진법 쪽으로 끝났습니다. 지금 시장에 나온 컴퓨터는 모두 안쪽 구조가 이진법입니다. 한 분광학 잡지의 칼럼은, 특히 화학 데이터를 다루는 분야에서 그 다툼의 흔적이 컴퓨터끼리 데이터를 옮길 때 미처 예상하지 못한 오류로 남아 있다고 짚습니다 (DOI: 10.56530/spectroscopy.mm1179p4).
글자에 매긴 번호
점자 규칙표가 점 모양마다 글자를 정해 두듯, 컴퓨터도 글자마다 번호를 정해 둡니다. 친구에게 보내는 인사 한 줄도 컴퓨터 안에서는 글자마다 이진수 번호 하나로 바뀌어 지나갑니다 (OpenStax Introduction Computer Science 5.3). 문자 부호(character encoding)는 글자마다 어떤 번호를 붙일지 정해 둔 약속입니다. 보내는 컴퓨터와 받는 컴퓨터가 서로 다른 기계라도 같은 번호표를 들고 있어야 글이 그대로 전해지기 때문에, 이 번호표는 여러 기계가 함께 따르는 표준으로 정해 둡니다 (OpenStax Introduction Computer Science 5.3).
오래 쓰여 온 대표적인 문자 부호의 이름이 아스키입니다. 아스키(ASCII)는 영어 알파벳·숫자·기호에 번호를 매긴 문자 부호로, 1963년에 승인됐습니다. 처음 아스키는 7비트로 128자를 담았습니다 (OpenStax Introduction Computer Science 5.3). 앞 절의 셈대로 7비트는 128가지를 구별하니, 그 한 가지마다 글자 하나를 맡긴 것입니다.
인터넷(Internet)으로 세계의 글이 오가기 시작하면서 생긴 여러 문제가 결국 새 번호표를 필요하게 만들었습니다 (DOI: 10.3998/jep.5528). 유니코드(Unicode)는 세계의 모든 문자를 담으려고 만든 문자 부호로, 앞의 128개 번호는 아스키와 똑같이 둡니다. 앞자리가 아스키와 같으니, 아스키를 쓰던 옛 시스템과도 함께 쓸 수 있습니다 (OpenStax Introduction Computer Science 5.3).
번호표가 커진 만큼 글자 하나에 드는 자리도 달라집니다. 아스키 글자는 7비트로 정해졌어도 저장할 때는 하나에 1바이트를 차지하지만, 유니코드 글자 하나는 어떤 방식으로 적어 저장하느냐에 따라 1바이트에서 4바이트까지 차지합니다 (DOI: 10.21917/ijsc.2018.0227). 문자 부호와 얽힌 문제는 연구 데이터를 보관하는 현장에서 드물지 않습니다 (DOI: 10.7191/jeslib.2021.1211). 보낸 쪽과 다른 번호표로 읽으면 같은 비트 줄이 엉뚱한 글자로 바뀌어 보입니다.
그림은 칸으로, 소리는 수로
휴대폰에서 사진을 손가락으로 계속 벌려 키우면 어느 순간 매끄럽던 윤곽이 작은 네모들로 갈라져 보이기도 합니다. 휴대폰 사진 같은 디지털 그림은 바둑판처럼 나뉜 눈금 칸마다 색 값을 적어 담습니다 (DOI: 10.1002/col.21768). 픽셀(pixel)은 디지털 그림을 이루는 바둑판 눈금 한 칸으로, 칸마다 색이 하나씩 정해집니다.
칸의 색은 수로 적습니다. 흔히 빨강·초록·파랑 세 가지가 각각 얼마나 센지를 수로 적어, 그 셋을 섞은 색을 한 칸의 색으로 삼습니다 (DOI: 10.1002/col.21768). 그 수를 매기는 방식에도 약속이 들어 있습니다. 컴퓨터 화면·고화질 방송·디지털 영화에 쓰는 방식 대부분은 값을 조금 바꿨을 때 어두운 쪽에서든 밝은 쪽에서든 눈에 비슷한 만큼 달라 보이도록 수를 매깁니다 (DOI: 10.1002/col.21768). 사진 한 장은 결국 칸마다 적힌 수의 긴 목록입니다.
소리도 수가 됩니다. 마이크에 대고 말하면 그 소리는 1과 0으로 바뀌어 컴퓨터 안에 담기고, 스피커로 나갈 때는 거꾸로 1과 0이 소리로 바뀝니다 (OpenStax Introduction Computer Science 5.1). 저장된 노래 한 곡은 수의 묶음이고, 컴퓨터는 그 수를 읽어 소리를 만들어 냅니다 (OpenStax Introduction Computer Science 5.1). 글자는 번호로, 그림은 칸마다의 색 값으로, 소리는 수의 묶음으로 — 모두 비트의 줄에 담깁니다.
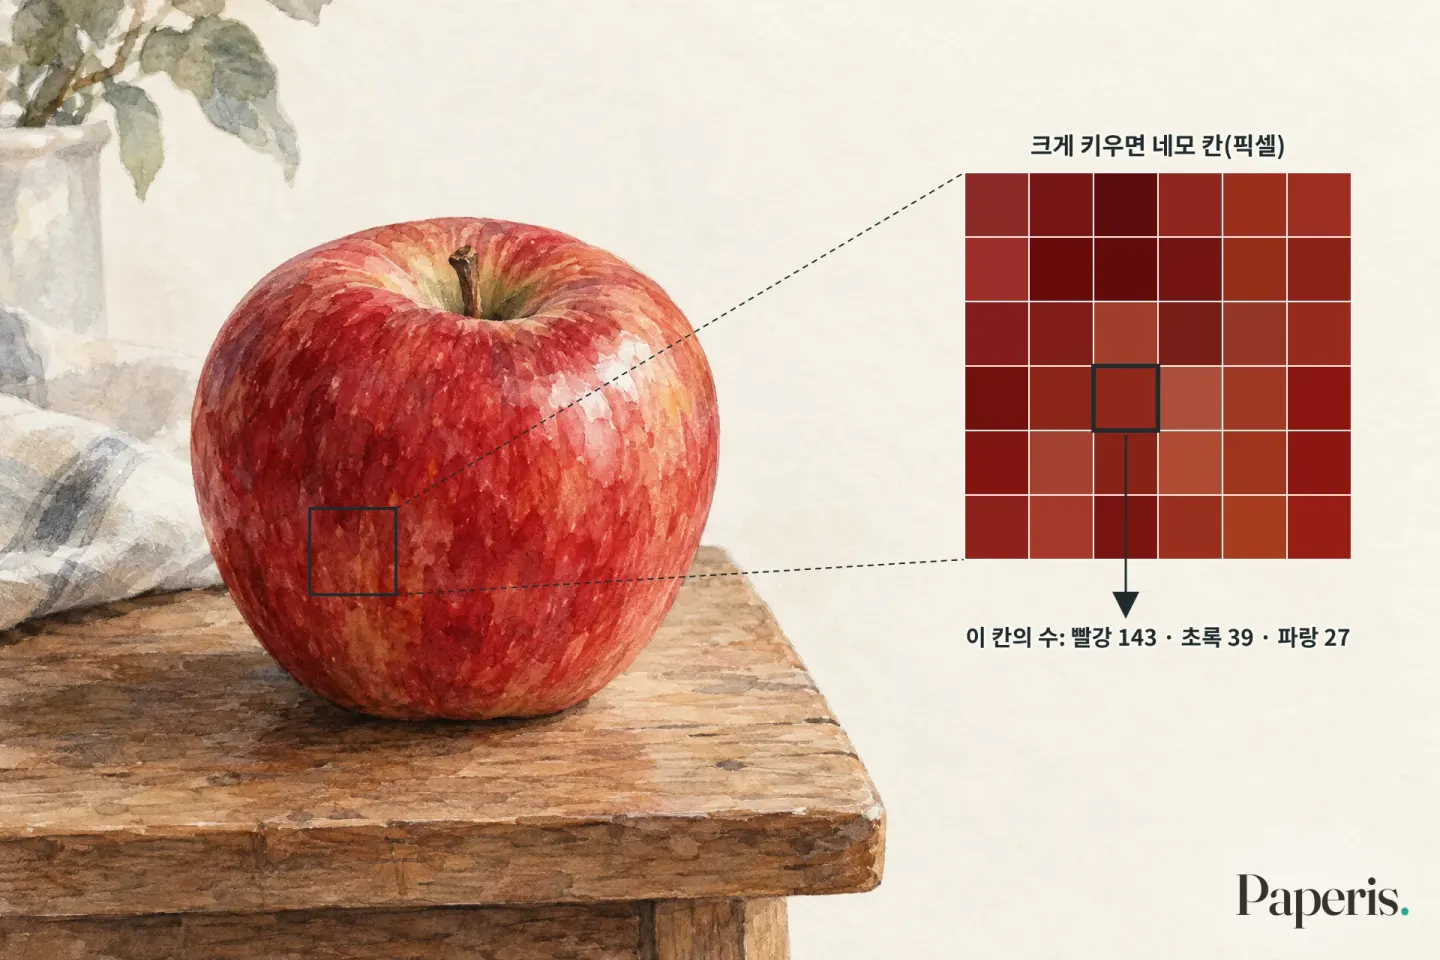
그림: Paperis 삽화(선과 글자는 본문 내용으로 얹은 도식)
같은 여덟 자리, 세 가지 뜻
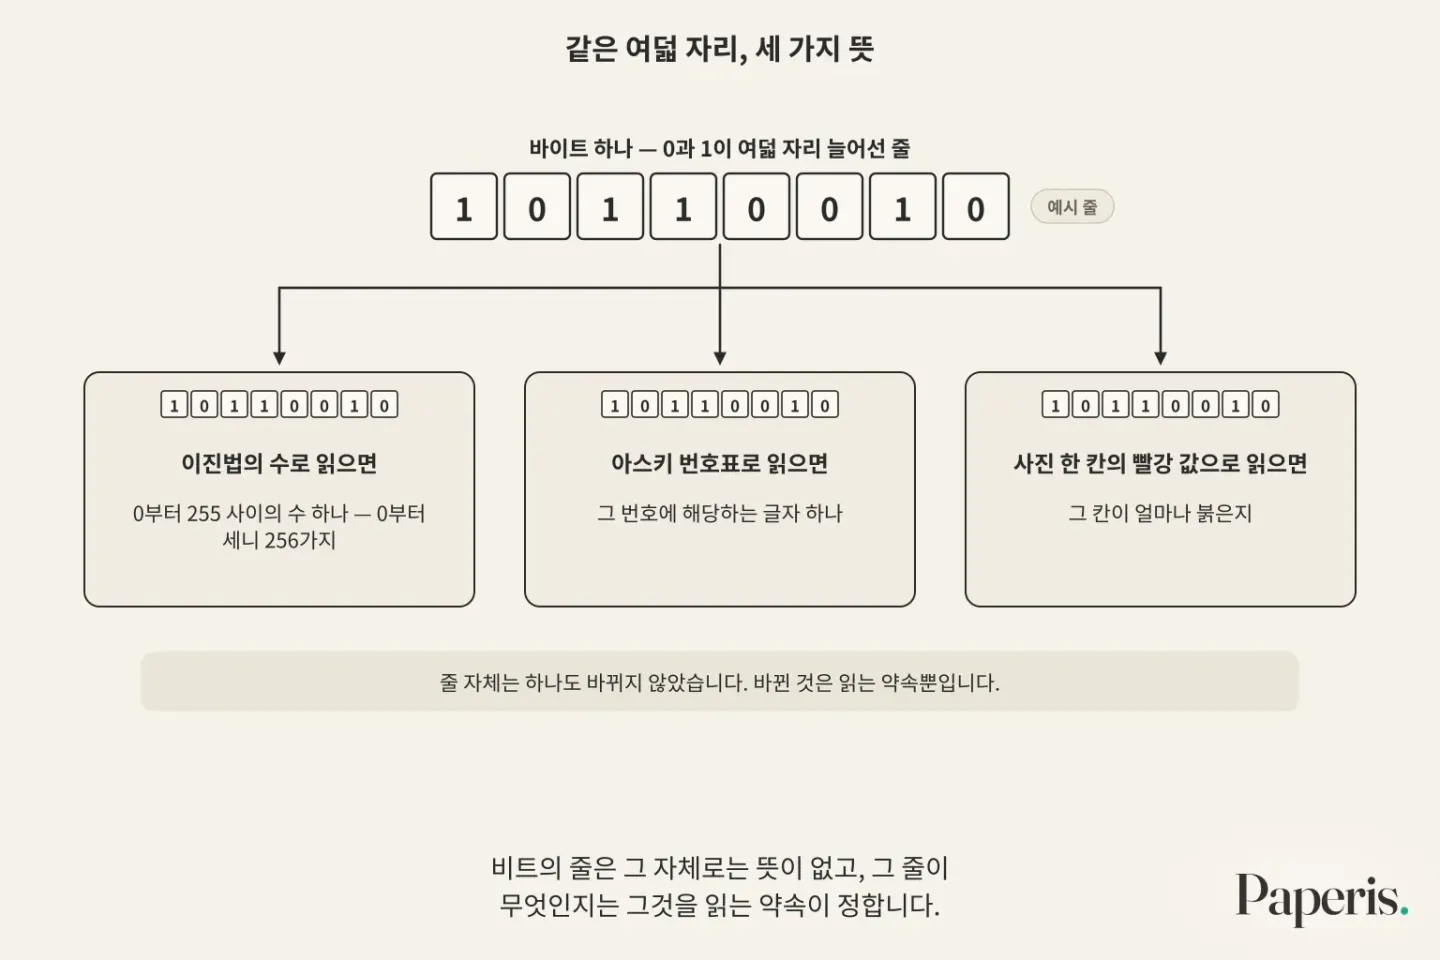
바이트 하나, 곧 0과 1이 여덟 자리 늘어선 줄 하나를 손에 쥐었다고 해 봅시다. 이 줄을 이진법의 수로 읽으면 0부터 255 사이의 수 하나가 됩니다 (OpenStax Introduction Computer Science 5.3). 0부터 세니 256가지입니다. 아스키 번호표로 읽으면 그 번호에 해당하는 글자 하나가 됩니다. 사진 한 칸의 빨강 값으로 읽으면 그 칸이 얼마나 붉은지가 됩니다.
줄 자체는 하나도 바뀌지 않았습니다. 바뀐 것은 읽는 약속뿐입니다. 비트의 줄은 그 자체로는 뜻이 없고, 그 줄이 무엇인지는 그것을 읽는 약속이 정합니다 (OpenStax Introduction Computer Science 5.3). 점자 칸 하나가 앞의 표시에 따라 글자도 되고 숫자도 되는 것과 같습니다.
수나 글자가 아닌 다른 데이터, 예를 들어 그림이나 소리는 담는 방식이 여러 갈래이고, 그중에는 만든 곳이 권리를 쥔 방식도 있습니다 (OpenStax Introduction Computer Science 5.3). 그런 데이터는 그 약속을 아는 앱이 있어야 제대로 열립니다.
크기를 세는 법
데이터의 크기는 바이트로 셉니다. 바이트가 수없이 모이면 더 큰 단위를 씁니다. 메가바이트(megabyte)는 바이트를 100만 개쯤 모은 크기 단위입니다. 바이트 100만 개쯤이 1메가바이트이고, 그보다 큰 단위로는 기가바이트를 씁니다 (OpenStax Introduction Computer Science 5.1).
같은 내용이라도 어떤 약속으로 적느냐에 따라 크기가 달라집니다. 앞에서 본 것처럼 같은 글자가 아스키로는 1바이트, 유니코드로는 1바이트에서 4바이트까지 차지합니다 (DOI: 10.21917/ijsc.2018.0227). 그림은 많은 비트를 씁니다 (DOI: 10.14419/ijet.v7i3.34.19706). 칸마다 색 값을 적기 때문입니다.
줄이는 두 갈래
큰 데이터는 담아 두기도, 멀리 보내기도 부담스럽습니다. 그래서 같은 내용을 더 짧은 줄로 다시 적습니다 (DOI: 10.14419/ijet.v7i3.34.19706). 압축(data compression)은 데이터를 더 적은 비트로 다시 적어 크기를 줄이는 일입니다. 압축하면 저장하고 보내는 비용이 줄어듭니다 (DOI: 10.5194/gmd-12-4099-2019). 압축에는 두 갈래가 있습니다.
첫째 갈래는 하나도 버리지 않습니다. 무손실 압축(lossless compression)은 줄였다가 되살렸을 때 원래와 비트 하나까지 똑같이 돌아오는 압축입니다. 정보를 하나도 잃지 않으니, 되살린 데이터는 원본과 똑같습니다 (DOI: 10.14419/ijet.v7i3.34.19706). 그래도 줄어드는 까닭은 데이터 안에 겹치는 정보가 있기 때문입니다. 사진에서 이웃한 칸들은 서로 닮은 경우가 많아서, 그 겹침을 이용해 다음 칸을 짐작하는 방식이 쓰입니다 (DOI: 10.47893/ijeee.2014.1125).
둘째 갈래는 일부를 버립니다. 손실 압축(lossy compression)은 쓰임에 비춰 받아들일 만한 만큼 정보를 일부 버려서 더 많이 줄이는 압축입니다. 버린 것은 되살려도 돌아오지 않지만, 받아들일 만한 손실로 훨씬 크게 줄입니다 (DOI: 10.14419/ijet.v7i3.34.19706). 사진이라면 사람 눈에 크게 달라 보이지 않는 정보를 버립니다 (DOI: 10.31294/jki.v8i1.7759).
두 갈래의 차이는 숫자로도 드러납니다. 단백질·대사물질 분석에 쓰이는 질량분석기의 데이터를 한 압축 도구로 줄였더니, 무손실로는 원래보다 평균 76%, 손실로는 허용 오차를 정해 두고 평균 94% 작아졌습니다. 이 수치는 그 도구로 그 종류의 데이터를 시험한 결과입니다 (DOI: 10.1093/bioinformatics/btab636).
유전체를 읽은 데이터에서는 손실 압축이 공간을 더 줄일 수 있어도, 많은 쓰임에서 여전히 무손실 압축이 필요합니다 (DOI: 10.1093/bioinformatics/btaa543). 의료 영상의 일부 분야에서는 진단에 중요한 부분만 무손실로 지키고 나머지는 더 줄이는 방법도 연구됩니다 (DOI: 10.47893/ijeee.2014.1125). 버려도 되는 것이 있는지는 그 데이터를 어디에 쓰느냐가 정합니다.
사진 한 장과 인사 한 줄이 건너가는 길
이제 배운 것을 한 번에 따라가 봅시다. 휴대폰으로 친구에게 사진 한 장과 짧은 인사 한 줄, 목소리 메시지 하나를 보낸다고 해 봅시다.
인사 한 줄은 글자마다 유니코드 번호표의 번호로 바뀌고, 그 번호는 적는 방식에 따라 1바이트에서 4바이트의 비트 줄이 됩니다 (DOI: 10.21917/ijsc.2018.0227). 사진은 칸마다 빨강·초록·파랑 값을 적은 긴 수의 목록이고, 그 목록도 결국 비트의 줄입니다 (DOI: 10.1002/col.21768). 목소리는 마이크를 거쳐 수의 묶음이 됩니다 (OpenStax Introduction Computer Science 5.1). 세 가지가 모두 0과 1의 줄이 되었고, 그 줄이 글자인지 색인지 소리인지는 줄만 봐서는 알 수 없습니다 (OpenStax Introduction Computer Science 5.3).
사진은 대개 그중 가장 큰 줄입니다. 이 사진을 손실 압축으로 줄여서 보냈다면, 친구가 받은 사진은 원본과 비트 하나까지 같지는 않습니다. 눈에 크게 띄지 않는 정보를 버렸기 때문에, 보기에는 거의 같아 보입니다.
친구의 휴대폰은 받은 줄을 같은 약속으로 거꾸로 읽습니다. 번호를 유니코드 번호표에 대어 글자로, 칸마다의 값을 색으로, 수의 묶음을 소리로 되돌립니다. 이 가운데 하나라도 다른 약속으로 읽으면, 줄은 그대로인데 엉뚱한 결과가 나옵니다. 글자라면 알아볼 수 없는 기호가 뜹니다. 보내는 쪽과 받는 쪽이 같은 점자 규칙표를 들고 있어야 글이 전해지는 것과 같습니다.
다시 점자 앞에서
점자 비유는 두 군데서 실제와 어긋납니다. 첫째, 점자는 사람이 손끝으로 뜻을 읽습니다. 컴퓨터 안의 부품은 두 상태를 구별할 뿐이고, 그 줄을 글자나 색으로 바꿔 보여 주는 일도 사람이 미리 정해 둔 약속을 따라 계산하는 것입니다. 둘째, 점자의 점은 손에 만져지는 모양입니다. 계산하는 칩 안에서 비트는 부품이 전류를 흘려보내느냐 막느냐 하는 상태이고 (OpenStax Introduction Computer Science 5.2), 그 상태에 0이나 1이라는 숫자가 적혀 있지는 않습니다.
그래도 점자 한 칸이 가르쳐 주는 것은 그대로 남습니다. 두 가지만 구별하는 자리를 여럿 이으면 경우가 두 배씩 늘어나고, 그 조합에 약속을 붙이면 수도 글자도 그림도 소리도 됩니다. 같은 0과 1의 줄을 수로 읽을지 글자로 읽을지 색으로 읽을지는 약속이 정합니다.
어디를 더 볼까
비트의 두 상태를 칩 안에서 만들어 내는 부품은 「트랜지스터는 스위치다 — 전기로 여닫는 아주 작은 수도꼭지」가 다룹니다. 비트로 담긴 데이터가 컴퓨터 안 어디에 놓이고, 전원을 끄면 무엇이 사라지고 무엇이 남는지는 이 시리즈의 다른 편 가운데 「CPU와 메모리 — 비워지는 책상, 남는 서고」가 다룹니다.
데이터가 먼 컴퓨터까지 갈 때 잘게 나뉘어 보내지는 과정은 이 시리즈의 다른 편 가운데 「인터넷 — 나눠 부친 상자, 갈림길마다 길을 고르는 분류소」가 다룹니다. 글자를 번호로 바꾸는 문자 부호는 모두가 함께 쓰는 공개 약속이라 내용을 숨겨 주지 않습니다. 내용을 남이 읽지 못하게 잠그는 일은 「암호화 — 내용은 잠가도 드나든 기록은 남는다」가 다룹니다.
근거 논문
- "Introduction to Computer Science — 5.1 Computer Systems Organization" (2024) — OpenStax Introduction Computer Science 5.1 — 전기로 움직이는 컴퓨터는 프로그램과 데이터를 1과 0의 줄로 저장한다, 8비트가 바이트, 노래는 데이터이며 수의 묶음, 마이크 입력은 1과 0으로 바뀐다, 메가바이트는 100만 바이트쯤, 기가바이트 단위.
- "Introduction to Computer Science — 5.2 Computer Levels of Abstraction" (2024) — OpenStax Introduction Computer Science 5.2 — 프로세서를 이루는 기본 부품(트랜지스터)은 전류를 흘리는 ON과 막는 OFF 두 상태만 가지며, 그 두 상태가 1과 0에 대응한다.
- "Introduction to Computer Science — 5.3 Machine-Level Information Representation" (2024) — OpenStax Introduction Computer Science 5.3 — 비트의 줄은 그 자체로 뜻이 없다, n비트는 2의 n제곱 가지(0부터 2의 n제곱 빼기 1), 십진은 자리마다 열 배·이진은 두 배, 글자마다 고유 이진 번호와 표준인 까닭, 아스키 1963년 승인·7비트 128자, 유니코드는 모든 문자를 담고 앞 128은 아스키라 옛 시스템과 함께 쓴다, 수·글자 아닌 데이터는 형식이 여러 갈래이고 일부는 권리가 걸려 있다.
- "Decimal Versus Binary Representation of Numbers in Computers" (2022) — DOI: 10.56530/spectroscopy.mm1179p4 — 초창기 십진·이진 내부 표현 논쟁은 이진법으로 정리됐고 상용 컴퓨터는 모두 이진 구조이나, 그 흔적이 특히 화학 데이터 분석 분야에서 컴퓨터 간 데이터 이동 때 예상 못 한 오류원으로 남는다(잡지 칼럼).
- "Encoding Multilingualism: Technical Affordances of Multilingual Publication from Manuscripts to Unicode and OpenType" (2024) — DOI: 10.3998/jep.5528 — 인터넷과 전 지구적 텍스트 전송이 낳은 문제들이 유니코드를 필요하게 만들었다(유니코드 아카이브 기반 역사).
- "LOSSLESS TEXT COMPRESSION FOR UNICODE TAMIL DOCUMENTS" (2018) — DOI: 10.21917/ijsc.2018.0227 — 아스키 문자는 1바이트, 유니코드 문자는 저장 방식에 따라 1~4바이트.
- "Plain Text & Character Encoding: A Primer for Data Curators" (2021) — DOI: 10.7191/jeslib.2021.1211 — 평문은 부호화된 문자(코드 포인트)의 줄이며, 텍스트 인코딩 문제는 연구 데이터 큐레이션에서 드물지 않다.
- "Perceptual uniformity in digital image representation and display" (2013) — DOI: 10.1002/col.21768 — 픽셀의 빨강·초록·파랑 성분을 수(코드 값)로 나타내며, sRGB·BT.709 등 대부분의 방식은 값의 작은 변화가 범위 전체에서 비슷하게 지각되도록 부호화한다.
- "Comparative Study of Lossy and Lossless Image Compression Techniques" (2026) — DOI: 10.14419/ijet.v7i3.34.19706 — 이미지는 많은 비트를 쓰고, 무손실 압축은 정보 손실 없이, 손실 압축은 받아들일 만한 손실로 높은 압축을 얻는다.
- "IMPLEMENTASI KOMPRESI CITRA DIGITAL DENGAN MEMBANDINGKAN METODE LOSSY DAN LOSSLESS COMPRESSION MENGGUNAKAN MATLAB" (2020) — DOI: 10.31294/jki.v8i1.7759 — 손실 압축은 정보 일부를 없애되 사람 눈에 큰 변화가 없도록 한다.
- "LOSSLESS AND LOSSY IMAGE COMPRESSION BASED ON DATA FOLDING" (2014) — DOI: 10.47893/ijeee.2014.1125 — 이웃 화소의 중복성을 예측에 쓰는 압축, 의료 영상에서 관심 영역만 무손실로 지키는 방식.
- "Evaluation of lossless and lossy algorithms for the compression of scientific datasets in netCDF-4 or HDF5 files" (2019) — DOI: 10.5194/gmd-12-4099-2019 — 늘어나는 과학 데이터의 저장·전송 비용을 줄이려면 압축이 필요하다.
- "mspack: efficient lossless and lossy mass spectrometry data compression" (2021) — DOI: 10.1093/bioinformatics/btab636 — 질량분석 데이터에서 무손실 평균 76%, 손실 평균 94% 파일 크기 감소(bsc 백엔드, 손실은 설정한 오차 범위, 원본 대비).
- "ScaleQC: a scalable lossy to lossless solution for NGS data compression" (2020) — DOI: 10.1093/bioinformatics/btaa543 — 손실 압축이 공간을 더 줄일 수 있지만 많은 응용에서 여전히 무손실 압축이 필요하다.