Paperis 아티클
DNA와 유전자 — 네 글자로 적은 설명서, 서로의 거푸집인 두 가닥
네 가지 염기로 적힌 정보, 짝을 맞춘 두 가닥이 반쪽씩 나뉘어 되살아나는 복제, 2미터를 핵 안에 감아 넣는 염색체, 그리고 사람 유전체에서 단백질을 만드는 정보가 적힌 자리가 얼마나 되는지까지 따라갑니다.
DNA와 유전자 — 네 글자로 적은 설명서, 서로의 거푸집인 두 가닥
아무는 상처
무릎이 살짝 까지면 며칠 사이에 그 자리가 새 살로 덮입니다. 새로 난 살은 원래 있던 것과 같은 피부입니다. 상처 가장자리의 살이 불어나 빈자리를 메운 것입니다.
아이가 부모를 닮는 것도 비슷한 일입니다. 아이는 부모에게서 몸을 만드는 방법을 물려받습니다.
두 장면 모두 두 가지를 전제합니다. 몸을 만드는 방법이 어딘가에 적혀 있어야 하고, 그 기록이 나뉠 때마다 거의 틀리지 않고 베껴져야 합니다. 이 글은 그 기록이 무엇으로 쓰여 있고, 어떻게 베껴지고, 어디에 접혀 보관되는지 따라갑니다. 마지막에는 그 긴 기록 가운데 몸을 만드는 정보가 실제로 적힌 자리가 얼마나 되는지 봅니다.
핵에서 꺼낸 물질
그 기록이 담긴 물질은 1860년대에 백혈구의 핵(nucleus)에서 처음 나왔습니다. 의사 프리드리히 미셔가 핵에서 인이 많이 든 물질을 뽑아내 「뉴클레인」이라고 불렀고, 이 물질이 훗날 DNA로 알려집니다 (OpenStax Biology 2e 14.1). DNA는 세포(cell)가 유전(heredity) 정보를 담아 두는 긴 분자로, 네 가지 염기(nucleobase)가 늘어선 순서가 곧 그 정보입니다. 염기는 DNA 사슬의 칸마다 하나씩 붙은 작은 분자로, 아데닌(A)·티민(T)·구아닌(G)·사이토신(C) 네 가지가 있습니다.
세포는 이 정보를 읽어 두 가지 분자를 만듭니다. RNA는 DNA의 정보를 옮겨 적거나 그 정보를 읽는 데 쓰이는, DNA와 닮은 분자입니다. 단백질(protein)은 아미노산(amino acid)이 사슬처럼 이어져 접힌 분자로, 세포 안에서 대부분의 일을 합니다. 생물은 DNA에서 읽어 낸 RNA와 단백질로 살아갑니다 (PMID 31652314). 이 글은 DNA를 세포가 들고 다니는 설명서로, RNA를 거기서 옮겨 적은 사본으로, 단백질을 그 설명대로 만든 일꾼으로 부릅니다. 설명서가 사본을 거쳐 일꾼이 되는 길은 「유전자에서 단백질로 — 세 글자씩 읽는 사본, 저마다 펼치는 쪽」이 따라갑니다.
DNA가 대물림되는 정보를 실어 나른다는 사실은 미셔로부터 80년쯤 뒤에 드러났습니다. 1944년 연구자 오즈월드 에이버리와 콜린 매클라우드, 매클린 매카티는 폐렴을 일으키는 세균(bacterium)의 한 품종에서 뽑은 물질로 다른 품종의 성질을 바꿔 놓았습니다. 그 물질에서 단백질이나 RNA를 분해해도 성질은 바뀌었고, DNA를 분해했을 때만 바뀌지 않았습니다 (OpenStax Biology 2e 14.1). 뒤이은 실험들이 DNA가 유전 물질이라는 것을 굳혔습니다 (OpenStax Biology 2e 14). 거의 모든 생물이 설명서를 DNA로 적고, 바이러스(virus) 가운데에는 RNA로 적은 것도 있습니다 (OpenStax Biology 2e 21.1).
세균에서 사람까지, 몸을 만드는 방법은 DNA라는 한 가지 분자에 적혀 있습니다.
네 글자
DNA 사슬의 칸 하나는 당과 인산과 염기 하나로 되어 있고, 이 칸들이 길게 이어져 사슬이 됩니다 (OpenStax Biology 2e 3.5). 당과 인산이 번갈아 이어져 사슬의 뼈대가 되고, 염기는 그 뼈대에 하나씩 매달립니다 (OpenStax Biology 2e 14.2).
글자가 넷뿐인 설명서입니다. 그래도 적을 수 있는 내용은 아주 많습니다. 같은 네 글자라도 「GATTACA」와 「ACATTAG」는 다른 줄이고, 줄이 길어질수록 만들 수 있는 순서의 가짓수가 빠르게 불어납니다.
오스트리아 출신 생화학자 에르빈 샤가프는 DNA의 네 염기를 세어 보다가 규칙 하나를 찾았습니다. 어느 생물의 DNA든 A와 T의 양이 같고, G와 C의 양이 같았습니다. 네 염기가 차지하는 비율 자체는 생물 종마다 달랐습니다 (OpenStax Biology 2e 14.1; OpenStax Biology 2e 14). 비율이 종마다 다르다는 것은 생물마다 DNA에 적힌 내용이 다르다는 단서입니다. A와 T, G와 C가 늘 같은 양이라는 것은 다음 절에서 풀리는 수수께끼였습니다.
설명서의 내용은 A·T·G·C 네 글자가 늘어선 순서입니다.
두 가닥, 짝
샤가프의 수수께끼는 DNA의 모양이 드러나면서 풀렸습니다. 그 모양을 밝힌 것은 1950년대 영국 케임브리지 대학의 연구자 제임스 왓슨과 프랜시스 크릭입니다. 그 바탕에는 다른 연구실의 연구자 로절린드 프랭클린이 X선으로 얻은 자료가 있었습니다 (OpenStax Biology 2e 14.2).
이중나선(double helix)은 DNA의 두 가닥이 서로를 감고 꼬인 모양입니다. 두 가닥의 뼈대는 바깥에 있고, 염기는 안쪽으로 향해 맞은편 가닥의 염기와 마주 봅니다 (OpenStax Biology 2e 14.2). 염기쌍(base pair)은 마주 보는 두 가닥에서 서로 짝을 이룬 염기 두 개로, A는 늘 T와, G는 늘 C와 짝을 짓습니다. 샤가프가 센 「A와 T가 같은 양」은 이 짝 맞춤에서 나옵니다. A 하나마다 맞은편에 T가 하나씩 있기 때문입니다 (OpenStax Biology 2e 14.2).
짝에는 크기의 규칙도 있습니다. A와 G는 고리가 둘인 큰 염기이고, C와 T는 고리가 하나인 작은 염기입니다 (OpenStax Biology 2e 3.5). 큰 염기는 늘 작은 염기와 짝을 지어서 짝마다 크기가 같아지고, 두 가닥이 서로 반대 방향으로 놓인 것과 함께 이중나선의 폭을 어디서나 2나노미터로 고르게 합니다 (OpenStax Biology 2e 14.2). 나선을 한 바퀴 돌 때마다 염기쌍이 열 개씩 들어갑니다 (OpenStax Biology 2e 14).
그러면 두 가닥 가운데 하나를 잃어도 잃는 것이 없습니다. T가 남은 자리 맞은편에는 A만, C가 남은 자리 맞은편에는 G만 올 수 있어서, 사라진 쪽의 글자를 남은 쪽에서 한 글자씩 되읽어 낼 수 있습니다 (OpenStax Biology 2e 14.3). 마주 보는 자리끼리 맞대 보면, 한쪽 「ATGC」의 맞은편은 「TACG」입니다. 거푸집이 물건의 모양을 뒤집어 품고 있듯, DNA의 한 가닥은 맞은편 가닥의 거푸집입니다.
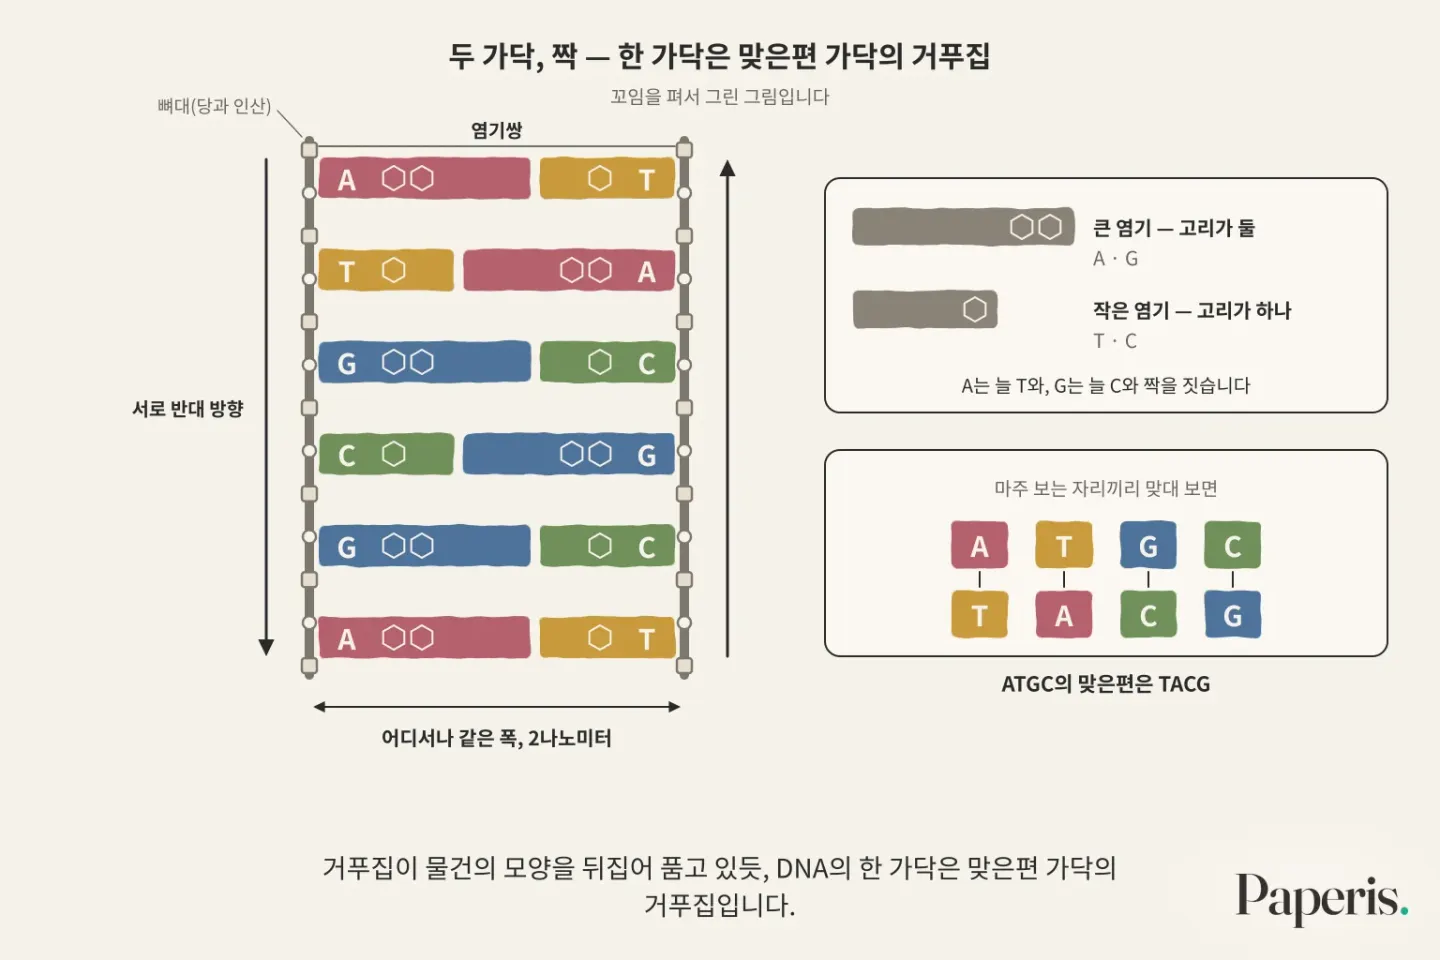
두 가닥은 정해진 짝으로 맞물려 있어서, 한 가닥이 다른 가닥을 정합니다.
반쪽에서 되살아나는 짝
거푸집이 있으면 같은 물건을 몇 번이고 다시 찍어 낼 수 있습니다. 세포도 나뉘기 전에 DNA를 그렇게 한 벌 더 찍어 냅니다.
DNA 복제(DNA replication)는 세포가 나뉘기 전에 DNA를 한 벌 더 똑같이 만드는 일입니다. 복제가 시작되면 마주 보던 염기들이 서로 떨어집니다. 혼자 남은 가닥마다 맞은편 자리가 비고, DNA를 베끼는 효소(enzyme)가 그 빈자리를 맞는 짝 염기로 하나씩 메웁니다 (OpenStax Biology 2e 14.3; OpenStax Biology 2e 14.4). 남은 가닥이 거푸집 노릇을 하고, 이렇게 해서 한 벌이 두 벌이 됩니다.
다만 새 두 벌에 헌 가닥과 새 가닥이 어떻게 나뉘어 들어가는지는 처음엔 분명하지 않았고, 후보로 오른 방식이 여럿이었습니다 (OpenStax Biology 2e 14.3). 반보존적 복제(semiconservative replication)는 새로 생긴 DNA 두 벌이 저마다 원래 가닥 하나와 새 가닥 하나로 이루어지는 복제 방식입니다. 이를 가른 것은 연구자 메셀슨과 스탈의 대장균 실험입니다. 두 사람은 무거운 질소로 DNA에 표시를 해 둔 대장균을 가벼운 질소 속에서 불어나게 하며 DNA의 무게를 쟀습니다. 한 번 나뉜 뒤에는 모든 DNA가 무거운 것과 가벼운 것의 중간 무게였는데, 이것만으로는 헌 가닥과 새 가닥이 한 가닥씩 짝을 지었는지, 조각조각 섞였는지 가를 수 없었습니다. 두 번 나뉜 뒤에는 중간 무게와 가벼운 것의 두 무리로 갈렸고, 두 결과를 함께 설명하는 방식은 반보존적 복제뿐이었습니다 (OpenStax Biology 2e 14.3). 대장균에서 나온 결과이고, 사람 세포도 같은 기본 단계를 밟습니다 (OpenStax Biology 2e 14.5).
베끼는 속도는 생물마다 다릅니다. 대장균은 염기쌍 460만 개짜리 DNA를 약 42분에 다 베끼고, 1초에 염기 1,000개쯤을 붙입니다 (OpenStax Biology 2e 14.4). 사람 세포는 1초에 100개쯤으로 훨씬 느립니다. 대신 긴 DNA 한 줄에 베끼기를 시작하는 자리가 여러 곳 있고, 사람 세포의 DNA 전체로는 최대 10만 곳에 이릅니다. 사람 세포는 나뉘기 전에 염기쌍 60억 개를 베낍니다 (OpenStax Biology 2e 14.5).
60억 개를 베끼는 동안 틀림은 세 겹으로 걸러집니다. 베끼는 효소는 거의 언제나 맞는 염기를 고르고, 가끔 틀린 염기를 붙이면 그것을 떼어 낼 수 있고, 그래도 빠져나간 드문 틀림은 새 DNA를 훑는 수선 과정이 대부분 고칠 수 있습니다 (PMID 35850061). 교정(proofreading)은 DNA를 베끼는 효소가 잘못 붙은 염기를 떼어 내고 다시 붙이는 일입니다. 사람의 DNA에는 교정과 손상 수선을 맡는 단백질을 만드는 정보가 수백 군데 적혀 있습니다 (PMID 37936448).
그래도 바뀜은 남습니다. 돌연변이(mutation)는 DNA의 염기 순서가 바뀐 것입니다. 사람 세포는 평생 DNA에 바뀜을 쌓아 갈 수 있고, 그 가운데 일부는 세포가 나뉘며 DNA를 베낄 때 생깁니다 (PMID 37936448). 바뀜이 무엇을 낳는지는 「유전과 변이 — 두 벌에서 한 장씩, 새로 섞이는 패」가 다룹니다.
가닥이 반쪽씩 나뉘고 저마다 짝을 되살려서, DNA 한 벌이 거의 틀림없는 두 벌이 됩니다.
2미터를 접어 넣기
사람 세포 하나의 핵에 든 DNA를 한 줄로 이으면 길이가 2미터쯤 됩니다. 그 DNA가 지름 5~15마이크로미터, 곧 1밀리미터의 100분의 1 안팎인 핵 안에 들어 있습니다 (PMID 39820859).
이 길이를 넣으려면 DNA를 감고 또 감아야 합니다. 히스톤(histone)은 DNA가 감기는 실패 노릇을 하는 단백질입니다. DNA는 대부분 히스톤 뭉치에 감겨 구슬을 꿴 줄 같은 모양이 되고, 이 줄이 더 굵은 섬유로 감기고, 섬유가 다시 고리를 지어 접힙니다. 그렇게 염색체마다 DNA는 처음 길이의 1만분의 1쯤으로 줄어듭니다 (PMID 1364580).
염색체(chromosome)는 긴 DNA가 단백질과 함께 접혀 뭉쳐진 꾸러미입니다. 염색체 하나에는 아주 긴 DNA 분자 하나가 들어 있습니다 (PMID 1364580). 사람 몸의 세포에는 염색체가 46개 있고, 이것은 23쌍입니다. 한 쌍의 두 염색체는 하나는 어머니에게서, 하나는 아버지에게서 왔습니다 (OpenStax Biology 2e 10.1). 염색체 수는 생물 종마다 정해져 있어서, 초파리는 8개입니다. 세균의 DNA는 대개 고리 모양의 염색체 하나에 들어 있습니다 (OpenStax Biology 2e 4.3). 세균의 DNA는 히스톤에 감기는 대신 꼬여서 접힙니다 (OpenStax Biology 2e 14.2).
세포가 나뉠 채비를 할 때가 되어야 염색체는 현미경 아래에서 막대 모양으로 뭉쳐 보입니다. 평소에는 풀어진 채 핵 안에 퍼져 있습니다 (OpenStax Biology 2e 4.3). 감아 둔 것은 베낄 때 풀어야 합니다. 복제할 때 히스톤을 떼어 냈다가 다시 감아야 해서, 사람 세포의 복제가 대장균보다 느린 이유 가운데 하나가 됩니다 (OpenStax Biology 2e 14.5).
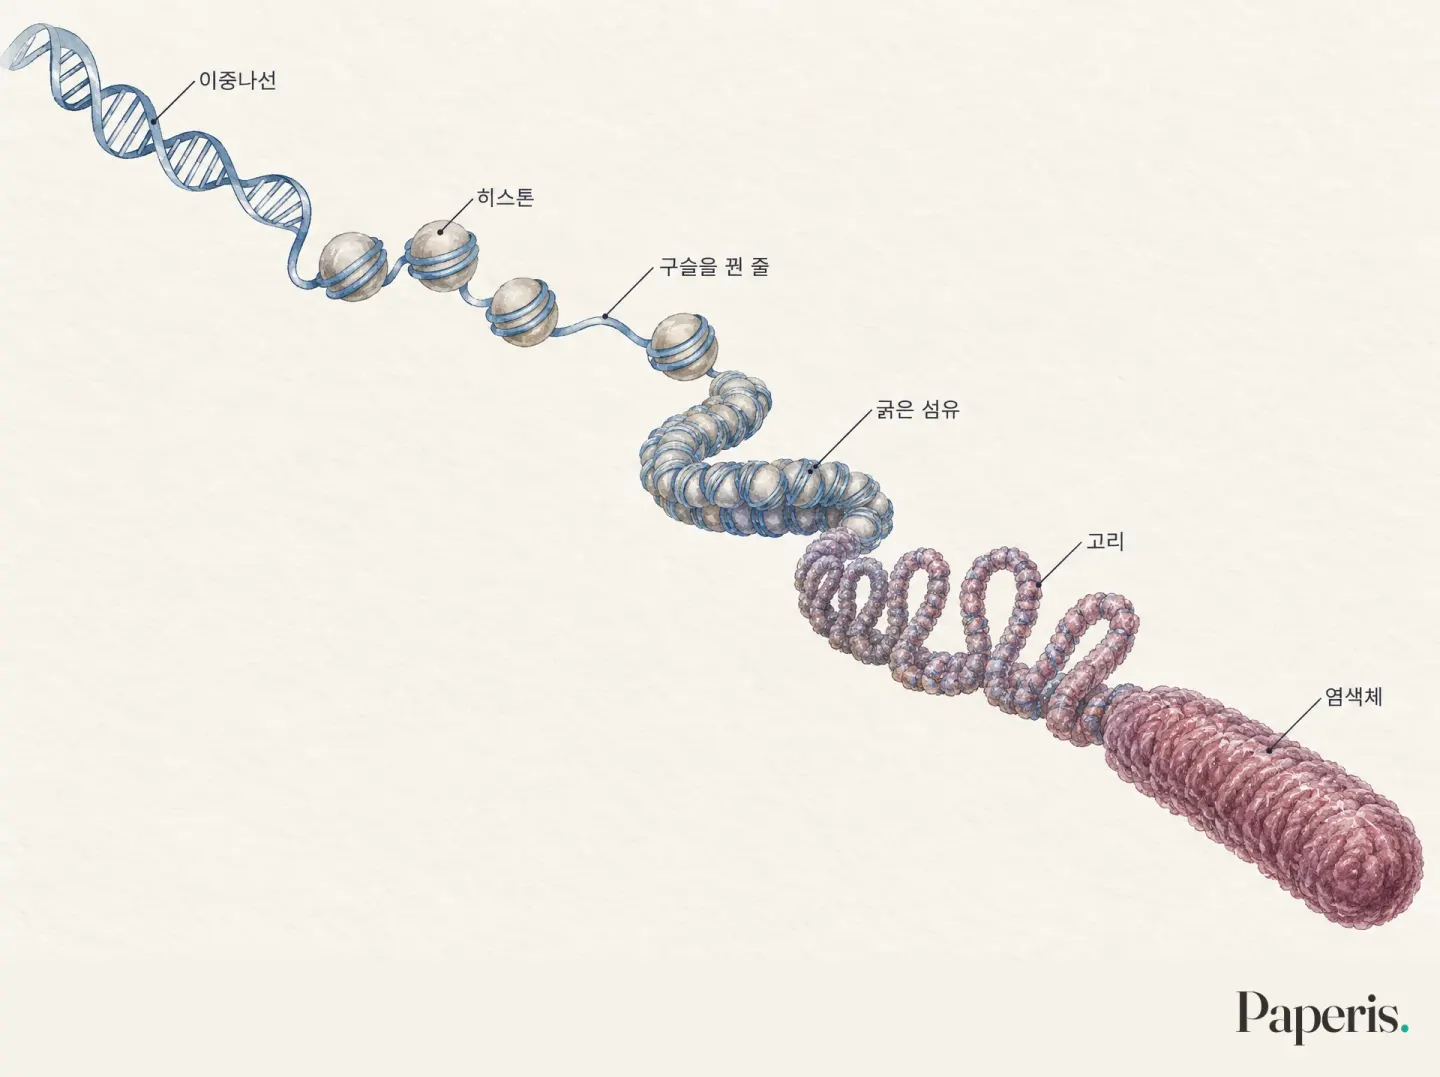
2미터의 설명서는 히스톤에 감기고 접혀 46개의 꾸러미로 핵 안에 들어갑니다.
설명서의 한 항목
유전자(gene)는 DNA에서 단백질이나 일하는 RNA를 만드는 정보가 적힌 구간입니다. 설명서로 말하면 유전자는 「무엇을 만드는 법」이 적힌 항목 하나입니다.
사람에게 단백질을 만드는 유전자가 몇 개 있는지는 지금도 세는 중입니다. 사람 DNA의 첫 초안이 2001년에 나온 뒤로 과학자들은 유전자를 하나하나 목록에 올려 왔고, 단백질을 만드는 유전자는 2만 개가 조금 안 되는 것으로 추정됩니다 (PMID 37794265). 이 숫자는 추정치이고, 단백질 대신 RNA인 채로 일하는 유전자는 보고되는 수가 빠르게 늘고 있습니다 (PMID 37794265).
「유전자」라는 말의 뜻도 하나로 굳어 있지 않습니다. 이 말의 뜻은 지난 100년 동안 바뀌어 왔습니다. 19세기 오스트리아 수도사 그레고어 멘델과 그 뒤 연구자들에게는 대물림을 일으키는 보이지 않는 단위였고, 오늘날의 서열 자료에서는 단백질 정보가 적힌 DNA 구간입니다 (PMID 17567988). 2000년대의 대규모 조사에서 DNA 곳곳에서 RNA가 널리 만들어지는 것이 드러나면서 이 정의도 흔들렸습니다. 2007년의 한 종설은 유전자를 「서로 겹칠 수 있는 일하는 산물을 만드는 DNA 서열들의 묶음」으로 고쳐 쓰자고 제안했습니다 (PMID 17567988). 단백질을 만드는 유전자가 단백질 대신 RNA로 일하는 산물을 함께 내놓기도 해서, 유전자를 「단백질을 만드는 것」과 「만들지 않는 것」으로 딱 가르기도 어렵습니다 (PMID 30146915).
유전자는 설명서의 한 항목이고, 사람에게는 단백질을 만드는 항목이 2만 개가 조금 안 되는 것으로 추정됩니다.
설명서 전체
유전체(genome)는 한 생물이 가진 유전 정보 한 벌 전체이고, 게놈이라고도 부릅니다. 사람의 유전체 한 벌은 염기쌍 약 30억 개입니다. 몸의 세포는 어머니와 아버지에게서 받은 두 벌을 지녀서, 나뉠 때 60억 개를 베낍니다 (OpenStax Biology 2e 14.5).
이 설명서를 처음부터 끝까지 읽는 데는 오래 걸렸습니다. 첫 초안 이후로도 사람 유전체의 표준 서열은 오랫동안 빈틈이 남아 있었고, 사람들 사이의 다양함도 담지 못했습니다. 염색체의 잘록한 자리와 양 끝처럼 읽기 어렵던 곳까지 빈틈 없이 채운 서열과, 세계 여러 집단의 차이를 함께 담은 범유전체가 최근에야 나왔습니다 (PMID 38663087). 그때까지 비어 있던 유전체의 8%쯤을 마저 채워 2022년에 내놓은 사람 유전체 서열 한 벌은 Y 염색체를 뺀 모든 염색체를 빈틈 없이 이었고, 길이는 염기쌍 30억 5,500만 개였습니다 (PMID 35357919).
사람의 단백질 유전자 수는 핵을 가진 생물 가운데 훨씬 단순한 것들과 견주어 크게 많지 않습니다 (PMID 30146915). 그리고 사람 유전체에서 단백질을 만드는 정보가 적힌 자리는 2%가 안 됩니다 (PMID 24747961). 비암호화 DNA(noncoding DNA)는 유전체 가운데 단백질을 만드는 정보가 적히지 않은 부분입니다. 사람 유전체의 98% 넘게가 비암호화 DNA입니다 (PMID 24747961).
설명서 전체는 30억 글자쯤이고, 그 가운데 단백질을 만드는 법이 적힌 쪽은 2%가 안 됩니다.
나머지 98%
나머지 98%는 한때 의심을 받았습니다. 단백질을 만들지 않는 RNA가 이 부분에서 대량으로 만들어진다는 것이 드러나자, 그 RNA가 쓸모없는 잡음일 수 있다는 걱정이 나왔고, 이 부분은 유전체의 「암흑 물질」로 불렸습니다 (PMID 27479746).
전이인자(transposable element)는 유전체 안에서 제 사본을 다른 자리에 끼워 넣으며 퍼져 온 DNA 조각입니다. 전이인자는 포유류 유전체의 절반쯤을 차지해, 나머지 98%에서 큰 몫이 됩니다 (PMID 35228718). 그 가운데 큰 무리인 레트로트랜스포존은 제 몫만 불리는 기생체로 여겨지곤 했습니다 (PMID 37949723). 그런데 전이인자는 옮겨 다니는 힘을 잃은 뒤에도 주변 유전자의 쓰임에 영향을 줄 수 있습니다. 유전자의 쓰임을 조절하는 자리를 내주거나, 새로운 조절 유전자가 되기도 합니다 (PMID 35228718). 포유류의 초기 배아에서는 레트로트랜스포존이 발달 초기의 중요한 과정에 관여한다는 연구들이 나왔습니다 (PMID 37949723).
비암호화 RNA(noncoding RNA)는 단백질을 만드는 데 쓰이지 않고, RNA인 채로 일하는 RNA입니다. 비암호화 DNA에서는 이런 RNA가 많이 만들어집니다. 그 가운데 긴 것들의 상당수는 세포 종류에 따라 다르게 만들어지고 세포 안의 정해진 자리로 가서, 단순한 잡음으로 보기 어렵습니다 (PMID 19571179). 먼 거리에서 유전자의 쓰임을 바꾸는 자리도 비암호화 DNA 안에 있습니다 (PMID 38546891). 비암호화로 분류되던 자리에서 작은 단백질이 만들어진다는 보고도 있어, 경계 자체가 흐려지고 있습니다 (PMID 37897910).
반대쪽 사실도 같은 무게로 있습니다. 보고된 비암호화 RNA 유전자 대부분은 지금으로서는 무슨 일을 하는지 분명하지 않습니다 (PMID 37794265). 작은 단백질도 얼마나 많고 그중 얼마만큼이 중요한 일을 하는지 아직 수수께끼입니다 (PMID 37897910).
98% 가운데 일부는 유전자의 쓰임을 조절하는 일을 하고, 얼마만큼이 일을 하는지는 아직 다 밝혀지지 않았습니다.
상처 가장자리의 한 세포
처음의 무릎으로 돌아가 봅니다. 상처 가장자리에서 피부 세포 하나가 나뉠 준비를 합니다.
그 세포의 핵에는 46개의 염색체에 나뉘어 감긴 DNA가 있습니다. 베끼려면 감긴 것을 풀어야 해서, DNA가 히스톤에서 떨어집니다 (OpenStax Biology 2e 14.5). 염색체마다 여러 곳에서 마주 보던 염기가 떨어지고 (OpenStax Biology 2e 14.5), 혼자 남은 가닥이 거푸집이 됩니다 (OpenStax Biology 2e 14.3). 효소가 거푸집의 A 맞은편에는 T를, G 맞은편에는 C를 채우며 60억 쌍을 베낍니다 (OpenStax Biology 2e 14.4; OpenStax Biology 2e 14.5). 잘못 붙은 염기는 교정이 떼어 내고, 빠져나간 드문 틀림은 수선 과정이 대부분 고칠 수 있습니다 (PMID 35850061). 베낀 DNA 두 벌은 붙은 채로 있다가 둘로 갈라져, 유전적으로 같은 두 세포로 들어갑니다 (OpenStax Biology 2e 10.2).
새로 생긴 피부 세포는 그렇게 설명서 전체를 받습니다. 그런데 세포는 받은 설명서를 다 펼치지는 않습니다. 사람 뇌 하나에만 세포 종류가 3,000가지가 넘고, 세포 종류마다 같은 유전체에서 쓰는 유전자의 무늬가 다릅니다. DNA 순서를 바꾸지 않고 유전자의 쓰임을 바꾸는 과정들이 그 무늬를 만드는 데 관여합니다 (PMID 39820859).
DNA는 무엇을 만들 수 있는지를 적어 두고, 그 가운데 무엇을 펼칠지는 세포 종류마다 다릅니다. 설명서를 지녔다는 것과 무엇이 만들어질지가 다 정해졌다는 것은 다른 말입니다.
설명서라는 비유에도 한계가 있습니다. 종(species)이 설명서는 항목마다 경계가 분명하지만, 유전자는 서로 겹치는 산물을 내고 단백질을 만드는 것과 만들지 않는 것의 경계도 흐립니다 (PMID 17567988). 이 비유는 「순서로 적힌 정보」와 「베껴서 물려준다」까지만 정확합니다.
어디를 더 볼까
비암호화 DNA에서 만들어지는 RNA 가운데 대부분은 아직 무슨 일을 하는지 분명하지 않습니다 (PMID 37794265).
DNA에 적힌 글로 조상의 이야기를 읽는 일은 「유전자가 말하는 것 — 대대로 베껴 쓴 낡은 책 한 권」에서 볼 수 있습니다. 유전자에 적힌 순서가 접혀 단백질의 모양이 되는 문제는 「서열에서 형태로: AlphaFold는 어떻게 50년 난제를 풀었나」가 다룹니다.
이 시리즈의 다른 편들은 이 글이 열어 둔 문을 하나씩 따라갑니다. 「세포란 무엇인가 — 담장을 두른 작은 마을, 둘로 갈라서는 마을」은 DNA가 든 핵과 세포가 나뉘는 과정을, 「유전자에서 단백질로 — 세 글자씩 읽는 사본, 저마다 펼치는 쪽」은 유전자가 RNA로 옮겨 적히고 단백질로 바뀌는 과정을 봅니다. 「유전과 변이 — 두 벌에서 한 장씩, 새로 섞이는 패」는 부모의 두 벌이 아이에게 어떻게 섞여 전해지고 바뀜이 무엇을 낳는지를, 「진화란 무엇인가 — 한 뿌리에서 갈라진 가지, 지금도 돋는 새순」은 그 바뀜이 세대를 거치며 쌓인 결과를 다룹니다.
근거 논문
- "Biology 2e — 14.1 Historical Basis of Modern Understanding" (2018) — OpenStax Biology 2e 14.1 — 1860년대 미셔가 백혈구 핵에서 「뉴클레인」 분리, 1944년 에이버리·매클라우드·매카티가 DNA를 분해할 때만 세균 형질전환이 멈춤을 보임, 오스트리아 생화학자 에르빈 샤가프가 종마다 DNA 염기 구성을 조사.
- "Biology 2e — Chapter Summary" (2018) — OpenStax Biology 2e 14 — 허시·체이스 실험이 DNA가 유전 물질임을 입증, 샤가프의 A=T·C=G와 종마다 다른 비율, 나선 한 바퀴에 염기쌍 10개.
- "Biology 2e — 21.1 Viral Evolution, Morphology, and Classification" (2018) — OpenStax Biology 2e 21.1 — 거의 모든 생물은 DNA를 유전 물질로 쓰고, 바이러스는 DNA나 RNA를 쓴다.
- "Biology 2e — 3.5 Nucleic Acids" (2018) — OpenStax Biology 2e 3.5 — 뉴클레오타이드는 염기·당·인산, DNA 염기는 A·G·C·T, A·G는 고리 둘, C·T는 고리 하나.
- "Biology 2e — 14.2 DNA Structure and Sequencing" (2018) — OpenStax Biology 2e 14.2 — 왓슨·크릭이 프랭클린의 X선 자료로 이중나선 제안, A-T·G-C 짝(샤가프 규칙이 암시), 당·인산 뼈대는 바깥·염기는 안쪽, 퓨린-피리미딘 짝과 역평행 배열이 폭 2 nm를 균일하게, 세균 DNA는 꼬임으로 접힘.
- "Biology 2e — 14.3 Basics of DNA Replication" (2018) — OpenStax Biology 2e 14.3 — 짝 규칙으로 한 가닥에서 다른 가닥이 정해짐, 복제 방식 후보가 여럿, 메셀슨·스탈: 첫 세대 중간 무게 한 무리 → 둘째 세대 두 무리로 반보존만 남음.
- "Biology 2e — 14.4 DNA Replication in Prokaryotes" (2018) — OpenStax Biology 2e 14.4 — 대장균 460만 염기쌍을 약 42분에, 초당 약 1,000개, DNA 중합효소가 짝 염기를 하나씩 붙임.
- "Biology 2e — 14.5 DNA Replication in Eukaryotes" (2018) — OpenStax Biology 2e 14.5 — 사람 유전체 한 벌 30억 염기쌍·복제 때 60억, 복제 시작점 최대 10만, 초당 약 100개, 히스톤을 떼었다 다시 감아 느림, 기본 단계는 원핵생물과 같음.
- "Extrinsic proofreading." (2022) — PMID 35850061 — 핵 DNA 복제의 높은 정확성은 맞는 염기 선택·교정·불일치 수선의 세 과정에서 나옴.
- "Human DNA Mutations and their Impact on Genetic Disorders." (2024) — PMID 37936448 — 복제 정확성에 교정·손상 수선 유전자 수백 개 관여, 사람 세포는 평생 DNA 변화를 얻을 수 있고 일부는 세포 분열 때 복제 중 생김.
- "Basic Epigenetic Mechanisms." (2025) — PMID 39820859 — 사람 핵 DNA 2 m가 지름 5~15 μm 핵에, 23쌍 46개 염색체, 뇌 세포 종류 3,000가지 이상, DNA 서열 변화 없는 유전자 기능 변화가 세포 종류별 발현 무늬를 만듦.
- "Chromosome structures." (1992) — PMID 1364580 — 염색체마다 긴 DNA 분자 하나, 단백질과의 상호작용으로 약 1만 배 압축, 히스톤 「실패」에 감긴 뉴클레오솜 → 30 nm 섬유 → 고리 도메인.
- "Biology 2e — 10.1 Cell Division" (2018) — OpenStax Biology 2e 10.1 — 사람 체세포 염색체 46개, 부모에게서 한 벌씩 받은 상동염색체 23쌍.
- "Biology 2e — 4.3 Eukaryotic Cells" (2018) — OpenStax Biology 2e 4.3 — 원핵생물은 고리 염색체 하나, 진핵생물은 종마다 정해진 수의 막대 염색체(사람 46·초파리 8), 염색체는 분열 준비 때만 또렷이 보임.
- "Biology 2e — 10.2 The Cell Cycle" (2018) — OpenStax Biology 2e 10.2 — 복제된 DNA 두 벌은 붙은 채로 있다가 갈라져 유전적으로 같은 두 딸세포로.
- "Understanding biochemistry: structure and function of nucleic acids." (2019) — PMID 31652314 — DNA·RNA는 유전 정보를 지니고 세포가 그것을 읽어 RNA와 단백질을 만듦, 이중나선 구조가 정보 복제를 가능하게 함.
- "The status of the human gene catalogue." (2023) — PMID 37794265 — 2001년 초안 이후 유전자 목록 작업, 단백질 유전자는 2만 개 미만으로 추정, 비암호화 RNA 유전자 보고는 급증했으나 대부분 기능 불분명.
- "What is a gene, post-ENCODE? History and updated definition." (2007) — PMID 17567988 — 멘델·모건의 추상 단위에서 서열의 ORF까지 유전자 정의의 변천, ENCODE가 개념에 도전, 「겹칠 수 있는 기능 산물을 만드는 서열들의 합집합」으로 갱신 제안.
- "Non-coding transcript variants of protein-coding genes - what are they good for?" (2018) — PMID 30146915 — 사람 단백질 유전자 수는 훨씬 단순한 진핵생물보다 크게 많지 않음, 단백질 유전자가 비암호화 RNA 형태도 내 코딩/비코딩의 엄격한 구분을 무너뜨림.
- "Beyond the Human Genome Project: The Age of Complete Human Genome Sequences and Pangenome References." (2024) — PMID 38663087 — 표준 서열은 오래 불완전·다양성 결여, T2T의 빈틈 없는 서열이 동원체·말단소체 등을 해결, 범유전체가 집단 간 다양성을 담음.
- "The complete sequence of a human genome." (2022) — PMID 35357919 — 2000년 첫 공개 이후 남은 8%를 채워, Y를 뺀 모든 염색체를 빈틈 없이 이은 30억 5,500만 염기쌍 사람 유전체 서열(T2T-CHM13).
- "An expanding universe of the non-coding genome in cancer biology." (2014) — PMID 24747961 — 비암호화 유전체가 사람 유전체의 98% 이상.
- "The bright side of dark matter: lncRNAs in cancer." (2016) — PMID 27479746 — 비암호화 전사가 「암흑 물질」·전사 잡음이라는 우려가 있었으나 일부는 기능이 있음.
- "Roles of transposable elements in the regulation of mammalian transcription." (2022) — PMID 35228718 — 전이인자는 포유류 유전체의 약 절반, 옮겨 다니는 능력을 잃은 뒤에도 인핸서·프로모터를 제공하고 새 조절 유전자를 낳음.
- "Retrotransposon renaissance in early embryos." (2024) — PMID 37949723 — 레트로트랜스포존은 기생체로 치부됐으나 초기 배아의 접합자 유전체 활성화·세포 운명 결정에 관여.
- "Long noncoding RNAs: functional surprises from the RNA world." (2009) — PMID 19571179 — 긴 비암호화 RNA 다수가 세포 종류별 발현·세포 내 위치·질병 연관을 보여 잡음으로 보기 어려움.
- "An Emerging Role for Enhancer RNAs in Brain Disorders." (2024) — PMID 38546891 — 인핸서는 비암호화 DNA 요소로 먼 거리에서 유전자 발현 변화를 이끔.
- "Protein-coding potential of non-canonical open reading frames in human transcriptome." (2023) — PMID 37897910 — 비암호화 영역의 작은 ORF에서 단백질이 만들어짐, 얼마나 많고 얼마만큼이 기능적인지는 미지.