Paperis 아티클
셰익스피어 — 낱말을 가장 많이 알았던 사람이었나
셰익스피어가 작품에 쓴 서로 다른 낱말은 31,534개로 세어졌고, 1976년 두 통계학자는 생물학에서 종 수를 가늠하던 통계 모형을 빌려, 그 모형들이 그가 적어도 3만 5천 개의 낱말을 더 알았다고 가정하는 것과 같다고 결론지었다. 2011년 연구에 따르면 그의 전체 어휘는 실제로 크지만, 동시대 극작가와 희곡 한 편씩 맞대면 무리 안에 들어온다. 「그가 지은 낱말」의 목록은 사전이 옛 문헌을 더 뒤질수록 줄어 왔다. 숫자 셋이 각각 무엇을 쟀는지 따라간다.
셰익스피어 — 낱말을 가장 많이 알았던 사람이었나
3만 1천 개라는 숫자
잉글랜드 극작가이자 시인 윌리엄 셰익스피어는 1564년 스트랫퍼드어폰에이번에서 태어나 1616년에 세상을 떠났습니다. 그는 1590년대부터 1610년대 초까지 런던 극장에 희곡을 써 올렸고, 같은 시기 런던에서는 다른 극작가 여럿이 같은 무대를 두고 극을 썼습니다. 지난 백여 년 동안 셰익스피어 해설에서 빠지지 않은 생각 하나는 그가 유난히 큰 어휘를 가졌다는 것입니다 (DOI: 10.1353/shq.2011.0002). 그가 영어에 없던 낱말을 지어 보탰다는 이야기도 그 곁을 따라다녔고, 한동안 그의 발명으로 여겨진 낱말 목록도 있었습니다 (DOI: 10.4324/9781315303079-5).
마틴 드루샤웃, 셰익스피어 초상 동판(1623년 첫 2절판) · 퍼블릭 도메인 · 위키미디어 커먼즈
이 생각에 숫자를 붙인 쪽은 통계학자들이었습니다. 1976년 통계 학술지 『바이오메트리카』에 실린 한 논문은 출발점을 이렇게 놓습니다. 셰익스피어가 쓴 서로 다른 낱말은 31,534개이고, 그중 14,376개는 딱 한 번, 4,343개는 두 번 나온다 (DOI: 10.1093/biomet/63.3.435). 여기서 「낱말 수」라는 말은 두 가지로 셀 수 있습니다. 서로 다른 낱말 수(word types)는 같은 낱말이 몇 번 나오든 한 번만 세어 얻는 낱말의 가짓수입니다. 전체 낱말 수(word tokens)는 같은 낱말이 다시 나올 때마다 빠짐없이 센 낱말의 개수입니다. 「the」가 작품 전체에 수천 번 나와도 서로 다른 낱말 수에는 하나만 보탭니다. 31,534는 앞의 셈이고, 1만 4천여 개는 그 가운데 작품 전체를 통틀어 한 번만 얼굴을 내민 낱말입니다.
숫자는 정확합니다. 이 글이 묻는 것은 그 숫자가 무엇을 말하느냐입니다. 셰익스피어의 머리에 든 낱말이 많았다는 뜻인지, 그가 남긴 원고가 많았다는 뜻인지, 그리고 「그가 지은 낱말」이라는 목록은 누가 어떻게 만든 것인지입니다.
종 수를 가늠하는 계산
표본에 잡힌 종을 보고 그 지역에 몇 종이 사는지, 또는 표본에 한 번도 안 잡힌 종이 몇이나 되는지 가늠하는 일은 생물학에서 자주 나오는 문제입니다. 그 계열의 출발점 하나는 1943년 통계학자 로널드 피셔가 연구자 윌리엄스가 모은 큰 나방·나비류 채집 자료에 이론 분포를 맞춘 작업이었고, 그 뒤 통계학자 굿과 툴민도 종들의 빈도에 관한 가정 위에서 모형을 세웠습니다. 다만 이 초기 작업들의 주목적이 전체 종 수를 추정하는 데 있지는 않았습니다 (DOI: 10.2307/2531385). 보지 못한 종 추정(unseen species estimation)은 각 종이 표본에 몇 번씩 잡혔는지의 기록만 가지고, 아직 한 번도 잡히지 않은 종이 몇이나 되는지 계산하는 통계 방법입니다.
1976년 논문의 두 저자, 통계학자 브래들리 에프런과 로널드 시스테드는 이 계산을 셰익스피어에게 옮겼습니다. 표본에 안 잡힌 종의 자리에 「셰익스피어가 알았지만 인쇄된 글에는 쓰지 않은 낱말」을 놓은 것입니다 (DOI: 10.2307/2531385). 낱말 하나가 종 하나이고, 작품에 한 번 나올 때마다 그 종이 한 번 잡힌 셈이며, 남은 작품 전체가 표본 하나입니다. 계산의 재료는 바로 앞 절의 숫자들, 한 번 나온 낱말 1만 4천여 개와 두 번 나온 낱말 4천여 개처럼 각각 몇 개인지 하는 빈도의 줄입니다 (DOI: 10.1093/biomet/63.3.435).
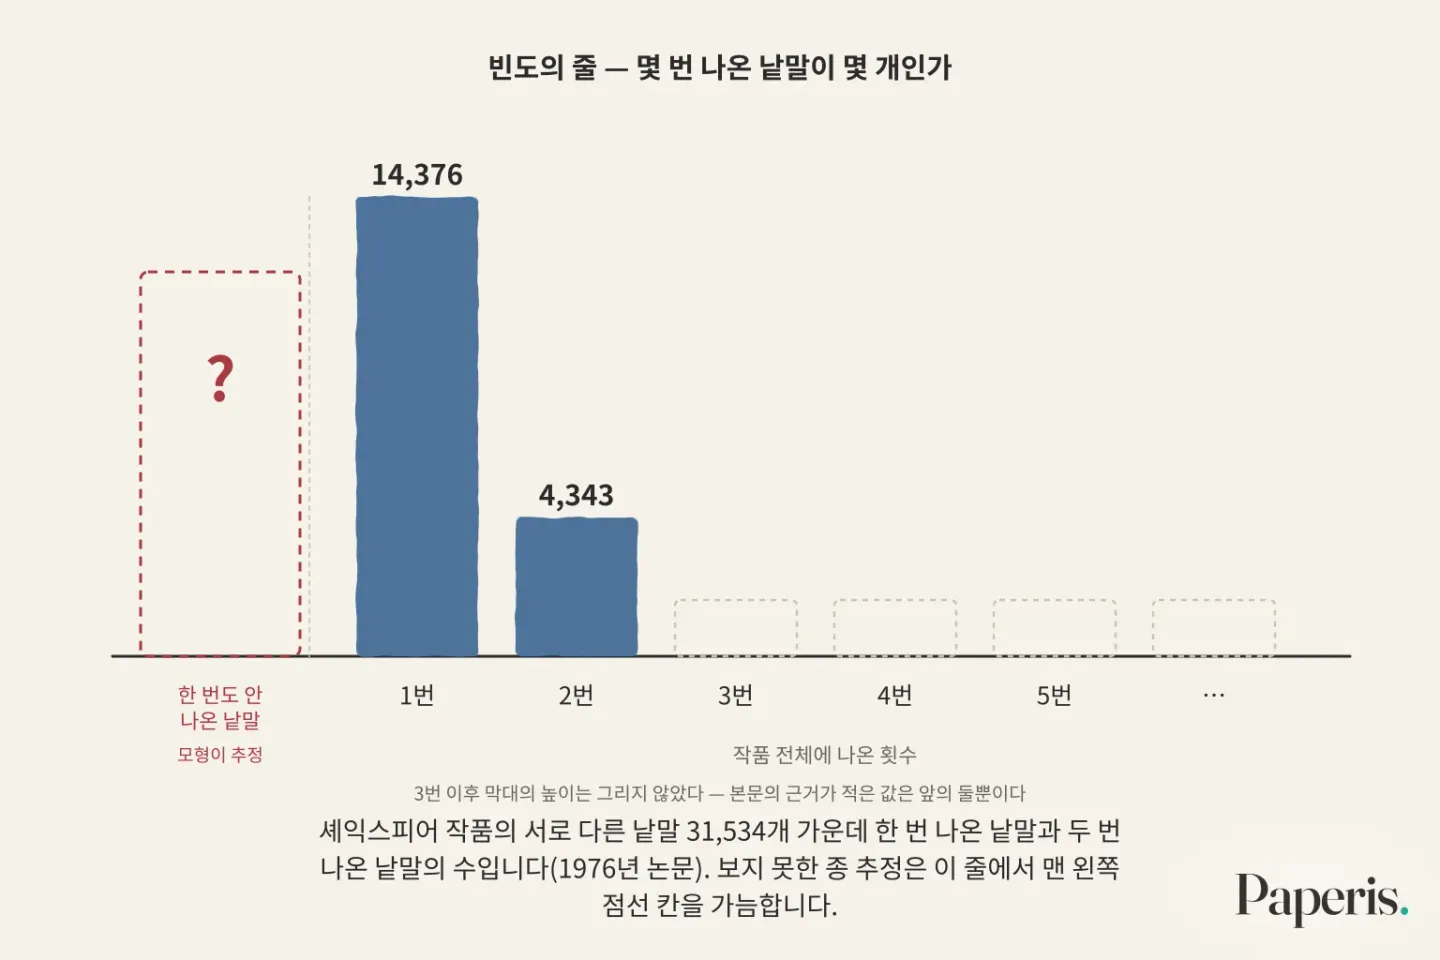
논문은 두 모형을 시험했습니다. 하나는 피셔의 모형이고, 다른 하나는 굿과 툴민의 모형이며, 저자들은 뒤의 것을 선형 계획법이라는 최적화 기법으로 보강했습니다. 결론 문장은 이렇습니다. 이 모형들은 셰익스피어가 적어도 3만 5천 개의 낱말을 더 알았다고 가정하는 것과 같다 (DOI: 10.1093/biomet/63.3.435). 「적어도」와 「가정하는 것과 같다」가 이 결론의 몸입니다. 3만 5천은 모형이 정한 가정 위에서 나온 「적어도」의 추정이고, 셰익스피어의 머릿속을 들여다보고 센 값은 어디에도 없습니다.
같은 자료 위에 다른 통계학자들도 모형을 세웠습니다. 1975년 한 연구는 글을 읽어 나가며 서로 다른 낱말 수가 어떻게 불어나는지를 확률 모형으로 만들고, 전체 낱말 수가 얼마일 때 서로 다른 낱말이 몇 개쯤 나올지를 작가의 어휘 크기별로 계산해 셰익스피어 희곡 세 편의 실제 수치에 대 보았습니다 (DOI: 10.1017/s0021900200047744). 1984년 연구는 종 수에 다른 꼴의 사전 분포를 놓는 베이즈 방법을 제안하며 그 분포의 모수를 고르는 지침을 따로 내놓았고 (DOI: 10.2307/2531385), 1987년 연구는 미리 정할 수 없는 상수를 다루려고 두 단계 절차를 만들어 나비와 곤충 표본, 유전자 변이, 셰익스피어와 제임스 조이스의 작품에 적용했습니다 (DOI: 10.1093/biomet/74.4.849). 이 두 연구의 초록에는 셰익스피어 어휘의 추정치가 나오지 않습니다. 모형마다 무엇을 가정할지 고르는 단계가 있고, 추정치는 그 선택을 거쳐 나온다는 점이 1984년과 1987년 초록에 공통으로 보입니다. 이 절에서 들고 갈 것은 하나입니다. 「셰익스피어가 안 낱말」은 직접 셀 수 없는 양이라, 통계학자들은 가정을 둔 모형으로 그 양을 가늠했고, 1976년 논문은 그 답을 「적어도」라는 하한으로 내놓았습니다.
같은 계산으로 시 한 편을 시험하다
셰익스피어의 것이라고 주장된, 그때까지 알려지지 않았던 아홉 연짜리 시 한 편이 1987년 같은 학술지의 논문에서 시험대에 올랐습니다 (DOI: 10.1093/biomet/74.3.445). 질문은 이 시의 낱말 쓰임이 셰익스피어가 남긴 작품 전체의 쓰임과 어울리느냐였고, 연구는 1976년 논문과 같은 계열인 비모수 경험적 베이즈 모형을 썼습니다. 계량 문체 분석은 글에 남은 낱말 쓰임의 버릇을 컴퓨터로 세어, 그 글을 누가 썼는지 가늠하는 방법입니다. 이 연구는 그 방법을 낱말 빈도의 통계로 한 것입니다.
비교 대상도 함께 놓였습니다. 셰익스피어와 같은 시대의 극작가 벤 존슨과 크리스토퍼 말로, 시인 존 던의 시, 그리고 셰익스피어가 쓴 것이 확실한 시 네 편입니다. 결과는 이렇게 적혀 있습니다. 대체로 보아, 이 시는 셰익스피어의 이전 쓰임과 꽤 잘 맞는다 (DOI: 10.1093/biomet/74.3.445). 「대체로 보아」와 「꽤 잘」은 저자들이 고른 한정어입니다. 쓰임이 맞는다는 것은 이 시가 셰익스피어의 글과 어긋나지 않는다는 판정이고, 그가 썼다는 증명과는 다른 무게입니다. 초록은 존슨·말로·던의 시가 같은 시험에서 어떤 결과를 냈는지는 적지 않습니다.
이 절에서 들고 갈 것은 이렇습니다. 낱말 빈도의 통계는 「이 글이 그 작가의 버릇과 맞는가」를 물을 수 있고, 그 대답은 「맞는다」나 「어긋난다」의 정도로 나옵니다.
희곡 한 편 대 한 편으로
지난 백여 년 동안 이어진 그 생각은 2011년 학술지 『셰익스피어 쿼털리』에 실린 한 연구에서 직접 셈에 올랐습니다. 초기 근대 영국 희곡의 전자 텍스트가 많이 쌓여 이제 그 주장을 셀 수 있게 됐다는 것이 출발점이었고, 셰익스피어의 희곡을 같은 시기 다른 극작가들의 희곡 여러 편과 나란히 놓았습니다 (DOI: 10.1353/shq.2011.0002). 초록에는 비교한 희곡이 몇 편인지는 나오지 않습니다.
결과는 넷입니다. 첫째, 셰익스피어의 어휘는 실제로 큽니다. 다만 그것은 오로지 그가 혼자 쓴 희곡으로 남은 작품이 동시대 작가들보다 많기 때문인 것으로 보입니다. 둘째, 희곡 한 편 대 한 편으로 보면, 그의 희곡이 쓰는 서로 다른 낱말 수는 다른 극작가들이 이루는 무늬 안에 잘 들어맞습니다. 셋째, 작품을 이어 갈 때마다 새로 들여오는 낱말 수도 마찬가지입니다. 넷째, 개별 낱말을 쓰는 비율이 평균에서 얼마나 벗어나는지를 재면, 셰익스피어는 동료들의 쓰임에 놀랄 만큼 가깝습니다 (DOI: 10.1353/shq.2011.0002). 셋째 결과의 「새로 들여오는 낱말」은 이 연구가 그의 작품을 차례로 따라가며 잰 값이고, 영어에 처음 생긴 낱말을 센 것과는 다른 양입니다.
첫째 결과가 이 글의 질문에 바로 답합니다. 작품 전체의 서로 다른 낱말 수가 크다는 사실은 남은 원고가 많다는 사실과 떼어 읽기 어렵습니다. 1975년 모형도 서로 다른 낱말 수의 기댓값을 전체 낱말 수에 따라 따로 계산했습니다 (DOI: 10.1017/s0021900200047744). 두 극작가가 희곡 한 편마다 쓰는 서로 다른 낱말의 수가 똑같다고 해 봅시다. 한 사람은 희곡을 몇 편 남겼고 다른 사람은 그 몇 배를 남겼다면, 작품 전체를 통틀어 센 서로 다른 낱말 수는 많이 남긴 쪽이 큽니다. 2011년 연구가 셰익스피어의 큰 어휘를 두고 「그래서인 것으로 보인다」고 내놓은 설명이 이 구조입니다.
2021년 한 논문은 『타이터스 앤드러니커스』 4막 1장을 셰익스피어 몫으로 본 앞선 두 연구의 자료가 두 후보 작가의 남은 작품 분량이 크게 달라 무효라고 주장하고, 분량을 맞추면 그 장면의 어휘가 동시대 극작가 조지 필 쪽을 가리킨다고 보며, 이 결론이 현재의 합의와 정면으로 어긋난다고 스스로 밝힙니다 (DOI: 10.1093/res/hgab032). 문체 계량으로 셰익스피어 극의 공동 집필을 가려 온 연구들은 「셰익스피어 저자 논쟁 — 에이번의 백조는 혼자였나」에서 따로 다룹니다.
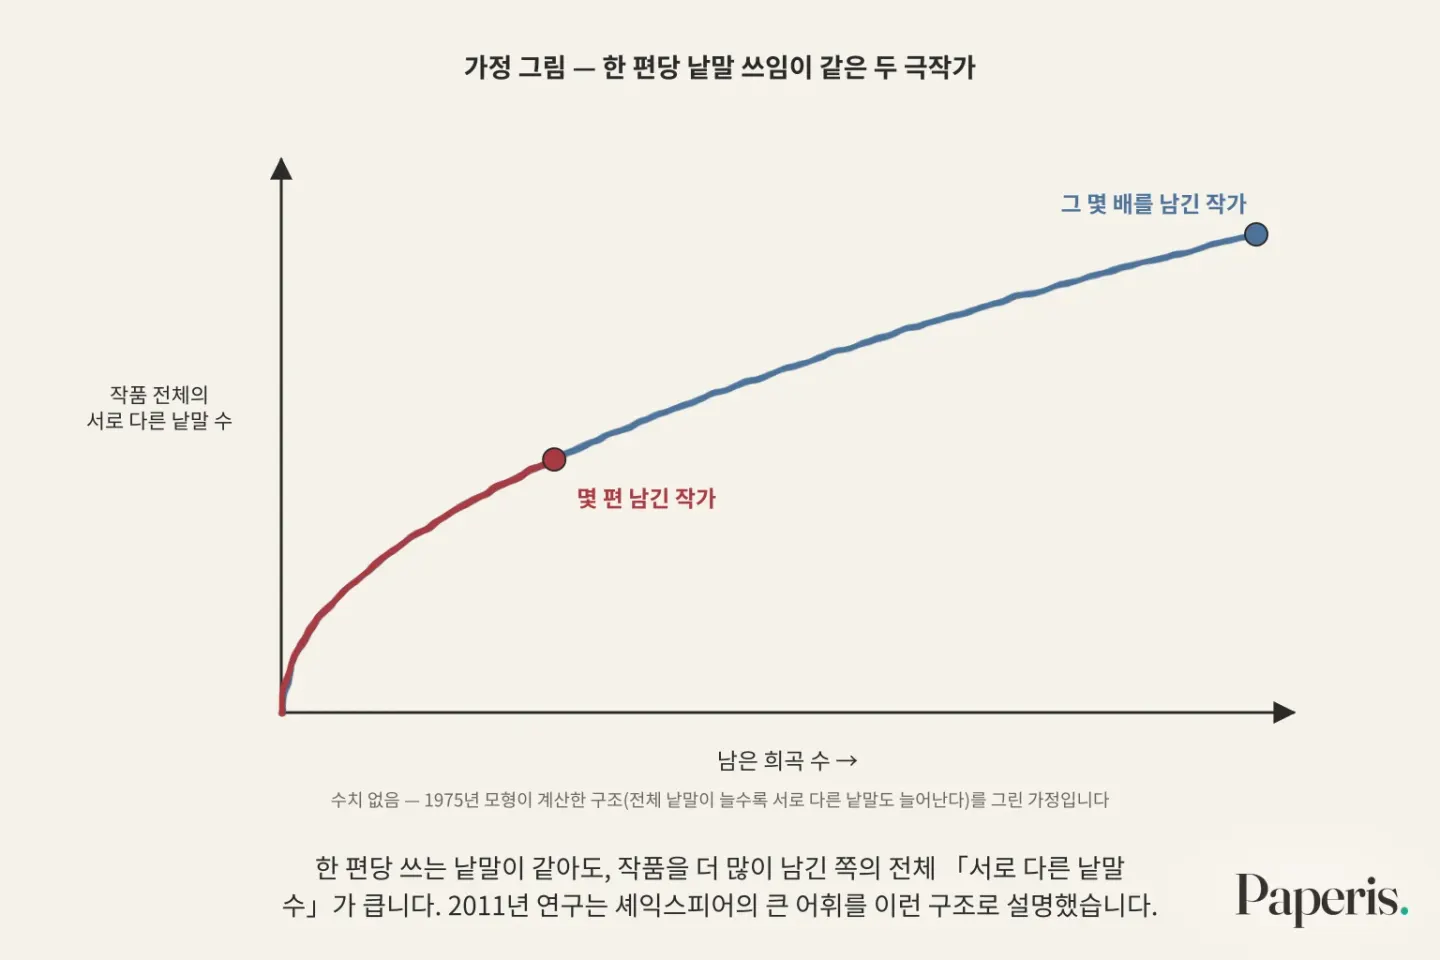
2011년 연구의 결론 문장은 그의 특별한 지위를 전제로 둡니다. 셰익스피어가 널리 인정받는 특별한 지위를 반영하는 수치 척도가 앞으로 어떤 것이 탐구되든, 어휘 크기와 낱말 쓰임 빈도의 증거는 셰익스피어를 동시대 작가들과 떨어진 자리가 아니라 그들과 함께 놓는다 (DOI: 10.1353/shq.2011.0002). 이 절에서 들고 갈 것은 이렇습니다. 낱말 수로 잰 셰익스피어는 무리 안에 있고, 그의 특별함을 잴 척도는 이 연구가 앞으로의 일로 남겨 두었습니다.
만든 낱말, 먼저 읽힌 낱말
『옥스퍼드 영어 사전』은 2000년부터 전면 개정 작업(3판)을 하며 모든 표제어의 쓰임 증거를 다시 조사했고, 가능한 곳마다 더 이른 쓰임을 새로 실었습니다 (DOI: 10.1093/notesj/gjad106). 이 사전에서 가장 이른 쓰임을 기록하는 일은 사전의 권위를 떠받치는 자랑거리로 여겨졌습니다 (DOI: 10.1093/notesj/gjad106). 첫 용례(first citation)는 사전이 어떤 낱말이 글에 쓰인 가장 이른 예로 싣는 인용문입니다. 신조어(neologism)는 그때까지 그 언어에 없던 낱말을 새로 지어 낸 것입니다. 어떤 낱말의 첫 용례가 셰익스피어의 글이면, 그 낱말은 그가 처음 쓴 것처럼, 더 나아가 그가 지은 신조어처럼 보입니다. 그런데 첫 용례는 편찬자들이 그때까지 찾아낸 가장 이른 예입니다.
앞당기기(antedating)는 사전에 실린 첫 용례보다 더 이른 쓰임을 찾아내 그 낱말의 첫 날짜를 앞으로 옮기는 일입니다. 2023년 『노츠 앤드 쿼리스』에 실린 짧은 논문은 사전 2판(1989)과 3판(2022)을 맞대어 이 앞당기기를 셌습니다. 2000년대 초 3판은 개정한 표제어의 38~44%에서 첫 날짜를 앞으로 옮겼고, 이 비율은 2년 평균으로 2013년 중반에 66%까지 올랐습니다. 저자는 이 상승의 큰 몫을 그 무렵 크게 늘어난 옛 문헌 데이터베이스(초기 영국 도서 온라인, 구글 북스 등)와 나아진 검색 방법으로 설명합니다 (DOI: 10.1093/notesj/gjad106).
셰익스피어도 이 흐름 안에 있습니다. 2판에서 첫 용례가 셰익스피어였던 표제어 가운데 3판이 첫 날짜를 앞당긴 경우는 46%였고(그의 다른 작품끼리 날짜가 바뀐 경우 등은 뺀 수), 논문은 이를 그의 시대로서는 평균 정도라고 적습니다 (DOI: 10.1093/notesj/gjad106). 첫 날짜가 바뀌는 이유에는 더 이른 쓰임의 발견 말고도 서지 조정이 있으며, 몇몇 셰익스피어 희곡의 집필 연대 조정이 그런 예입니다 (DOI: 10.1093/notesj/gjad106). 46%라는 수에서 읽을 것은 둘입니다. 셰익스피어를 첫 용례로 달던 표제어의 46%에서 날짜가 움직였고, 같은 일이 그 시대의 다른 글에도 비슷한 정도로 일어났습니다.
사전이 누구의 글을 더 촘촘히 읽었는지를 본 연구도 있습니다. 2013년 한 연구는 존 버니언을 예로, 사전 1판의 자원봉사 독자들이 덜 알려진 문학 작품에서는 그 언어와 내용에 대한 고정관념대로 인용을 골랐고, 그래서 그런 작품은 문학적 지위가 높은 작가보다 사전에 덜 실렸다고 주장합니다. 이 연구에 따르면 개정 작업은 셰익스피어의 특이한 용례를 지우지 않겠지만 덜 알려진 작가의 한 번 쓰고 만 낱말을 새로 넣을 가능성은 아주 낮아, 1판의 문학적 편견을 이어 간다는 것입니다 (DOI: 10.1353/dic.2013.0018). 2019년에 나온 한 책의 장은 같은 흐름을 셰익스피어 쪽에서 정리합니다. 옛 텍스트를 대량으로 볼 수 있게 되면서, 셰익스피어의 발명으로 여겨지던 낱말 가운데 더 이른 기원이 드러난 것이 많았다는 것입니다 (DOI: 10.4324/9781315303079-5).
「셰익스피어가 지은 낱말」의 목록은 사전이 옛 문헌을 더 넓게 읽을수록 줄어 왔습니다. 같은 2019년 장은 셰익스피어가 새 낱말을 만든 방법, 곧 낱말 합치기, 앞뒤에 말 붙이기, 한 품사의 낱말을 다른 품사로 바꿔 쓰기도 함께 다룹니다 (DOI: 10.4324/9781315303079-5). 그가 낱말을 지었다는 사실은 연구 대상으로 남아 있고, 줄어든 것은 그 목록의 길이입니다. 이 절에서 들고 갈 것은 이렇습니다. 「그가 지은 낱말 몇 개」라는 수를 들으면, 그것이 어느 판 사전이 그때까지 찾은 첫 용례의 수인지를 먼저 물어야 합니다.
아직 다투는 것
무엇을 한 낱말로 셀지부터 정해져 있지 않습니다. 1987년 학술지 『잉글리시 투데이』의 한 글은, 영어가 어휘가 특히 풍부하다고 말하려면 먼저 어떤 낱말을 세고 무엇을 한 낱말로 칠지를 알아야 한다고 적습니다 (DOI: 10.1017/s0266078400003023). 이 짧은 글은 영어 전체를 두고 한 말입니다. 셰익스피어의 경우에도, 2019년 장은 그가 실제로 부려 쓴 어휘의 크기를 어떻게 잴지에 방법상의 문제가 있다고 적고, 그의 어휘가 다른 몇몇 작가만큼 크지 않았다는 최근의 제안도 함께 소개합니다 (DOI: 10.4324/9781315303079-5). 「제안」이라는 낱말이 그 주장이 아직 놓인 자리를 보여 줍니다.
옛 낱말에 붙은 새 뜻은 찾기가 더 어렵습니다. 2012년 한 연구는 셰익스피어 희곡에서 낱말이 새 뜻으로 쓰인 세 사례(『맥베스』·『타이터스 앤드러니커스』·『줄리어스 시저』에서 하나씩)를 들며, 그런 새 뜻은 그 시대에 기록되지 않았고, 그 시기의 영어 단일어 사전이 남아 있지 않으며, 그 뜻이 곧 사라졌기 때문에 찾아내기 어렵다고 적습니다. 이 연구는 문학 텍스트 읽기에 기대는 한 이 문제가 한동안 풀리지 않으리라고 봅니다 (DOI: 10.1163/9789401207935_010). 새 낱말의 수만 세면 이런 쓰임은 셈에 들어오지 않습니다.
그렇다면 셰익스피어의 특별함은 어디서 잴까. 2011년 연구는 그 척도를 앞으로의 일로 남겼습니다 (DOI: 10.1353/shq.2011.0002). 한 책의 장(2018년 판)은 저자의 평가로 한 방향을 내놓습니다. 그 장의 저자는 앞선 장들에서 보인 어휘·구문·수사를 넓히는 기법이 셰익스피어의 발명과는 거리가 멀고, 그는 동시대 작가들보다 더 나은 예를 만들어 대개 극의 맥락에 맞춰 다듬었으며, 1590년대부터 극작가들이 함께 쓰던 문체들을 동시대 작가들이 상상하지도 표현하지도 못한 데까지 밀고 갔다고 봅니다 (DOI: 10.4324/9781315844862-14). 이것은 한 연구자의 읽기이고, 낱말을 세어 얻은 결과가 아닙니다.
그래서 무엇을 알게 됐나
셰익스피어의 어휘를 두고 오간 숫자는 셋이었고, 셋은 서로 다른 것을 쟀습니다. 31,534는 그가 남긴 작품에서 센 서로 다른 낱말 수입니다. 「적어도 3만 5천 개 더」는 생물학의 종 수 추정 계산을 빌린 모형들이, 그 가정 위에서 내놓은 하한입니다. 「그가 지은 낱말 몇 개」는 사전이 그때까지 찾아낸 첫 용례에 기대는 수이고, 옛 문헌을 더 많이 뒤질수록 그 가운데 적지 않은 수가 더 이른 쓰임에 자리를 내주었습니다.
동시대 극작가와 희곡 한 편씩 맞대면 그의 어휘는 무리 안에 들어오고, 전체 수가 큰 것은 남은 작품이 많은 것과 떼어 읽기 어렵습니다 (DOI: 10.1353/shq.2011.0002). 같은 연구는 그의 특별한 지위를 인정한 채, 그것을 보여 줄 정량 척도는 앞으로의 일로 남기고, 어휘 크기와 낱말 쓰임 빈도의 증거는 그를 동시대 작가들과 함께 놓는다고 맺었습니다. 셰익스피어가 작품에 쓴 서로 다른 낱말이 많다는 것은, 지금까지의 셈으로는 남은 원고가 많다는 것과 떼어 읽기 어렵습니다. 그가 실제로 알았던 낱말의 수는 이 글이 모은 근거 어디에서도 잰 적이 없고, 1976년 모형이 가정 위에서 내놓은 「적어도」라는 하한이 있을 뿐입니다. 「그가 지은 낱말」의 수는 다른 양이고, 사전이 옛 문헌을 얼마나 읽었느냐와 함께 움직여 왔습니다.
근거 논문
- "Shakespeare's Vocabulary: Myth and Reality" (2011) — DOI: 10.1353/shq.2011.0002 — 동시대 희곡과 비교하면 어휘는 크지만 남은 단독 희곡이 많아서로 보이고, 한 편 대 한 편으로는 서로 다른 낱말 수·새로 들여오는 낱말 수가 무리 안, 낱말 쓰임 비율은 동료에 가까움. 어휘 증거는 그를 동시대 작가와 함께 놓는다.
- "Estimating the Number of Unsen Species: How Many Words Did Shakespeare Know?" (1976) — DOI: 10.1093/biomet/63.3.435 — 서로 다른 낱말 31,534개(한 번 14,376, 두 번 4,343). 피셔·굿-툴민 모형, 셰익스피어가 적어도 3만 5천 개를 더 알았다고 가정하는 것과 같다.
- "Bayesian Estimation of the Number of Species" (1984) — DOI: 10.2307/2531385 — 종 수 추정은 생물학의 흔한 문제, 피셔(1943) 나비목 자료, 에프런·시스테드(1976)는 못 본 종을 셰익스피어가 알았지만 쓰지 않은 낱말로 봄. 절단 음이항 사전 분포와 모수 선택 지침.
- "Did Shakespeare Write a Newly-Discovered Poem?" (1987) — DOI: 10.1093/biomet/74.3.445 — 새로 알려진 아홉 연짜리 시의 낱말 쓰임을 비모수 경험적 베이즈로 검토, 존슨·말로·던과 확실한 셰익스피어 시 넷과 비교, 대체로 꽤 잘 맞음.
- "A Multinomial Bayesian Approach to the Estimation of Population and Vocabulary Size" (1987) — DOI: 10.1093/biomet/74.4.849 — 다항분포 베이즈로 칸 수·표본 포괄도 추정, 두 단계 절차, 나비·곤충·대립유전자·셰익스피어·조이스에 적용.
- "Stochastic Models for Type Counts in a Literary Text" (1975) — DOI: 10.1017/s0021900200047744 — 서로 다른 낱말 수의 마르코프 연쇄 모형, 전체 낱말 수와 어휘 크기별 기댓값을 셰익스피어 희곡 세 편으로 시험.
- "The Case for Peele's Authorship of Titus Andronicus 4.1" (2021) — DOI: 10.1093/res/hgab032 — 분량 불균형이 앞선 연구의 자료를 무효화, 분량을 맞추면 4막 1장 어휘는 필 쪽(합의와 반대라고 스스로 밝힘), 수치·질적 방법 통합 필요.
- "Antedating (in) the Oxford English Dictionary" (2023) — DOI: 10.1093/notesj/gjad106 — OED3 앞당기기 비율 38~44% → 66%, 옛 문헌 데이터베이스 영향, 셰익스피어 첫 인용 표제어 46% 앞당김(그 시대 평균 수준), 서지 조정도 원인.
- "Using Dictionary Evidence to Evaluate Authors' Lexis: John Bunyan and the Oxford English Dictionary" (2013) — DOI: 10.1353/dic.2013.0018 — OED1 독자들이 고정관념대로 인용해 덜 알려진 작가는 덜 실림, 개정은 셰익스피어 특이 용례를 지우지 않고 문학적 편견을 잇는다.
- "From oxcart to computer: Lexical studies" (2019) — DOI: 10.4324/9781315303079-5 — 실제 어휘 크기 측정의 방법 문제, 더 크지 않았다는 최근 제안, 셰익스피어 발명으로 여겨진 낱말의 더 이른 기원, 합성·접사·품사 전환 같은 조어 방법.
- "How many words?" (1987) — DOI: 10.1017/s0266078400003023 — 어휘가 풍부하다고 말하려면 무엇을 세고 무엇을 한 낱말로 칠지 알아야 한다.
- "Semantic drift in Shakespeare, and Early Modern English full-text corpora" (2012) — DOI: 10.1163/9789401207935_010 — 셰익스피어 희곡의 새 뜻 세 사례, 기록·당대 단일어 사전 부재·빠른 소멸로 찾기 어렵다.
- "Register and style" (2018) — DOI: 10.4324/9781315844862-14 — 어휘·구문·수사 확장 기법은 셰익스피어의 발명이 아니며 그는 더 나은 예를 맥락에 맞춰 만들고 동시대 문체를 더 멀리 밀고 갔다는 저자 평가.