Paperis 아티클
학습 — 먼저 울리는 소리, 뒤에 남는 맛
신호를 읽고, 결과를 겪고, 남을 보며 배우는 세 갈래 — 그리고 사람을 조건 반사 기계로만 볼 수 없는 이유
학습 — 먼저 울리는 소리, 뒤에 남는 맛
행주부터 찾는 손
주전자가 끓으며 뚜껑을 달그락거리면, 사람들은 손잡이를 잡기 전에 행주부터 찾습니다. 처음부터 그랬던 사람은 없습니다. 맨손으로 한 번 잡았다가 깜짝 놀라 손을 뗀 기억이 어딘가에 있습니다.
그때 손이 떨어진 것은 누가 가르쳐 준 일이 아닙니다. 뜨거운 것에 닿으면 생각보다 손이 먼저 물러납니다. 그다음부터 생긴 변화, 곧 달그락 소리만 들어도 행주로 손이 가는 것은 겪어서 생긴 것입니다.
이 글은 그 변화가 어떻게 생기는지를 두 가지로 따라갑니다. 하나는 무언가가 오기 전에 먼저 울리는 소리이고, 다른 하나는 내가 한 일 뒤에 남는 맛입니다. 사람과 동물은 이 둘을 읽으며 행동을 고쳐 나갑니다.
배우지 않아도 되는 것
앞에서 저절로 물러난 그 손이 반사입니다. 반사(reflex)는 특정 자극에 몸의 한 부분이 자동으로 반응하는, 타고난 반응입니다. 이런 반응은 척수처럼 신경계의 아래쪽 중추가 맡습니다 (OpenStax Psychology 2e 6.1). 타고난 것 가운데에는 몸 전체가 움직이는 더 복잡한 행동의 틀도 있어서, 이것을 본능이라고 부릅니다 (OpenStax Psychology 2e 6.1).
그럼 주전자 소리에 행주를 찾는 손은 어디서 왔을까요? 한 생애 안에서 겪은 일이 남긴 것입니다. 학습(learning)은 경험 때문에 생기는, 비교적 오래가는 행동이나 지식의 변화입니다. 한 번 덴 뒤 몇 해가 지나도 행주를 찾는 손이 그 변화입니다.
학습은 흔히 세 갈래로 나눕니다 (OpenStax Psychology 2e 6.1). 함께 일어나는 두 일을 잇는 것, 내 행동과 그 결과를 잇는 것, 남이 하는 것을 보고 배우는 것입니다.
먼저 울리는 소리
개는 먹이가 입에 들어오면 침을 흘립니다. 러시아의 생리학자 이반 파블로프는 개의 소화를 연구하면서 그 침이 얼마나 나오는지를 쟀고 (OpenStax Psychology 2e 6.2), 그러다 이상한 점을 보았습니다. 개들이 먹이를 입에 넣기도 전에, 먹이를 가져오던 실험 조수의 발소리만 듣고도 침을 흘렸습니다 (OpenStax Psychology 2e 6.2). 발소리는 이 글의 그림으로 치면 먹이보다 먼저 울리는 소리였습니다.
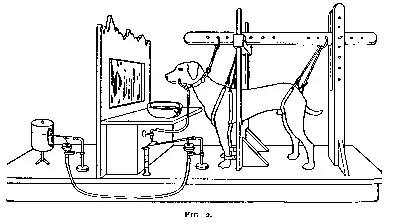
파블로프의 침 분비 측정 장치 · Yerkes & Morgulis, Psychological Bulletin, 1909 · 위키미디어 커먼즈(퍼블릭 도메인)
파블로프는 이것을 실험으로 옮겼습니다. 침과 상관없던 소리를 들려주고 곧바로 먹이를 주기를 되풀이하자, 개는 나중에 소리만 듣고도 침을 흘렸습니다 (OpenStax Psychology 2e 6.2). 고전적 조건화(classical conditioning)는 원래 별 뜻 없던 신호가 어떤 일과 거듭 짝지어지면서, 그 일이 일으키던 반응을 신호만으로도 부르게 되는 학습입니다.
조건 자극(conditioned stimulus)은 이렇게 짝을 거쳐 반응을 부르게 된 신호입니다. 파블로프의 개에게는 소리가 조건 자극이고, 이 글의 그림으로는 먼저 울리는 소리가 조건 자극입니다. 조건 반응(conditioned response)은 조건 자극이 부르는, 배워서 생긴 반응입니다. 소리에 흘리는 침이 조건 반응입니다.
짝은 아무렇게나 맺히지 않습니다. 신호와 그 일 사이가 벌어지면 짝이 잘 맺히지 않아서, 대개는 몇 초처럼 짧은 간격이 필요합니다 (OpenStax Psychology 2e 6.2). 맛은 예외입니다. 여기서 맛은 이 글의 그림과 달리 먼저 오는 신호 쪽입니다. 어떤 음식을 먹고 몇 시간 뒤에 크게 앓으면, 짝이 거듭되지 않고 한 번만으로도 그 맛이 싫어질 수 있습니다 (OpenStax Psychology 2e 6.2). 쥐 실험에서는 맛과 배앓이의 짝은 배웠지만, 빛이나 소리와 배앓이의 짝은 배우지 못했습니다 (OpenStax Psychology 2e 6.2). 적어도 쥐에게는 몸이 미리 기울어 있는 짝이 따로 있다는 뜻입니다.
짝의 세기는 신호가 그 일을 얼마나 믿을 만하게 알려 주는지에도 달려 있습니다 (OpenStax Psychology 2e 6.2). 그래서 먼저 울리는 소리는 단순히 앞에 오는 소리에 그치지 않고, 무엇이 올지 알려 주는 예고가 됩니다. 이 학습이 실험실의 침 이야기에 머물지 않는다는 주장도 있습니다. 한 연구자는 검토 논문에서 고전적 조건화를 먹이·짝·포식자·독처럼 생물에게 중요한 대상을 알아보고 그에 맞게 곧바로 움직이게 하는, 일상 곳곳의 장치로 다시 정의하자고 제안합니다 (PMID 42140477).
소리가 빈말이 될 때
소리를 들려주고도 먹이를 주지 않기를 되풀이하면, 침은 점점 줄다가 멈춥니다 (OpenStax Psychology 2e 6.2). 소거(extinction)는 조건 자극만 오고 뒤따르던 일이 더는 오지 않을 때, 조건 반응이 점점 약해지는 것입니다.
줄어든 반응이 지워진 것은 아닙니다. 소거된 개도 몇 시간 쉰 뒤에 소리를 다시 들으면 침을 흘렸습니다 (OpenStax Psychology 2e 6.2). 자발적 회복(spontaneous recovery)은 소거된 조건 반응이 쉬는 시간이 지난 뒤 다시 나타나는 것입니다. 이 현상은 조건화에서 가장 기본적인 현상 가운데 하나이지만, 무엇이 그 크기를 정하는지에 대한 연구 결과는 많지 않고 엇갈리며, 원인도 하나가 아닌 것으로 보입니다 (PMID 15466300).
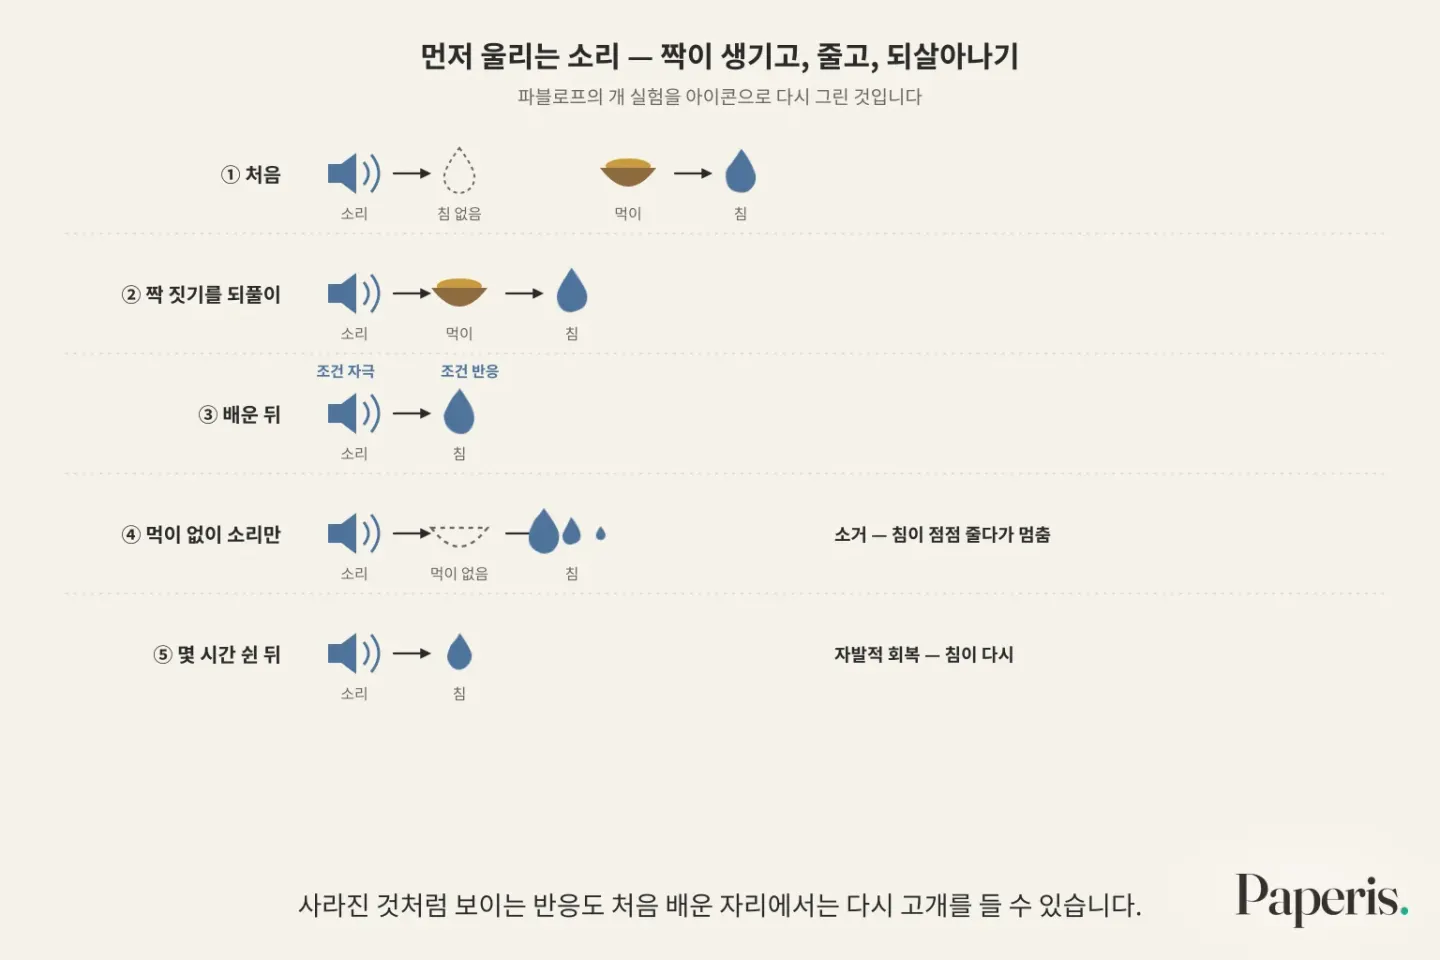
되살아나는 까닭의 하나는 소거가 처음 배운 것을 거의 그대로 둔다는 데 있습니다. 소거는 원래의 짝을 지우기보다, 「이제 이 소리 뒤에는 아무것도 오지 않는다」는 새 학습을 그 위에 얹는 일이고, 이 새 학습은 주로 그것을 배운 장소에서 힘을 씁니다 (PMID 32970967). 그래서 장소가 바뀌면 옛 반응이 돌아오기 쉽습니다. 사람의 공포 조건화 연구들을 모아 다시 분석한 결과, 처음 배운 장소로 돌아가 시험할 때 공포가 가장 뚜렷하게 되살아났고, 여러 장소에서 소거하면 덜 되살아났습니다 (PMID 38431150). 사라진 것처럼 보이는 반응도 처음 배운 자리에서는 다시 고개를 들 수 있습니다.
반응은 닮은 것으로도 번집니다. 자극 일반화(stimulus generalization)는 조건 자극과 닮은 자극에도 조건 반응이 나타나는 것입니다. 더 닮을수록 더 잘 번지고, 닮았어도 뒤따르는 일이 다르면 둘을 가려서 반응하게 됩니다 (OpenStax Psychology 2e 6.2). 번지는 성질은 쓸모가 있지만 지나칠 수 있습니다. 공포가 실제 위협보다 크거나, 너무 넓게 번지거나, 위험이 사라진 뒤에도 남거나, 지나친 피하기로 이어질 때 불안 문제로 이어질 수 있다는 것이 공포 조건화 연구자들의 관점입니다 (PMID 36811021).
흰쥐와 아기 한 명
이 원리를 사람의 감정(emotion)에 대 본 실험으로 자주 꼽히는 것이 1920년 미국 존스홉킨스 대학교의 심리학자 존 왓슨과 대학원생 로절리 레이너의 실험입니다 (OpenStax Psychology 2e 6.2). 「꼬마 앨버트」라는 별명이 붙은 아기는 처음에 흰쥐를 겁내지 않았습니다. 아기가 쥐를 만질 때마다 머리 뒤에서 쇠막대를 망치로 쳐 큰 소리를 내자, 아기는 쥐만 봐도 겁을 내게 됐고 며칠 뒤에는 다른 털 달린 것들까지 무서워했습니다 (OpenStax Psychology 2e 6.2).
이 실험은 감정도 조건화로 생길 수 있다는 예로 널리 인용됩니다. 그러나 대상은 아기 한 명이었고, 그 아이가 자라서 공포증을 겪었다는 증거는 없으며, 오늘의 기준으로는 비윤리적인 실험입니다 (OpenStax Psychology 2e 6.2). 아기 한 명의 반응만으로 「사람의 공포는 이렇게 생긴다」는 일반 법칙을 세우기는 어렵습니다.
뒤에 남는 맛
이제 순서를 뒤집어, 내가 한 일 뒤에 무엇이 남는지를 봅니다. 심리학자 에드워드 손다이크는 만족스러운 결과가 따른 행동은 다시 나올 가능성이 커지고, 불쾌한 결과가 따른 행동은 그 가능성이 작아진다고 정리했습니다 (OpenStax Psychology 2e 6.3). 미국 심리학자 B. F. 스키너는 이 생각을 바탕으로, 쥐가 레버를 누르거나 비둘기가 원판을 쪼면 먹이가 나오는 상자를 만들어 행동이 결과에 따라 어떻게 바뀌는지를 쟀습니다 (OpenStax Psychology 2e 6.3).
조작적 조건화(operant conditioning)는 어떤 행동과 그 뒤에 따라오는 결과를 이어서, 결과에 따라 그 행동이 늘거나 줄어드는 학습입니다. 스키너는 고전적 조건화가 이미 있던 반사만 새 신호에 붙일 뿐 새로운 행동이 어떻게 생기는지는 설명하지 못한다고 보았고, 그 빈자리를 행동의 결과로 채웠습니다 (OpenStax Psychology 2e 6.3).
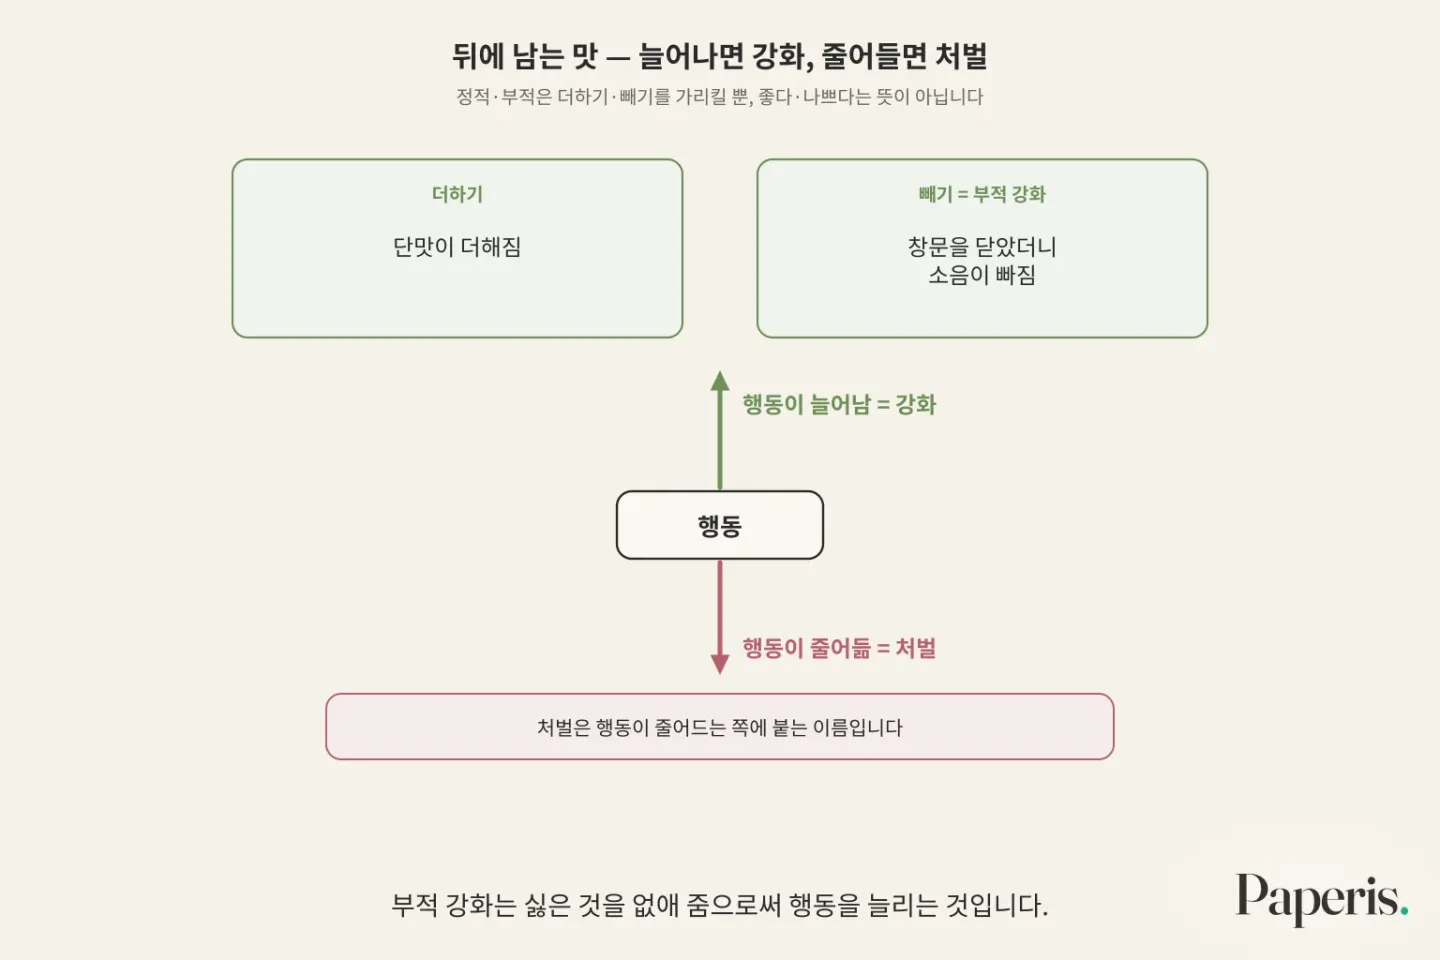
결과는 두 방향으로 작용합니다. 강화(reinforcement)는 행동 뒤에 따라오는 결과로 그 행동이 늘어나게 하는 것입니다. 처벌(punishment)은 행동 뒤에 따라오는 결과로 그 행동이 줄어들게 하는 것입니다.
창밖 공사 소음에 창문을 닫았더니 조용해졌다면, 시끄러울 때 창문을 닫는 행동이 늘어납니다. 행동이 늘었으니 이것도 강화입니다. 다만 이번에는 무언가가 주어진 것이 없고 소음이 빠졌을 뿐이라, 이런 경우에 「부적」이라는 말이 붙습니다. 이 분야에서 정적과 부적은 더하기와 빼기를 가리킬 뿐, 좋다 나쁘다는 뜻을 담지 않습니다 (OpenStax Psychology 2e 6.3). 부적 강화(negative reinforcement)는 싫은 것을 없애 줌으로써 행동을 늘리는 것입니다. 「부적」이라는 이름은 벌처럼 들려도, 창문을 닫는 행동은 오히려 늘었으니 이 장면은 벌과 반대쪽에 있습니다. 처벌은 행동이 줄어드는 쪽에 붙는 이름입니다. 이 글의 그림으로는 단맛이 더해지는 것도, 쓴맛이 빠지는 것도 그 행동을 다시 하게 만드는 뒷맛입니다.
긴 동작은 기다린다고 한 번에 나오지 않고, 나오지 않은 행동에는 뒷맛을 붙일 수도 없습니다 (OpenStax Psychology 2e 6.3). 그래서 목표까지 가는 길을 잘게 나눕니다. 조형(shaping)은 목표 행동에 조금씩 더 가까워지는 단계마다 강화해서, 마침내 목표 행동에 이르게 하는 방법입니다.
언제 올지 모르는 맛
뒷맛이 매번 오지 않아도 행동이 이어지는 경우가 있습니다. 강화 계획(reinforcement schedule)은 행동 뒤에 강화를 언제, 몇 번 만에 줄지를 정한 규칙입니다. 가끔만 줄 때는 몇 번 했을 때 주는지와 시간이 얼마나 지났을 때 주는지, 그 수가 정해져 있는지와 매번 바뀌는지를 엮어 네 가지로 나눕니다 (OpenStax Psychology 2e 6.3). 그 가운데 몇 번 만에 나올지 매번 달라지는 계획이 행동을 가장 많이, 꾸준하게 끌어내고, 강화가 끊긴 뒤에도 가장 늦게 사라집니다 (OpenStax Psychology 2e 6.3). 매번 강화하는 쪽은 새 행동을 들이는 데는 가장 빠르지만 (OpenStax Psychology 2e 6.3), 강화가 끊긴 뒤에는 더 빨리 사라집니다 (PMID 37261748).
가끔만 강화된 반응이 매번 강화된 반응보다 늦게 사라지는 현상은 이 분야에서 가장 잘 알려진 현상 가운데 하나입니다 (PMID 37930638). 사람에게 신호를 보고 반응하는 과제를 가르친 실험에서도 가끔만 보상받은 쪽이 보상이 끊긴 뒤 더 천천히 멈췄습니다 (PMID 37261748). 다만 이 현상은 행동과 결과를 잇는 학습에서는 거의 어디서나 나타나지만, 신호와 일을 잇는 고전적 조건화에서는 나타났다 안 나타났다 합니다 (PMID 28649917). 신호 뒤에 먹이가 오는 쥐 실험에서도 먹이 없는 차례가 길게 이어지도록 훈련한 쪽에서만 나타났고, 저자는 강화가 올지 모른다는 불확실성을 핵심 요인의 하나로 꼽았습니다 (PMID 37930638).
전자 도박 기계 앞에 앉은 사람을 떠올려 보면 이 원리가 한자리에 모입니다. 문제 도박을 하는 사람들 가운데에는 전자 도박 기계를 하는 사람이 유난히 많은 것으로 보이고, 이런 기계에는 몇 번 만에 터질지 모르는 보상, 아깝게 빗나가는 결과, 건 돈보다 적게 땄는데도 이긴 것처럼 꾸미는 연출, 내가 결과를 조절할 수 있다는 착각이 들어 있습니다 (PMID 26116634). 그렇다고 이 설계 하나만으로 도박 문제가 생긴다고 보지는 않습니다. 같은 검토 논문은 도박 문제가 사람 쪽의 뇌와 성향의 취약성과 게임 쪽의 설계가 맞물려 생긴다고 봅니다 (PMID 26116634).
휴대폰 알림을 자꾸 들여다보는 것도 언제 새 소식이 올지 모른다는 점에서 구조가 닮았습니다. 다만 알림 확인을 이 틀로 직접 잰 연구는 이 글이 다룬 근거 안에 없어서, 닮았다는 데까지만 말할 수 있습니다.
쓴맛의 한계, 단맛의 한계
아이를 때리는 체벌은 일상에서 벌이라 부르는 것 가운데 지금도 논쟁이 큰 주제입니다 (PMID 27055181). 이런 연구는 아이들을 시간에 따라 따라가며 체벌과 이후의 결과가 함께 가는지를 재고, 그 연관에서 원인을 얼마나 읽어 낼 수 있는지가 늘 쟁점입니다 (PMID 29797703).
한쪽에서는 해롭다는 결과가 거듭 나왔습니다. 엉덩이 때리기만 따로 다룬 연구들을 모은 2016년 종합 분석은 아이 16만여 명의 자료에서, 엉덩이 때리기가 여러 나쁜 결과의 위험이 높아지는 것과 함께 간다고 보고했고, 그 크기가 신체 학대와 크게 다르지 않았습니다 (PMID 27055181). 저소득·중간소득 국가 92곳의 연구 189편을 모은 2025년 종합 분석도 체벌이 정신 건강 문제, 나빠진 부모-자녀 관계 같은 해로운 결과와 함께 간다고 보고했고, 이런 연관은 다른 비폭력 훈육 방법에서는 나타나지 않았고 체벌과 심리적 공격에서만 나타났습니다 (PMID 40325199). 2021년에 나온 49개 나라 3~4세 아이 13만여 명의 자료 분석에서는 체벌을 받은 아이가 발달이 제 궤도에 있을 가능성이 약 24% 낮았고, 어느 나라에서도 체벌이 좋은 발달 결과와 이어지지 않았습니다 (PMID 34298261). 이 연구의 저자들은 엉덩이 때리기를 포함한 모든 형태의 체벌이 어린아이의 발달에 해로울 가능성이 크다고 결론지었습니다 (PMID 34298261).
다른 쪽은 그 크기와 해석을 다르게 읽습니다. 처음 측정한 아이의 상태를 보정하면 연관이 아주 작아져, 체벌의 영향이 미미하다고 결론지은 종합 분석이 있습니다 (PMID 23274727). 같은 자료라도 보정 방법에 따라 작은 위험으로도, 작은 이득으로도 나온다는 분석도 있습니다 (PMID 29797703). 2005년의 한 종합 분석은 특정 조건에서만 쓴 엉덩이 때리기가 다른 훈육 방법 13가지 가운데 10가지보다 말 안 듣기나 반사회적 행동을 줄이는 쪽으로 나았고, 일상적인 체벌은 다른 방법과 비슷했으며, 지나치게 세거나 체벌을 주된 방법으로 쓸 때만 다른 방법보다 나빴다고 보고했습니다 (PMID 15898303). 여러 대규모 종합 분석에서 체벌은 나쁜 결과와 거듭 함께 나타났지만, 그 연관이 얼마나 큰 원인 효과인지와 가벼운 체벌까지 같은지에는 연구자들 사이에 다툼이 남아 있습니다.
단맛에도 한계가 있습니다. 128개 연구를 모은 종합 분석에서, 미리 약속하고 주는 물질적 보상은 사람들이 자유 시간에 그 일을 스스로 하는 정도를 대체로 떨어뜨렸고, 말로 하는 칭찬 같은 긍정적인 피드백은 오히려 높였습니다 (PMID 10589297). 저자들은 같은 물음을 다룬 앞선 종합 분석 네 편과 방법과 결과가 달랐다고 밝힙니다 (PMID 10589297). 물질적 보상의 이런 손해는 대학생보다 아이들에게서 더 크게 나타나는 경향이 있었습니다 (PMID 10589297). 보상이 행동을 늘리는 힘과 그 일을 스스로 하려는 마음은 따로 움직일 수 있다는 뜻입니다. 그 마음의 이야기는 「감정과 동기 — 바늘이 흔들리는 계기판, 그 바늘을 읽는 눈」이 이어 갑니다.
남의 접시를 보고
맛을 꼭 내 혀로 봐야 배우는 것은 아닙니다. 남이 겪는 것을 보고도 배울 수 있어서, 직접 겪어야 하는 앞의 두 갈래보다 배울 수 있는 범위가 넓습니다 (OpenStax Psychology 2e 6.1). 관찰 학습(observational learning)은 남이 하는 것을 보고 배워, 그 행동을 따라 하거나 하지 않게 되는 학습입니다.
이런 배움을 실험실로 옮긴 사례로 자주 꼽히는 것이 심리학자 앨버트 반두라가 보보 인형을 써서 한 실험들입니다. 그 가운데 하나에서 아이들은 어른이 커다란 풍선 인형을 거칠게 다루는 모습을 보았습니다. 그 어른이 벌받지 않는 장면을 본 아이들은 인형을 그대로 거칠게 다뤘고, 벌받는 장면까지 본 아이들은 덜 그랬습니다 (OpenStax Psychology 2e 6.4). 이 실험이 보여 준 것은 실험실에서 막 본 행동을 아이들이 인형에게 따라 했다는 것까지입니다.
같은 장면을 보고도 따라 하지 않는 아이가 있는 까닭을 반두라는 이렇게 설명했습니다. 애초에 눈여겨보지 않았거나, 본 것을 기억하지 못하거나, 몸으로 해낼 수 없으면 따라 하지 못하고, 내가 지켜본 그 사람이 겪은 뒷맛은 그 가운데 따라 하고 싶은 마음 쪽에 작용합니다 (OpenStax Psychology 2e 6.4). 남의 접시에 남은 맛이 내 숟가락을 움직입니다. 반두라는 바깥에서 주는 보상 없이도 이런 배움이 일어나는 만큼, 행동과 결과만으로는 다 풀 수 없고 마음속 상태를 함께 봐야 한다고 보았습니다 (OpenStax Psychology 2e 6.4).
생각이 학습에서 원인 노릇을 하는지를 다룬 반두라의 연구는, 생각과 행동을 함께 다루는 심리치료가 1970년대에 자리 잡는 데 큰 몫을 했습니다 (PMID 38548474).
맛이 없어도 그려지는 지도
행동주의 심리학자 에드워드 톨먼은 배고픈 쥐들을 먹이 없이 미로에서 돌아다니게 했습니다. 열 번쯤 그렇게 다닌 뒤 미로 끝에 먹이를 두자, 이 쥐들은 처음부터 먹이를 받으며 다닌 쥐들만큼 빨리 길을 찾았습니다 (OpenStax Psychology 2e 6.3). 잠재 학습(latent learning)은 이미 일어났지만, 드러낼 이유가 생길 때까지 행동으로는 보이지 않는 학습입니다. 톨먼은 쥐들이 먹이가 없는 동안에도 미로의 생김새를 머릿속 지도로 그려 두었다고 해석했습니다 (OpenStax Psychology 2e 6.3).
이 실험은 흔히 「보상 없이도 배운다」는 증거로 소개되지만, 그 해석에는 단서가 붙습니다. 1948~2004년에 나온 입문 교과서 48권을 살펴본 한 검토는, 이 실험이 학습에 강화가 필요 없음을 의심의 여지 없이 보여 줬다거나 머릿속 지도만이 유일한 설명이라고 쓰는 것은 오류라고 지적합니다 (PMID 22478463). 같은 검토는 스키너를 「강화가 있어야만 학습이 된다」고 주장한 사람으로 그리는 것도 잘못이라고 봅니다 (PMID 22478463).
그렇다면 보상이 없을 때 무엇이 이런 학습을 움직이는지에 대해, 호기심이 그 동력이라는 제안이 있습니다 (PMID 33842677). 당장 쓸모가 없어 보여도 주변을 알아 두려는 마음이 그 환경의 구조를 담은 지도를 만들고, 그 지도가 나중에 유연한 행동을 이끈다는 것입니다 (PMID 33842677). 뒤에 맛이 남지 않아도 지도는 그려집니다.
기계로만 볼 수 없는 이유
여기까지만 보면 사람도 소리와 맛에 끌려다니는 기계처럼 보일 수 있습니다. 근거는 두 방향을 함께 보여 줍니다.
조건화는 사람에게서 분명히 일어납니다. 사람의 공포 조건화는 지난 수십 년 동안 공포의 심리와 뇌의 기전을 이해하는 주된 실험 도구였습니다 (PMID 36811021). 한 이론 모형은, 늘 같은 장소에서 되풀이한 행동이 그 장소와 짝을 이루어 습관이 되면 그 장소를 알아차리는 것만으로 목표를 거치지 않고 행동이 나온다고 설명합니다 (PMID 17907866).
동시에 사람은 말 한마디로 그 짝을 바꿉니다. 사진 뒤에 불쾌한 자극이 오도록 공포를 가르친 실험에서, 「이제 그 자극은 오지 않는다」고 미리 알려 주자 뱀·거미 사진에 붙은 공포도, 겨눈 총 사진에 붙은 공포도 줄었고 둘 사이에 차이가 없었습니다 (PMID 31828815). 이 연구의 저자들은 뱀·거미에 공포가 잘 붙는 현상이 타고난 기울기보다 살면서 배운 사회·문화적 학습 쪽으로 설명된다는 근거라고 보았습니다 (PMID 31828815). 다른 실험에서는 뱀·거미 사진이 공포를 더 빨리 배우게 했지만, 말로 알려 주자 피부의 전기 반응이 곧바로 뒤집힌 것은 다른 사진을 본 사람들과 같았습니다 (PMID 29339561). 어떤 짝은 더 빨리 붙지만, 말로 들은 정보는 그 짝까지 바꿉니다.
사람이 짝을 알아차리지 못한 채 공포를 배운다는 근거도 단단하지 않습니다. 이 물음을 다룬 연구 41편을 검토한 종합 분석은, 대부분의 연구에 방법상 한계가 있었고 질이 높은 연구일수록 알아차리지 못한 채 배운다는 결론을 덜 냈다며, 그런 조건화를 뒷받침하는 설득력 있는 근거는 없다고 결론지었습니다 (PMID 31747553).
습관도 쇠사슬처럼 단단하지는 않습니다. 습관을 따로 가려내 살핀 연구들을 검토한 논문은, 습관이 목표에 따른 행동보다 더 오래가거나 한번 생기면 영구적이라는 근거가 놀랄 만큼 적고 습관은 오히려 특정 장소에 더 묶여 있다고 봅니다 (PMID 38149526). 이 검토 논문은 습관의 쓰임이 행동을 강하게 만드는 데보다, 특정 장소에서 자동으로 힘들이지 않고 하게 하는 데 있을 수 있다고 봅니다 (PMID 38149526).
교과서도 같은 흐름을 적습니다. 보고 배우는 학습은 짝을 잇는 학습 위에 사회적인 층과 생각의 층을 더하고, 행동주의 안에서도 생각의 몫은 갈수록 커졌습니다 (OpenStax Psychology 2e 6.1).
이 글의 소리와 맛 그림은 무엇과 무엇이 짝지어지는지를 보여 줄 뿐, 사람이 그 짝을 어떻게 해석하고 말 한마디로 고쳐 쓰는지는 보여 주지 못합니다. 사람의 학습은 조건화 위에 기대와 이해가 얹혀 움직이기 때문에, 「자극-반응 기계」로도 「조건화는 동물 이야기」로도 다 설명되지 않습니다.
어디를 더 볼까
배운 것이 머릿속에 어떻게 담기고 다시 꺼내지는지는 「기억의 세 단계 — 담고, 남기고, 꺼내기」가 다룹니다. 배움을 오래 남기는 공부 방법은 「인출 연습 — 꺼내 볼수록 남는다」와 「간격 효과 — 나눠서 할수록 오래 간다」에 있습니다.
고전 실험이 다시 재면 어떻게 되는지는 「심리학의 재현 위기 — 우리가 믿었던 발견들은 왜 흔들렸나」와 「사라지는 효과 — 교과서에 실렸던 발견들은 왜 다시 재면 작아지는가」가, 쥐·비둘기·아기 한 명에게서 얻은 결과를 누구에게까지 넓힐 수 있는지는 「누구를 재고 있었나 — 심리학이 "사람"이라고 말할 때의 그 사람」이 짚습니다. 보상에 대한 반응을 경제학의 눈으로 본 글은 「인센티브 — 사람은 값과 보상에 어떻게 반응하나」입니다.
이 시리즈의 다른 편들도 이어집니다. 보상과 스스로 하려는 마음의 관계는 「감정과 동기 — 바늘이 흔들리는 계기판, 그 바늘을 읽는 눈」이, 사람이 정보를 해석하고 판단하는 방식은 「생각과 판단 — 손에 익은 연장, 한쪽으로 나는 흠집」이, 남을 따라 하는 마음이 집단 속에서 어떻게 움직이는지는 「사회 속의 마음 — 양쪽에서 당기는 줄, 보이지 않는 쪽의 손」이 다룹니다.
근거 논문
- "Psychology 2e — 6.1 What Is Learning?" (2020) — OpenStax Psychology 2e 6.1 — 반사·본능은 타고난 행동이고 학습은 경험에서 생기는 비교적 오래가는 변화, 학습의 세 갈래와 관찰 학습이 넓히는 범위, 인지의 몫이 커진 흐름.
- "Psychology 2e — 6.2 Classical Conditioning" (2020) — OpenStax Psychology 2e 6.2 — 파블로프의 관찰과 실험, 짝의 시간 간격과 맛 혐오·생물학적 제약, 예측력, 소거·자발적 회복·일반화·변별, 왓슨·레이너의 꼬마 앨버트 실험과 그 한계.
- "Psychology 2e — 6.3 Operant Conditioning" (2020) — OpenStax Psychology 2e 6.3 — 효과의 법칙과 스키너 상자, 강화·처벌과 정적·부적의 뜻, 조형, 연속·부분 강화와 네 가지 강화 계획, 톨먼의 잠재 학습.
- "Psychology 2e — 6.4 Observational Learning (Modeling)" (2020) — OpenStax Psychology 2e 6.4 — 관찰 학습과 반두라의 네 조건, 모델이 받은 결과의 효과, 보보 인형 실험, 외부 강화 없는 학습과 마음속 상태.
- "Redefining Pavlovian conditioning." (2026) — PMID 42140477 — 고전적 조건화를 생물학적으로 중요한 대상을 알아보고 즉각 적응 행동을 내는 보편적 기전으로 재정의하자는 제안.
- "Spontaneous recovery." (2004) — PMID 15466300 — 자발적 회복은 조건화의 가장 기본적 현상이지만 결정 요인에 대한 실증 문헌은 적고 엇갈리며, 원인이 여럿일 것.
- "BEHAVIORAL AND NEUROBIOLOGICAL MECHANISMS OF PAVLOVIAN AND INSTRUMENTAL EXTINCTION LEARNING." (2021) — PMID 32970967 — 소거는 원래 학습의 삭제가 아니라 주로 학습된 맥락에서 표현되는 새 억제 학습.
- "Renewal in human fear conditioning: A systematic review and meta-analysis." (2024) — PMID 38431150 — 사람 공포 조건화에서 ABA 설계의 재발이 가장 강하고, 여러 맥락에서의 소거가 재발을 줄인다.
- "Understanding clinical fear and anxiety through the lens of human fear conditioning." (2023) — PMID 36811021 — 공포는 위협보다 크거나 넓게 일반화되거나 위험 뒤에도 남을 때 부적응이 되며, 공포 조건화가 주된 연구 도구였다.
- "The sequencing of trials during partial reinforcement affects subsequent extinction." (2024) — PMID 37930638 — 부분 강화 소거 효과는 연합 학습의 가장 잘 알려진 현상 가운데 하나이고, 쥐 실험에서 저자는 강화의 불확실성이 핵심 요인이라고 결론.
- "Partial reinforcement extinction and omission effects in the elimination and recovery of discriminated operant behavior." (2023) — PMID 37261748 — 사람의 조작적 행동에서도 부분 강화 뒤 소거가 느리고, 원래 맥락으로 돌아가면 반응이 되살아났다.
- "Partial reinforcement and conditioned taste aversion: No evidence for resistance to extinction." (2019) — PMID 28649917 — 부분 강화 소거 효과는 도구적 조건화에서는 거의 보편적이나 파블로프식 조건화에서는 일관되지 않다.
- "Games in the Brain: Neural Substrates of Gambling Addiction." (2016) — PMID 26116634 — 전자 도박 기계가 문제 도박자에 과대 대표되며 변동 비율 계획·니어미스·이긴 것처럼 꾸민 손실·통제 착각을 활용, 문제는 사람의 소인과 게임의 상호작용.
- "Improving Causal Inferences in Meta-analyses of Longitudinal Studies: Spanking as an Illustration." (2018) — PMID 29797703 — 종단 연구 메타분석의 인과 추론 문제, 엉덩이 때리기 효과가 보정 방법에 따라 작은 위험 또는 작은 이득.
- "Spanking and child outcomes: Old controversies and new meta-analyses." (2016) — PMID 27055181 — 16만여 명 자료에서 엉덩이 때리기는 해로운 결과의 위험 증가와 연관, 신체 학대와 효과크기가 크게 다르지 않음.
- "Physical punishment and lifelong outcomes in low‑ and middle‑income countries: a systematic review and multilevel meta-analysis." (2025) — PMID 40325199 — 92개 저·중소득 국가 189편에서 체벌은 해로운 결과와 연관, 다른 비폭력 훈육에서는 그렇지 않고 체벌과 심리적 공격에 특이적.
- "Corporal punishment and early childhood development in 49 low- and middle-income countries." (2021) — PMID 34298261 — 3~4세 13만여 명에서 체벌 노출 아동은 발달 정상 궤도일 가능성이 약 24% 낮고 어느 나라에서도 긍정적 결과와 무관, 저자는 모든 형태의 체벌이 해로울 가능성이 크다고 결론.
- "Spanking, corporal punishment and negative long-term outcomes: a meta-analytic review of longitudinal studies." (2013) — PMID 23274727 — 처음 상태를 통제한 편상관에서는 연관이 미미, 저자는 영향이 최소라고 결론하고 더 세밀한 논의를 권함.
- "Comparing child outcomes of physical punishment and alternative disciplinary tactics: a meta-analysis." (2005) — PMID 15898303 — 조건부 엉덩이 때리기가 13개 대안 중 10개보다 불순응·반사회 행동 감소에 유리, 지나치게 세거나 주로 쓰는 체벌만 불리.
- "A meta-analytic review of experiments examining the effects of extrinsic rewards on intrinsic motivation." (1999) — PMID 10589297 — 128개 연구에서 기대된 물질적 보상은 자유 선택 내재 동기를 낮추고 긍정적 피드백은 높였으며, 물질적 보상의 손해는 아이에게서 더 큰 경향.
- "The social-cognitive clinician: On the implications of social cognitive theory for psychotherapy and assessment." (2024) — PMID 38548474 — 반두라의 사회 학습에서 인지 과정의 인과적 역할 연구가 1970년대 인지행동치료 등장의 주요 요인.
- "Behaviorism, latent learning, and cognitive maps: needed revisions in introductory psychology textbooks." (2006) — PMID 22478463 — 입문 교과서 48권 검토, 잠재 학습 실험을 강화 불필요의 결정적 증거·인지 지도를 유일한 설명으로 쓰는 것과 스키너를 강화 필수론자로 그리는 것은 오류.
- "Latent learning, cognitive maps, and curiosity." (2021) — PMID 33842677 — 잠재 학습은 표준 강화로 움직이지 않으며 호기심이 이를 동기화해 인지 지도를 만들고 유연한 행동을 이끈다는 제안.
- "A new look at habits and the habit-goal interface." (2007) — PMID 17907866 — 습관은 반응과 수행 맥락의 연합이 서서히 쌓여 생기고, 형성 후엔 맥락 지각이 목표 없이 반응을 촉발.
- ""Prepared" fear or socio-cultural learning? Fear conditioned to guns, snakes, and spiders is eliminated by instructed extinction in a within-participant differential fear conditioning paradigm." (2020) — PMID 31828815 — 지시된 소거가 뱀·거미와 겨눈 총에 조건화된 공포를 차이 없이 줄였고, 저자는 「준비성」 효과의 사회·문화적 설명을 지지한다고 결론.
- "Prepared stimuli enhance aversive learning without weakening the impact of verbal instructions." (2018) — PMID 29339561 — 뱀·거미 자극은 학습 속도를 높였지만 지시에 따른 피부전도 반전은 두 집단에서 즉각적이었다.
- "A systematic review and meta-analysis of the evidence for unaware fear conditioning." (2020) — PMID 31747553 — 41편 검토, 대부분 방법상 한계·질 높을수록 무자각 결론 적음·출판 편향, 짝을 알아차리지 못한 공포 조건화의 설득력 있는 근거 없음.
- "Habit and persistence." (2024) — PMID 38149526 — 습관이 영구적이거나 더 끈질기다는 근거는 적고 습관은 맥락에 더 특이적이며, 그 기능은 자동성과 효율일 수 있다.